
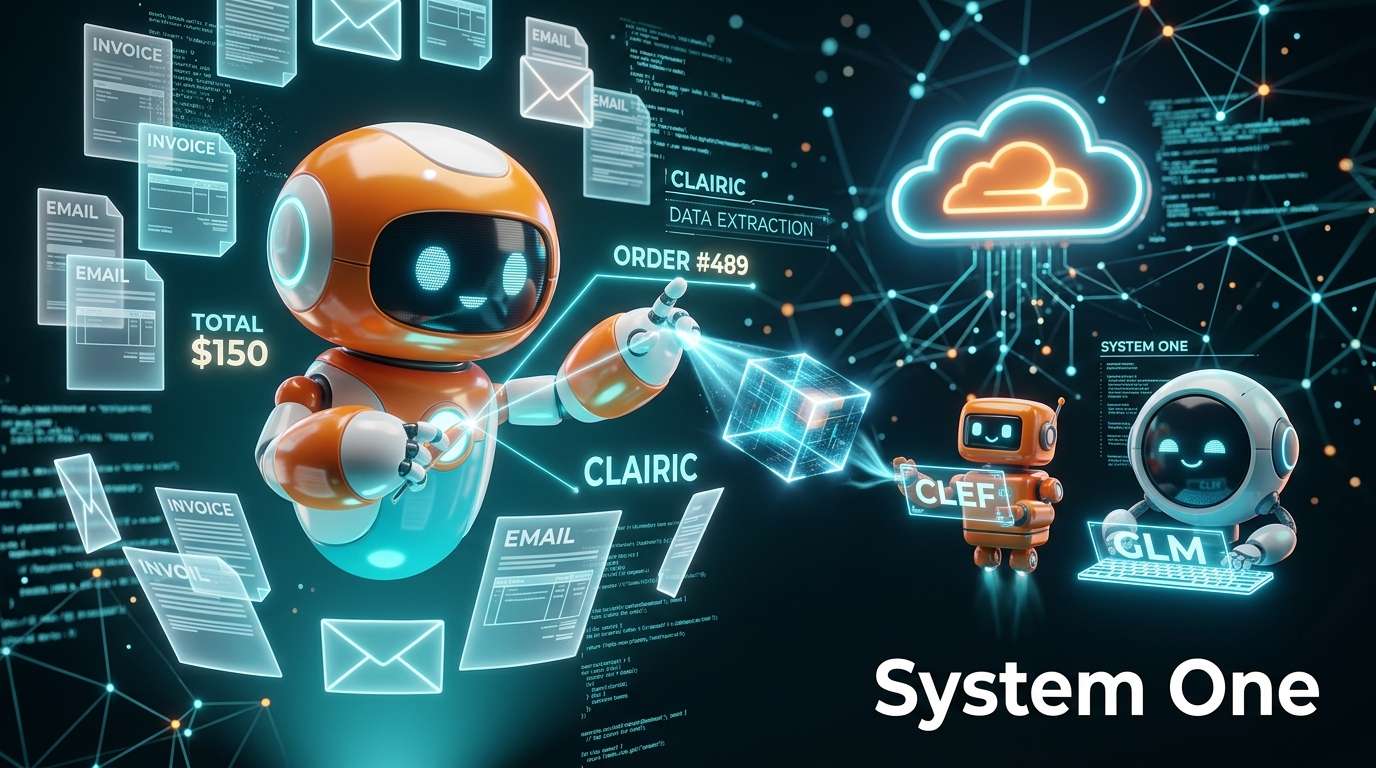
أتاحت Cloudflare للمعاينة نموذج الذكاء الاصطناعي «Clairic»، الذي يستخرج قيماً لحقول محددة من المستندات، عبر منصة تشغيل الذكاء الاصطناعي Workers AI. فعندما يحدد المستخدم أسماء حقول مثل رقم الطلب أو مبلغ الفاتورة، يعيد النموذج القيم بالتنسيق المطلوب، إلى جانب درجة الثقة بها. ومن المقرر أيضاً إتاحة أوزان النموذج المفتوحة (بيانات أوزان النموذج) قريباً، كما عُرضت أمثلة على استخدامه مع نماذج اللغة الكبيرة (LLM).
ذكاء اصطناعي لا يكتب النصوص، بل يستخرج الحقول
عندما يُذكر الذكاء الاصطناعي التوليدي، يتبادر إلى أذهان كثيرين كيان يكتب النصوص بسلاسة. لكن «Clairic» نموذج يتسم بخصائص تكاد تكون معاكسة لذلك. فهو يقتصر على استخراج حقول محددة، مثل «استخراج المبلغ الإجمالي من فاتورة» أو «العثور على رقم الطلب في رسالة بريد إلكتروني».
ويتميز النموذج أيضاً بآلية عمله. فالنماذج اللغوية الكبيرة المعتادة تُنتج النصوص بربط الكلمات واحدة تلو الأخرى (على مستوى الرموز)، أما «Clairic» فلا يعمل بهذه الطريقة، بل يعيد الإجابات عن جميع الحقول المحددة دفعة واحدة. وإذا لم يجد في المستند قيمة مطابقة، يعيد «null» (لا توجد قيمة مطابقة)، ما يجعله مناسباً للاستخدام العملي لأنه لا يختلق إجابة قسراً.
ويُقال إن قدراته لا تقتصر على الاستخراج، بل تشمل أيضاً الحسابات والتقديرات والتنبؤات البسيطة. وبعبارة أخرى، يسهل فهم «Clairic» بوصفه مساعداً في «الأعمال التحضيرية» التي ترتب المعلومات المتناثرة في شكل يسهل استخدامه، لا نموذجاً مهمته كتابة النصوص.
تقسيم مهام التعامل مع الاستفسارات بين النماذج
من الأمثلة التطبيقية التي عرضتها Cloudflare سيناريو لافت. وتتمثل الحالة في رسالة شكوى من عميل. يبدأ «Clairic» باستخراج رقم الطلب والمبلغ وتفاصيل الضرر من الرسالة، ثم يقدّر تكلفة الإصلاح.
بعد ذلك يأتي دور «Clef»، وهو نموذج لاتخاذ القرارات. إذ يختار، بالاستناد إلى القواعد الداخلية للشركة، بين رد المبلغ وإصلاح المنتج. وفي النهاية، يتولى نموذج اللغة الكبيرة GLM-5.3 كتابة الرد الموجّه إلى العميل.
اللافت هنا أن المهمة لا تُسند بكاملها إلى نموذج واحد ضخم. ولو أسقطنا ذلك على بيئة العمل البشرية، فالصورة تشبه فريقاً يرتب فيه موظف الاستقبال المعلومات، ويحدد المسؤول عن اتخاذ القرار الإجراء المناسب، ثم يكتب الرد شخص يجيد الصياغة. وتطلق Cloudflare على مجموعة النماذج الصغيرة المخصصة لهذه المعالجة السريعة اسم نماذج «System One»، وتتوقع استخدامها بالتوازي مع نماذج اللغة الكبيرة، عبر ربطها في سلسلة.
شخصياً، أرى أن هذه الفكرة هي جوهر الإعلان هذه المرة. فعند التفكير في إدخال الذكاء الاصطناعي، يسهل أن ينصب الاهتمام على «اختيار النموذج الأذكى». لكن إذا فُككت مهام العمل، يتضح أن ليس كل موقف يتطلب الاستفادة من كامل قدرات الذكاء الاصطناعي. وقد يصبح تصميم يتيح استخدام أدوات مختلفة بحسب الدور من الأساليب الأساسية للذكاء الاصطناعي في بيئات العمل مستقبلاً.
أرقام السرعة تبرز أثر تقسيم المهام
لنلقِ نظرة أيضاً على الأرقام اللافتة. وفقاً لمقارنة Cloudflare، استغرقت المعالجة المترابطة المكوّنة من المراحل الثلاث المذكورة 19.3 ثانية. أما تنفيذ الخطوات الثلاث نفسها باستخدام GLM-5.3 وحده، فيستغرق 61.7 ثانية، وتبلغ التكلفة قرابة الضعف أيضاً.
لكن هذه الأرقام تخص مثالاً محدداً على المعالجة. ولن يظهر الفرق نفسه في كل أنواع العمل؛ لذا من الأنسب اعتبارها مؤشراً على «مدى التغيير الممكن عند تقسيم المهام». ومع ذلك، فإن تسجيل فارق زمني يتجاوز ثلاثة أضعاف يتيح فرصة للتفكير في أهمية تصميم يقسّم المعالجة.
وقد أوضحت الشركة القيود أيضاً. فـ«Clairic» لا يستطيع بعد التعامل بثبات مع سلاسل طويلة من العمليات الحسابية. ويُقال إن على المطورين، في الوقت الراهن، تنفيذ هذه المعالجة باستخدام شيفرات يكتبونها بأنفسهم.
مع ذلك، يبدو عالم من النماذج المتخصصة التي تنجز بسرعة وبتكلفة منخفضة المهام التي تتقنها وحدها جذاباً لبيئات العمل العملية. ومن المرجح أن تكون فوائد تقسيم المهام أكبر في الأعمال الروتينية التي تتكرر يومياً وبأعداد كبيرة، مثل معالجة الفواتير والرد على الاستفسارات. أما نماذج اللغة الكبيرة، فيمكنها التركيز على المهام التي لا يستطيع سواها إنجازها. ويمنحنا «Clairic» لمحة عن بداية هذا المستقبل.






コメント