
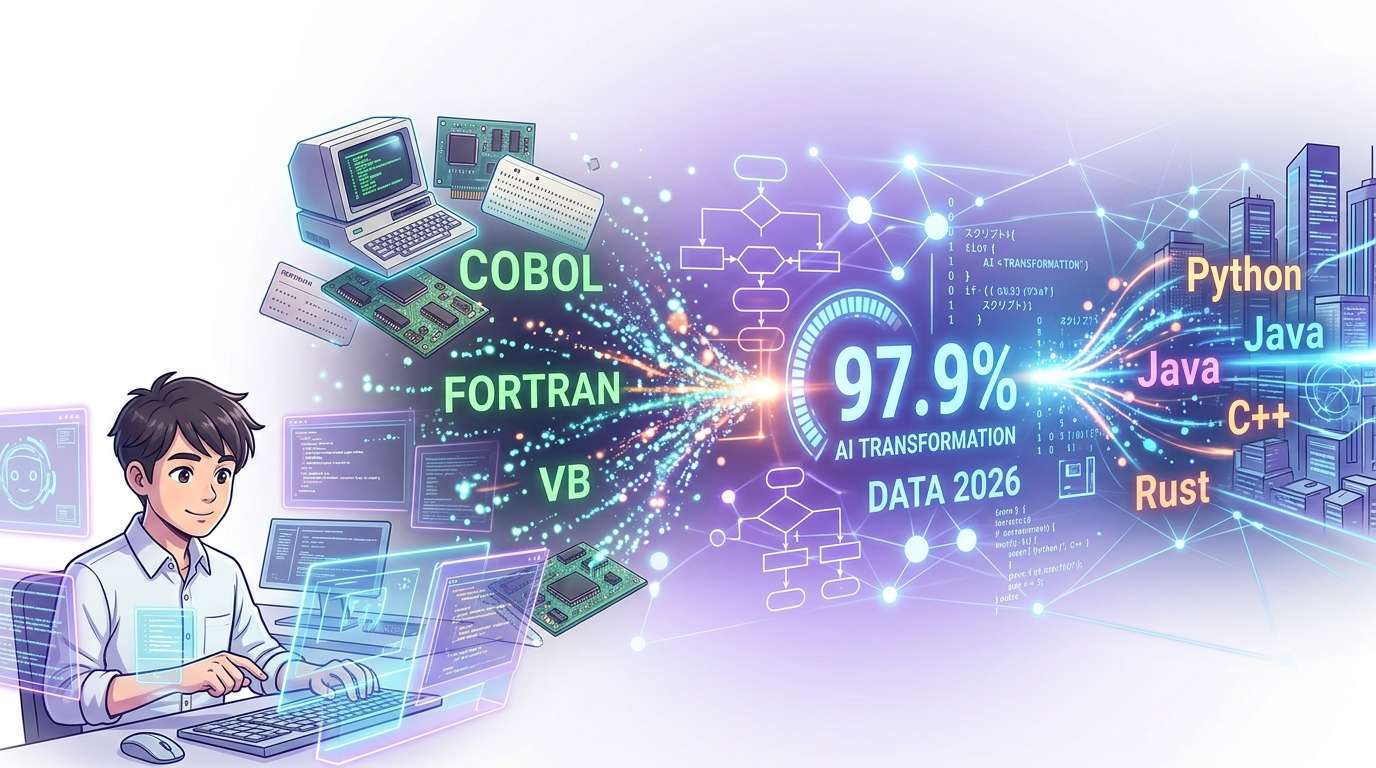
أعلنت OpenAI الأمريكية في 19 أكتوبر (بالتوقيت المحلي) أن قدرات أحدث نماذجها على تطوير البرامج وترحيلها تحسنت بدرجة كبيرة، بما يشمل لغات برمجة مثل COBOL وFortran وVisual Basic، التي لا يتوفر منها سوى القليل من الشيفرات والوثائق التي يمكن للذكاء الاصطناعي أن يتعلم منها. ولقياس هذا التقدم، أعدت الشركة تقييمين خاصين بها، وقالت إن نموذجها سجل دقة 97.9% في تقييم نقل برامج COBOL إلى لغة أخرى، عند رفع حجم الاستدلال.
حضور اللغات القديمة الذي يجدر معرفته قبل النظر إلى الأرقام
ظهرت لغة COBOL عام 1959. وقد يتساءل البعض بدهشة: «هل ما زالت لغة من هذا الزمن القديم مستخدمة؟»، لكنها لا تزال واسعة الانتشار في أنظمة المؤسسات المالية والجهات الحكومية. ووفقًا لـOpenAI، تستند إليها أكثر من 40% من أنظمة الخدمات المصرفية عبر الإنترنت، و80% من معاملات بطاقات الائتمان التي تُجرى حضوريًا، و95% من معاملات أجهزة الصراف الآلي.
أما Fortran، وهي أيضًا من اللغات التي شملها التقييم هذه المرة، فتُستخدم في التنبؤ بالطقس وتحليل سلامة المفاعلات النووية. وبالمقارنة مع Python وJavaScript، فإن الشيفرات والمواد المتاحة لتعلّم الذكاء الاصطناعي منها محدودة. ومع ذلك، فهي تدعم أسس المجتمع، في مفارقة لافتة.
يُقال إن هذه المبادرة جاءت استجابةً لملاحظات من المطورين وعملاء الشركات، مفادها أن «نماذج البرمجة لا تجيد التعامل مع مثل هذه اللغات». ومن الجدير الانتباه إلى أن المشكلة التي تواجه العاملين في الميدان كانت نقطة الانطلاق.
تقييم الترحيل لا يكتفي بأن «يعمل» البرنامج
ما يستحق الاهتمام هو صرامة التقييم الثاني. ففيه يُنقل برنامج COBOL إلى إحدى لغات C++ أو Java أو Kotlin أو Python أو Rust، ثم يُتحقق من قدرته على الحفاظ على سلوك البرنامج الأصلي. وكان شرط النجاح أن تتطابق المخرجات تطابقًا كاملًا بايتًا ببايت. كما استُخدمت اختبارات غير منشورة، ولا يُحتسب التقييم ناجحًا إلا عند اجتيازها جميعًا.
ويوضح مثال ملموس الأمر. ففي الحسابات ذات الفاصلة الثابتة في COBOL، تُحذف المنازل العشرية الزائدة ما لم يُحدَّد التقريب صراحةً. فما الذي يحدث إذا أخذ البرنامج بعد الترحيل، بدافع العادة، في التقريب إلى أقرب قيمة؟ قد تختلف نتيجة حساب المبلغ من دون ظهور أي خطأ.
عندما نتخيل تراكم اختلاف بمقدار ين واحد في ملايين المعاملات المصرفية أو التأمينية، يتضح معنى هذا التقييم. فالأدق من وصف العملية بأنها استبدال لغة بأخرى، هو القول إنها نقل «سلوك» شيفرات أُدمجت فيها ضمنيًا قواعد عمل متّبعة منذ سنوات طويلة إلى لغة أخرى، مع الحفاظ عليه كما هو.
كيف نقرأ رقم 97.9%؟
إليكم ملخص النتائج. في تقييم الترحيل، سجل «GPT-6.1 Sol» دقة 86.6% عند ضبط حجم الاستدلال على مستوى منخفض. أما «GPT-5.6 Sol»، في الإعداد نفسه، فسجل 5.4%، ما يشكل فارقًا كبيرًا. وتبلغ تكلفة واجهة برمجة التطبيقات 61% من تكلفة «GPT-5.6 Sol»، بحسب الشركة. وعند رفع حجم الاستدلال، وصلت الدقة إلى 97.9%.
أما التقييم الآخر، «MultiLangBench»، فيختلف في طبيعته. إذ يطلب من النموذج إنشاء محرك قاعدة بيانات متوافق مع SQLite من الصفر، لكل واحدة من 20 لغة برمجة. وسجل «GPT-6 Astra»، عند استخدام أقصى حجم للاستدلال، متوسطًا لمعدل اجتياز الاختبارات بلغ 87.4% عبر اللغات العشرين، مرتفعًا من 26.8% لدى «GPT-5.6 Sol».
لتجنب الخلط بين التقييمين، نلخص الفروق بينهما في الجدول:
【مقارنة التقييمين】
・تقييم الترحيل: نقل COBOL إلى واحدة من خمس لغات، والتحقق من التطابق بايتًا ببايت في المخرجات. سجل «GPT-6.1 Sol» دقة 86.6% عند انخفاض حجم الاستدلال، و97.9% عند رفعه.
・MultiLangBench: إنشاء محرك قاعدة بيانات متوافق مع SQLite بـ20 لغة. بلغ متوسط معدل اجتياز «GPT-6 Astra» 87.4%.
وتبقى COBOL الأصعب
في MultiLangBench، تجاوزت النتائج 83% في 19 لغة من أصل 20. أما COBOL فسجلت 72.1%؛ ورغم التحسن الكبير مقارنةً بـ10.9% لدى «GPT-5.6 Sol»، فإنها تظل اللغة الأصعب.
كما تجاوز النموذج منخفض التكلفة «GPT-6 Luna» نموذج «GPT-5.6 Sol»، محققًا متوسطًا قدره 40.3%. وتُقدّر تكلفة واجهة برمجة التطبيقات لكل عينة بـ0.77 دولار، أي أقل بنحو 78% من تكلفة «GPT-5.6 Sol» البالغة 3.48 دولار. ومن المقرر نشر بيئة التقييم ومجموعة الاختبارات على GitHub.
تقدم الذكاء الاصطناعي وتحديث الأنظمة القديمة: أين يقف المشهد اليوم؟
ليست هذه المرة الأولى التي تُستخدم فيها تقنيات الذكاء الاصطناعي لترحيل COBOL. ففي عام 2023، أعلنت IBM عن «watsonx Code Assistant for Z»، الذي يستخدم الذكاء الاصطناعي التوليدي لتحويل COBOL إلى Java. وفي فبراير من هذا العام، دعت Anthropic الأمريكية في مدونة إلى الاستعانة بـClaude Code للمساعدة في تحديث COBOL، ونُظر إلى ذلك بوصفه عاملًا وراء تسجيل سهم IBM أكبر انخفاض له في يوم واحد منذ نحو 25 عامًا. فاهتمام السوق بهذا المجال كبير إلى حد أن تدوينة واحدة تهز سعر السهم.
وثمة خلفية اجتماعية أيضًا. ففي عام 2020، ومع تفشي فيروس كورونا المستجد، تدفقت طلبات إعانات البطالة على أنظمة التأمين ضد البطالة القائمة على COBOL والتي تديرها حكومات الولايات الأمريكية. وربما يتذكر البعض أن نقص الخبراء القادرين على التعامل مع هذه الأنظمة أصبح مشكلة. إن قدرة الذكاء الاصطناعي على دخول المجالات التي تعاني نقصًا في الأيدي العاملة ليست مسألة تقنية فحسب، بل ترتبط باستدامة الإدارة العامة والقطاع المالي.
استخدامه من دون تفويضه المهمة بالكامل
على الرغم من ارتفاع الأرقام، تقول OpenAI نفسها إن تطبيق هذه التقنية على البرمجيات المستخدمة فعليًا لا يزال يتطلب مراجعة الخبراء واختبارات تراعي قواعد العمل في النظام واعتماداته. فحتى اجتياز اختبارات التحقق من التطابق على مستوى البايت، تظل في بيئة العمل حالات استثنائية وروابط بأنظمة أخرى لم تأخذها اختبارات التقييم في الحسبان.
أرى أن النظرة الواقعية لدور الذكاء الاصطناعي هي اعتباره «مقاولًا من الباطن» ينجز أعمال الترحيل بطريقة يسهل التحقق منها، لا «سحرًا» يستبدل كل شيء دفعة واحدة. وفي الحالات التي فُقدت فيها وثائق مواصفات النظام الأصلي، ستكون القدرة على تصميم اختبارات تؤكد استعادة سلوكه الأصلي أهم من سرعة التحويل. ويشير رقم 97.9% إلى أن الطريق إلى الترحيل اتسع بسرعة كبيرة، على افتراض أن البشر سيتولون أعمال التحقق.






コメント