
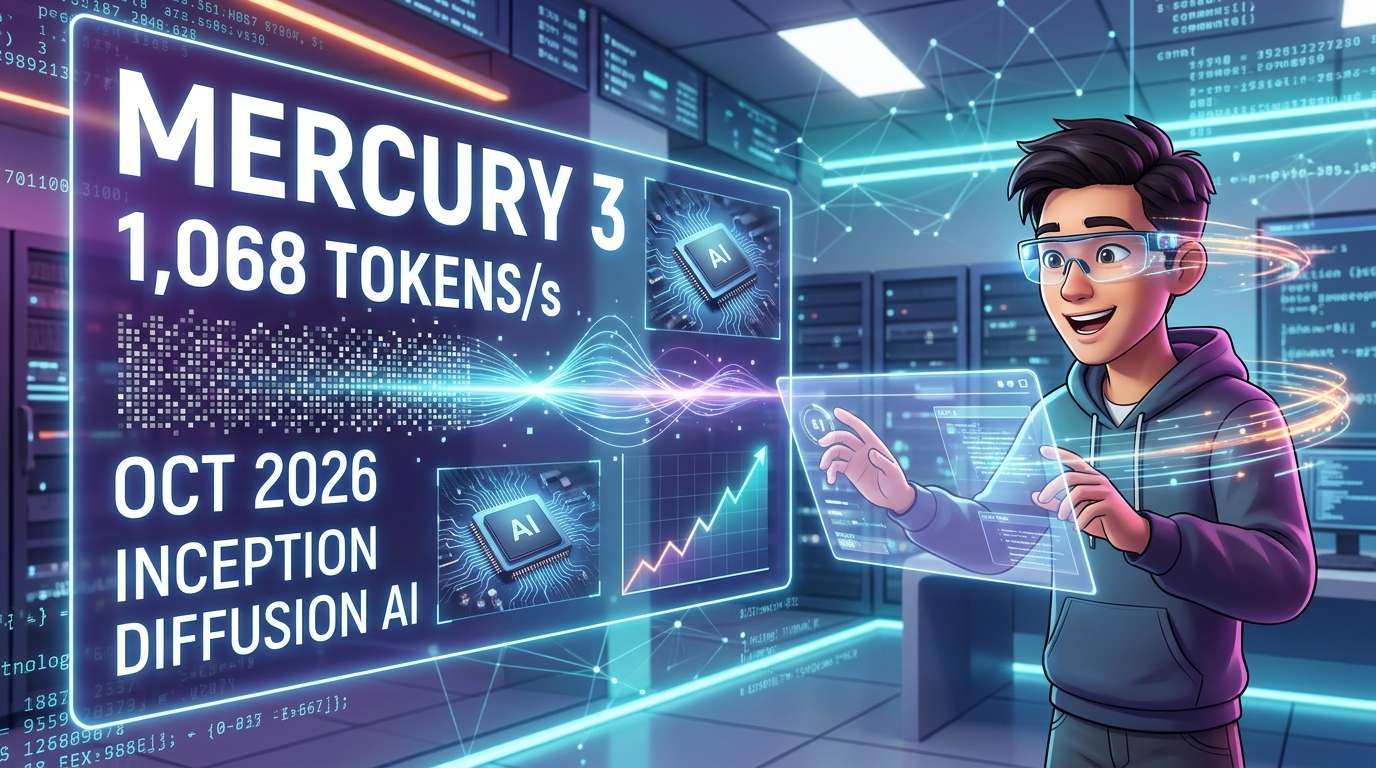
Startup AI asal AS, Inception, mengumumkan model bahasa berbasis difusi “Mercury 3” pada Oktober 2026. Menurut perbandingan perusahaan, model ini menghasilkan 1.068 token per detik pada GPU Nvidia, atau 4–8 kali lebih cepat dibandingkan GPT-6 Luna dan Claude Haiku 5.5. Inception juga mengklaim modelnya unggul dalam 8 dari 12 tolok ukur. Ini menjadi salah satu contoh bahwa persaingan AI tak lagi hanya bertumpu pada “kecerdasan”, tetapi juga meluas ke “waktu tunggu”.
Apa sebenarnya model yang tidak menulis satu kata demi satu kata?
Model bahasa arus utama seperti GPT dan Claude menghasilkan teks secara berurutan, satu kata demi satu kata. Untuk menghasilkan kata berikutnya, kata sebelumnya harus ditentukan lebih dulu—ibarat mengantre di kasir. Secepat apa pun komputernya, struktur “menunggu dalam satu barisan” ini tetap sama.
Mercury 3 menggunakan pendekatan yang disebut model difusi. Pendekatan yang populer dalam AI pembuat gambar ini diterapkan pada teks: model terlebih dahulu membuat draf kasar seluruh jawaban, lalu menyempurnakannya melalui beberapa tahap pemrosesan. Menurut Inception, kemampuan memproses banyak kata secara bersamaan memberi model ini keunggulan dalam hal kecepatan. Google juga mengembangkan riset di bidang yang sama. Setelah demo Gemini Diffusion, pada Juni Google merilis model terbuka “DiffusionGemma”. Model ini diklaim hingga 4 kali lebih cepat daripada Gemma 4 versi standar, meski hasilnya sedikit lebih rendah.
Menurut Inception, jumlah parameter Mercury 3 lebih dari 40 kali lipat dibandingkan Mercury 1 generasi pertama, tetapi kecepatannya setara. Dibandingkan versi kecil Mercury 1 mini, performanya disebut meningkat 3 kali lipat. Performa model difusi pun meningkat secara konsisten ketika skalanya diperbesar. Inception menyebut hal ini sebagai bukti penting bahwa pendekatan tersebut menjanjikan.
Hasil tolok ukur tidak sepenuhnya berpihak pada satu model
Angka “memimpin dalam 8 dari 12 tolok ukur” menjadi sorotan dalam pengumuman tersebut. Namun, perbandingan ini didasarkan pada pengukuran Inception sendiri, dengan ketiga model dijalankan menggunakan pengaturan tingkat menengah.
Perbedaan paling besar terlihat pada kemampuan mengikuti instruksi. Mercury 3 meraih 76,84 poin di IFBench, sekitar 15 poin lebih tinggi daripada GPT-6 Luna. Dalam SWE-Bench Atlas, tolok ukur untuk mengukur kemampuan coding otonom, Mercury 3 juga mencatatkan 51,08 poin, jauh di atas para pesaingnya yang meraih 33,33 dan 32,26 poin.
Sebaliknya, Claude Haiku 5.5 unggul dalam DeepSWE, tolok ukur untuk tugas coding yang lebih panjang. Model itu juga lebih unggul dalam tugas mencari informasi dari teks panjang. Dalam dua tolok ukur Artificial Analysis, GPT-6 Luna sedikit lebih unggul. Rincian ini mungkin menjelaskan mengapa materi pengenalan singkat Inception menggambarkan kualitas Mercury 3 secara hati-hati sebagai “setara atau lebih baik”.
Dalam perbandingan Inception, kecepatan Mercury 3 mencapai 1.068 token per detik, sedangkan Claude Haiku 5.5 sekitar 240 token per detik dan GPT-6 Luna sekitar 130 token per detik. Belum ada hasil pengujian dari pihak ketiga yang independen. Angka-angka ini sebaiknya dipandang sebagai “klaim yang menjanjikan”; langkah paling realistis adalah mencobanya untuk kebutuhan sendiri.
Situasi ketika waktu tunggu menjadi nilai tambah
Inception menyebut agen AI, pencarian, dukungan pelanggan, dan pendampingan belajar sebagai penggunaan utama model ini. Agen AI khususnya membagi satu pekerjaan menjadi banyak tahap, dan pada setiap tahapnya harus menunggu jawaban model. Meski keterlambatan dalam satu tahap mungkin kecil, jika terakumulasi, pengalaman pengguna bisa berubah secara signifikan.
Masukan dari perusahaan yang lebih awal menggunakannya juga berfokus pada kecepatan. Kuan Zou, pendiri Octen AI yang mengembangkan fitur pencarian untuk kacamata pintar, mengatakan, “Di kacamata pintar, jawaban yang memerlukan waktu 5 detik terasa seperti perangkatnya rusak.” Pencarian itu sendiri selesai dalam sekitar 80 milidetik; menurutnya, hambatannya adalah model bahasa. Dengan Mercury 3, waktu respons median menjadi 0,9 detik, sementara keseluruhan pemrosesan memakan waktu 2,2 detik.
General Learning, perusahaan di bidang pendidikan, mengatakan kini dapat memberikan petunjuk dan koreksi kepada siswa dalam sekitar 1 detik. Lorikeet, perusahaan layanan pelanggan, melaporkan bahwa hasilnya juga membaik selain respons menjadi lebih cepat. TinyFish AI, yang mengotomatiskan interaksi dengan situs web, mengatakan model ini berhasil menyelesaikan 25 dari 50 tugas navigasi di situs nyata dan mengungguli GPT-6.1-Sol. Namun, angka spesifik dari OpenAI tidak disampaikan.
Pertimbangkan faktor selain kecepatan sebelum mengadopsinya
Hambatan untuk mulai menggunakan model ini relatif rendah. Mercury 3 tersedia melalui platform Inception sendiri, serta OpenRouter, Baseten, dan Vercel. Model ini menggunakan API yang kompatibel dengan model OpenAI. Menurut Inception, hal ini membuat perpindahan dari sistem yang sudah ada tidak memerlukan banyak usaha. Model ini dapat menangani input hingga 1 juta token.
Tarif normalnya adalah 0,20 dolar per 1 juta token input dan 0,70 dolar untuk output. Saat diumumkan, model ini ditawarkan dengan harga setengahnya, tetapi Inception tidak menyebutkan sampai kapan diskon tersebut berlaku. Jika tarif kembali normal, harga outputnya akan lebih tinggi daripada GPT-6 Luna dan Claude Haiku 5.5 untuk input pendek—keduanya mengenakan 0,50 dolar. Namun, untuk input yang sangat panjang, biaya kedua model pesaing tersebut jauh lebih tinggi.
Pada Februari 2026, Inception merilis “Mercury 2”, yang disebut sebagai model difusi pertama yang menjalankan penalaran antara sebelum memberikan jawaban. Sebelumnya, perusahaan itu telah menggalang dana sebesar 50 juta dolar. Para investornya mencakup Nvidia, Microsoft, NVentures yang merupakan divisi investasi Snowflake, M12, dan Snowflake Ventures.
Pada akhirnya, kecepatan bukan satu-satunya faktor penentu. Kualitas, biaya, kemampuan menangani teks panjang, dan seberapa sensitif layanan Anda terhadap latensi juga perlu dipertimbangkan. Jika aplikasi Anda sangat mengandalkan respons real-time, Mercury 3 tampaknya layak dicoba.






コメント