
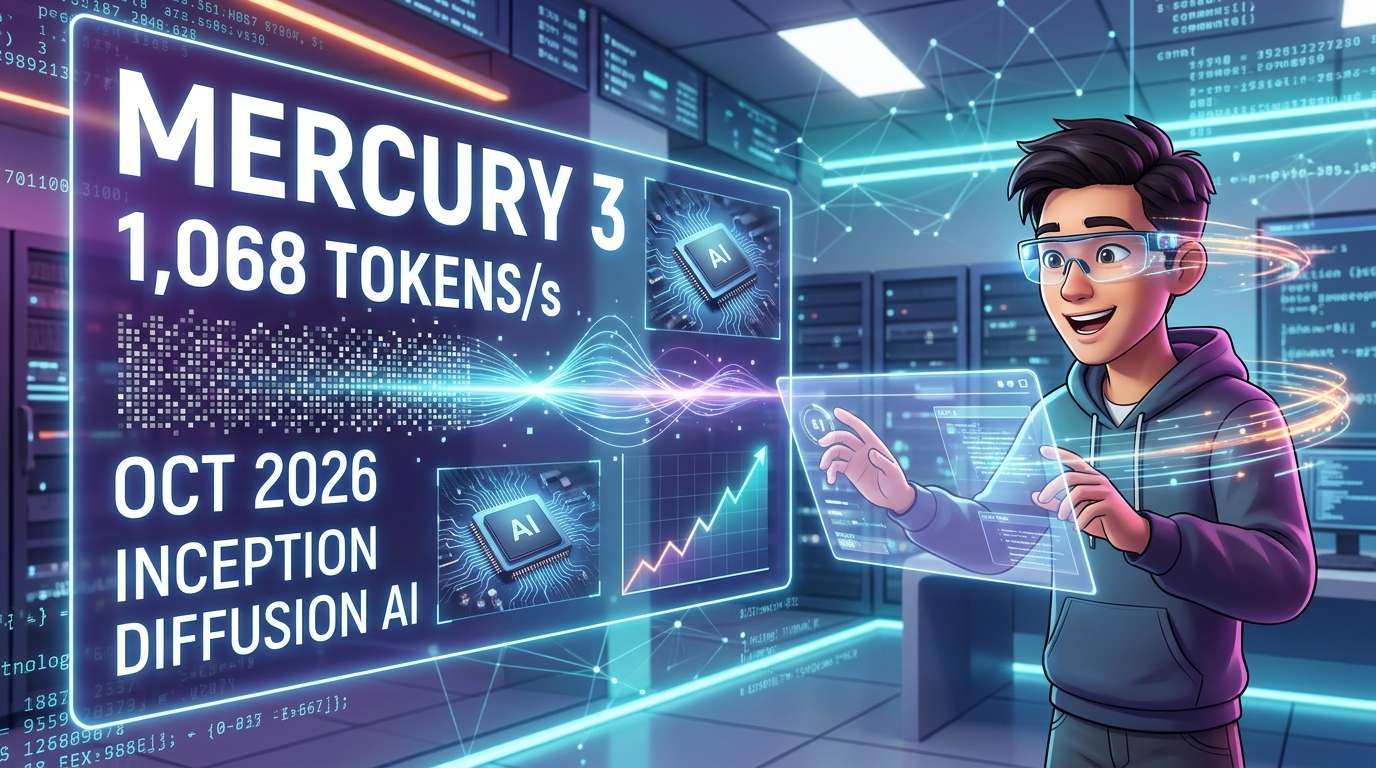
La startup statunitense di IA Inception ha annunciato nell’ottobre 2026 il modello linguistico a diffusione «Mercury 3». Secondo i confronti dell’azienda, il modello genera 1.068 token al secondo su GPU Nvidia ed è da 4 a 8 volte più veloce di GPT-6 Luna e Claude Haiku 5.5. Inception sostiene inoltre che abbia superato gli altri modelli in 8 benchmark su 12: un esempio di come la competizione nell’IA si stia estendendo dalla «intelligenza» ai «tempi di attesa».
Che cosa sono i modelli che non scrivono una parola alla volta
I principali modelli linguistici, come GPT e Claude, generano il testo una parola alla volta, in sequenza. Per produrre la parola successiva, devono prima aver stabilito quella precedente: è come fare la fila alla cassa. Per quanto veloci siano i computer, questa struttura di «attesa in fila» non cambia.
Mercury 3 adotta un approccio diverso, basato sui modelli a diffusione. Applica al testo un metodo affermatosi con l’IA per la generazione di immagini: prima crea una bozza approssimativa dell’intera risposta, poi la perfeziona in più passaggi di elaborazione. Secondo Inception, la possibilità di elaborare molte parole contemporaneamente offre un vantaggio in termini di velocità. Anche Google sta lavorando a ricerche nella stessa direzione: dopo la demo di Gemini Diffusion, a giugno ha pubblicato il modello aperto «DiffusionGemma». È considerato fino a 4 volte più veloce del Gemma 4 standard, anche se i risultati sono leggermente inferiori.
Secondo Inception, Mercury 3 ha oltre 40 volte i parametri del Mercury 1 originale, ma raggiunge la stessa velocità. Rispetto alla versione compatta Mercury 1 mini, le prestazioni sono triplicate. L’azienda considera un importante segnale il fatto che anche i modelli a diffusione migliorino in modo costante con l’aumentare delle dimensioni.
I risultati dei benchmark non raccontano una storia univoca
Nell’annuncio spicca il dato secondo cui Mercury 3 è «primo in 8 benchmark su 12». Il confronto, però, si basa su misurazioni condotte dalla stessa azienda e su tutti e tre i modelli impostati a un livello intermedio.
Il divario più ampio riguarda il rispetto delle istruzioni. Su IFBench, Mercury 3 ha ottenuto 76,84 punti, circa 15 in più di GPT-6 Luna. Anche nel benchmark SWE-Bench Atlas, che misura la programmazione autonoma, ha raggiunto 51,08 punti, staccando i concorrenti, fermi a 33,33 e 32,26.
Nel compito di programmazione più lungo DeepSWE, invece, ha prevalso Claude Haiku 5.5. Lo stesso modello è in vantaggio anche nei compiti che richiedono di cercare informazioni in testi lunghi. Nei due benchmark di Artificial Analysis, GPT-6 Luna è leggermente avanti. È probabilmente alla luce di questi risultati che la breve descrizione dell’azienda definisce la qualità, con cautela, «pari o superiore».
Anche sul fronte della velocità, il confronto dell’azienda indica 1.068 token al secondo per Mercury 3, circa 240 per Claude Haiku 5.5 e circa 130 per GPT-6 Luna. Non sono ancora disponibili verifiche indipendenti di terze parti. È ragionevole considerare questi numeri un’affermazione promettente e verificarli provando il modello nei propri casi d’uso.
Quando i tempi di attesa diventano un valore
Tra i principali ambiti di utilizzo, Inception cita gli agenti AI, la ricerca, l’assistenza clienti e il supporto all’apprendimento. Gli agenti, in particolare, svolgono un’attività articolata in più passaggi e a ogni fase devono attendere la risposta del modello. Anche se il ritardo di una singola risposta è breve, quando si accumula può cambiare notevolmente l’esperienza percepita dagli utenti.
Anche le testimonianze delle aziende che hanno avuto accesso anticipato si concentrano sulla velocità. Kuan Zou, fondatore di Octen AI, che sviluppa una funzione di ricerca per smart glasses, afferma: «Sugli smart glasses, una risposta che richiede 5 secondi sembra guasta». La ricerca in sé richiedeva circa 80 millisecondi: il collo di bottiglia era il modello linguistico. Con Mercury 3, il tempo mediano di risposta è sceso a 0,9 secondi e il tempo complessivo di elaborazione a 2,2 secondi.
General Learning, attiva nel settore dell’istruzione, afferma di poter fornire agli studenti suggerimenti e correzioni in circa un secondo. Lorikeet, azienda di assistenza clienti, ha riferito sia risposte più rapide sia risultati migliori. TinyFish AI, che automatizza le interazioni con i siti web, spiega di aver risolto 25 dei 50 compiti di navigazione su siti reali, superando GPT-6.1-Sol. Non sono però stati forniti dati specifici da parte di OpenAI.
Nella scelta, valutare anche altri fattori oltre alla velocità
La soglia d’ingresso è relativamente bassa. Mercury 3 è disponibile sulla piattaforma di Inception e tramite OpenRouter, Baseten e Vercel. L’azienda ritiene che passare dai sistemi esistenti richieda poco lavoro, grazie a un’API compatibile con i modelli OpenAI. Il modello può elaborare fino a 1 milione di token in input.
Il prezzo standard è di 0,20 dollari per 1 milione di token in input e 0,70 dollari per 1 milione di token in output. Al momento dell’annuncio è disponibile a metà prezzo, ma non è stato indicato per quanto tempo resterà valido lo sconto. Tornando al prezzo standard, per input brevi il costo per token in uscita supera quello di GPT-6 Luna e Claude Haiku 5.5, entrambi pari a 0,50 dollari. Per input molto lunghi, invece, le tariffe dei due modelli concorrenti sono notevolmente più alte.
Nel febbraio 2026 Inception aveva presentato «Mercury 2», definito il primo modello a diffusione a inserire un ragionamento intermedio prima di rispondere. In precedenza aveva raccolto 50 milioni di dollari. Tra gli investitori figurano Nvidia, Microsoft, NVentures — il ramo d’investimento di Snowflake —, M12 e Snowflake Ventures.
In definitiva, la scelta non dipende soltanto dalla velocità. A determinarla è la combinazione di qualità, costi, gestione dei testi lunghi e sensibilità del proprio servizio ai tempi di attesa. Per le applicazioni in cui la risposta in tempo reale è fondamentale, Mercury 3 potrebbe essere una valida opzione da provare.






コメント