
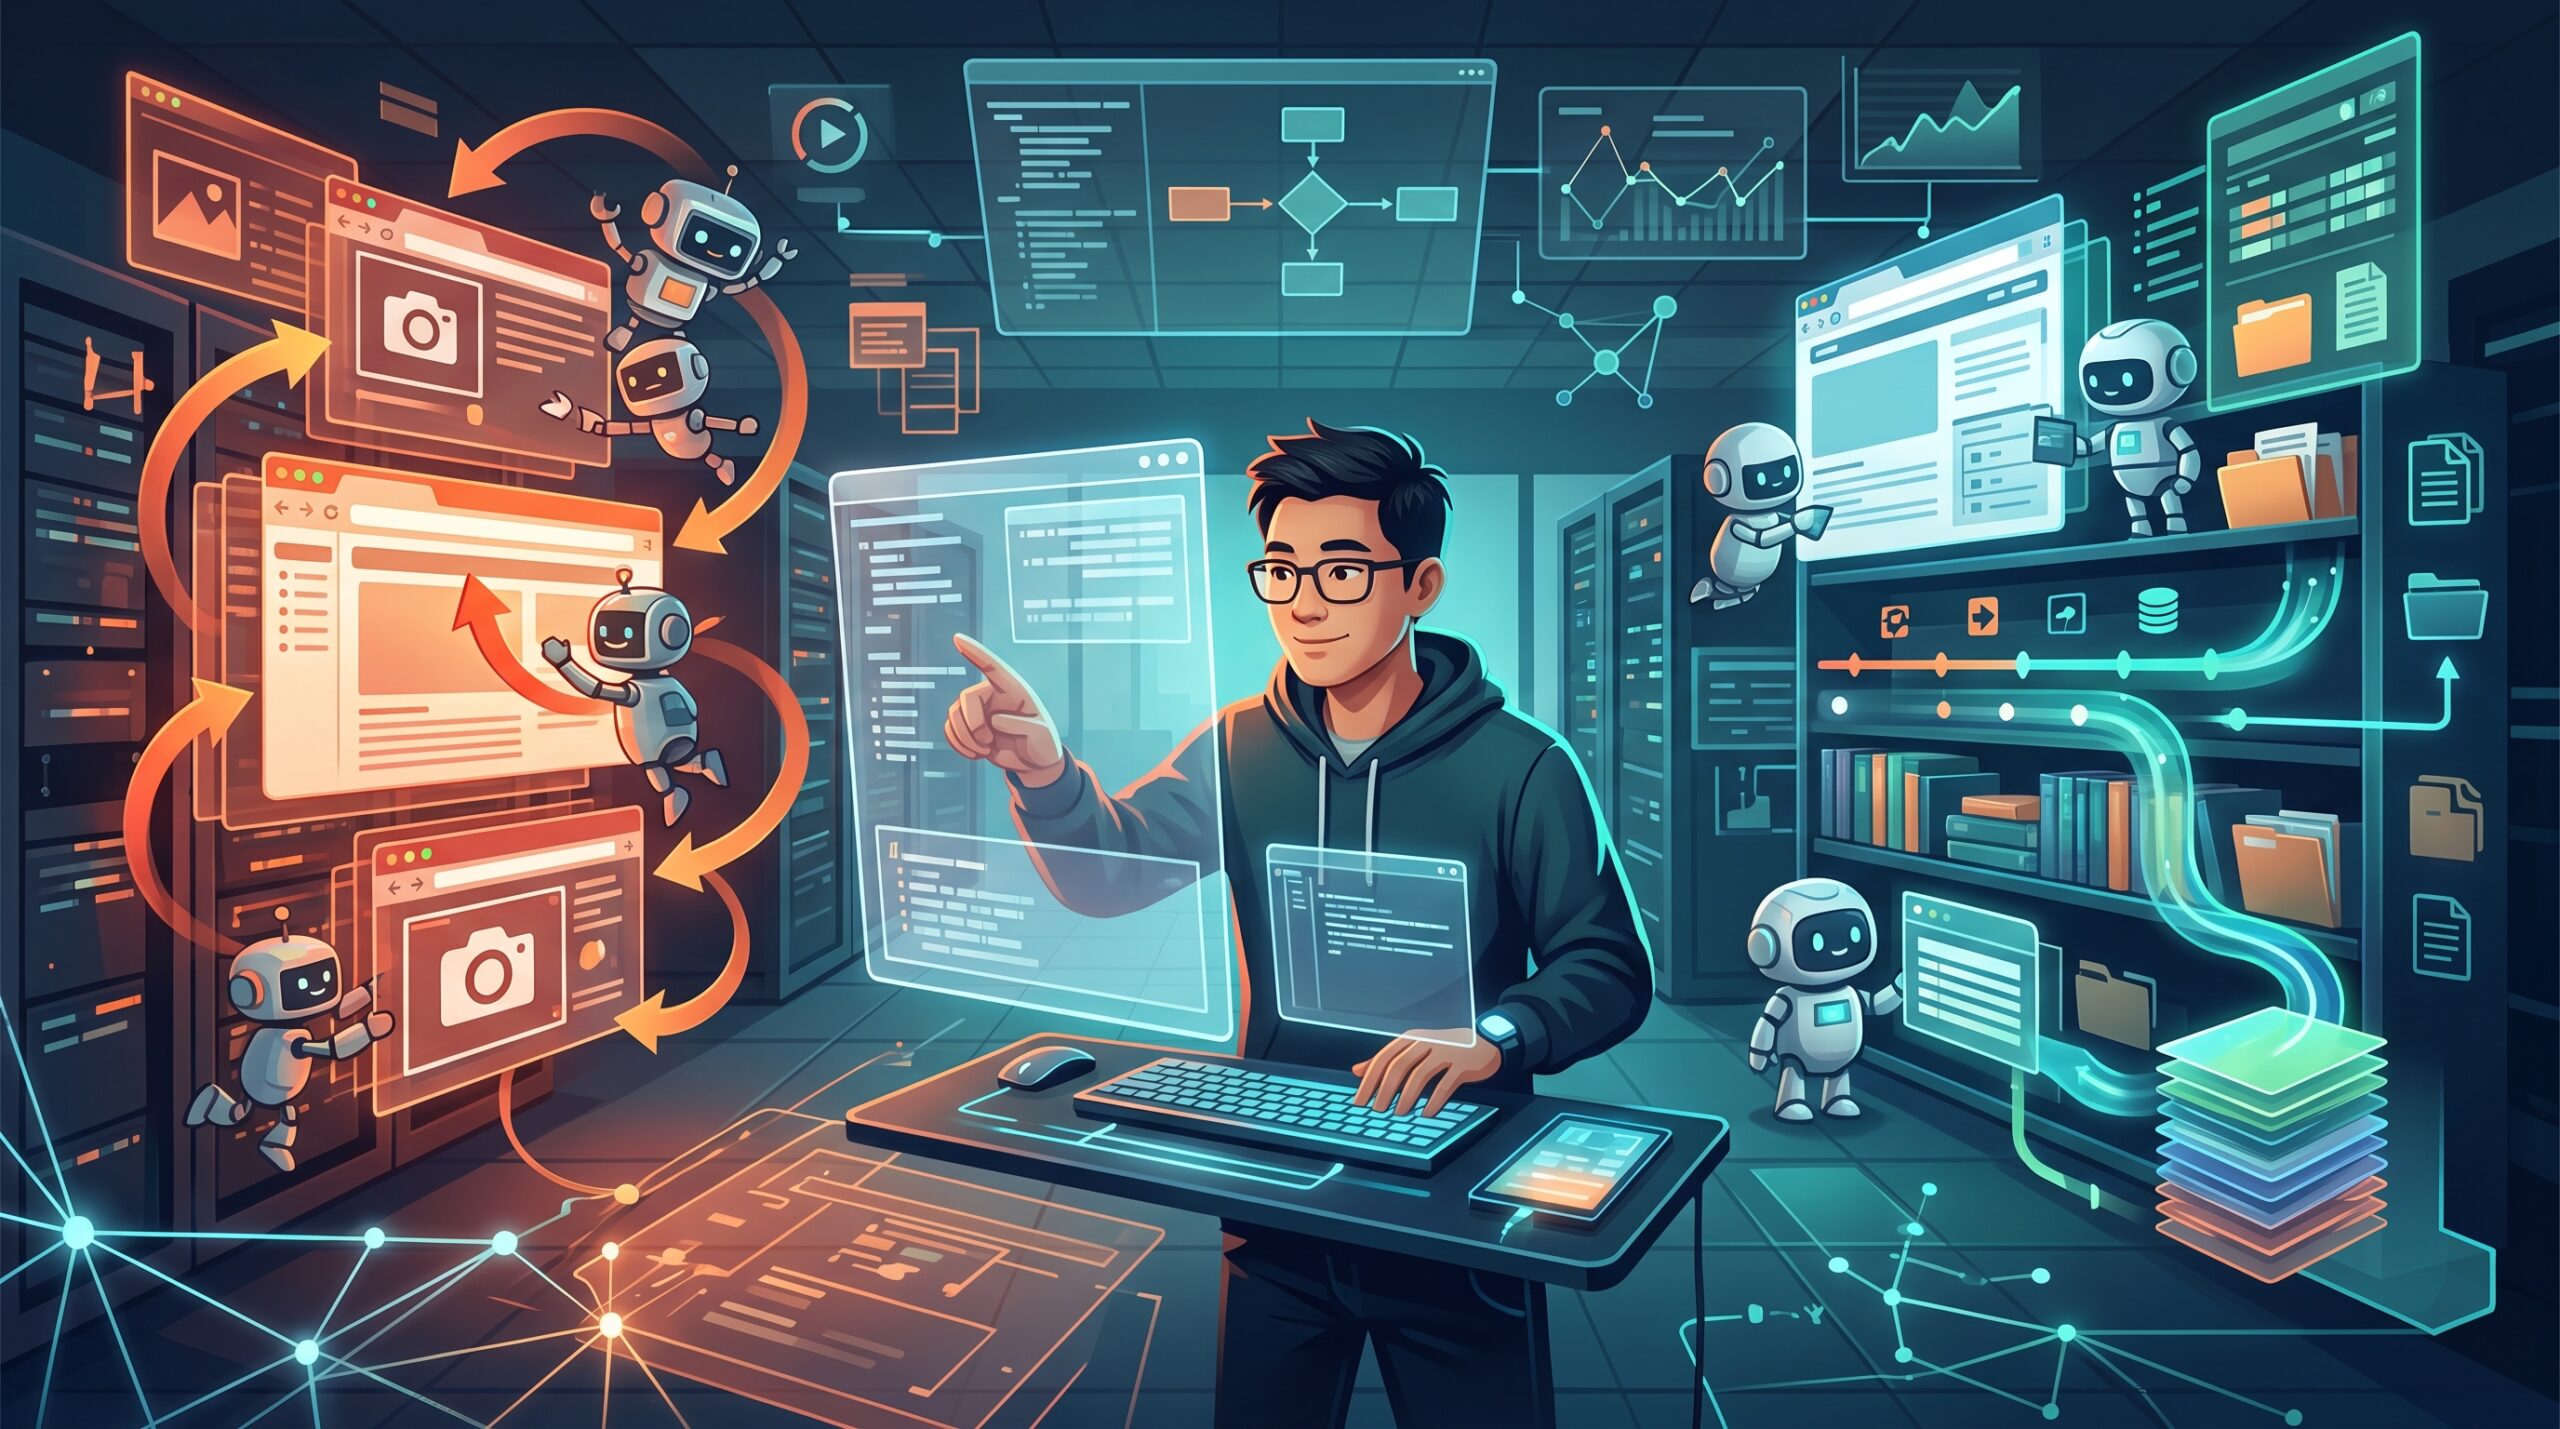
Asana 表示,透過驗證 StackAI 的瀏覽器操作自動化 AI,與先前的正式環境配置相比,預估模型成本降至 1/76,處理速度則提升 5 倍。在採用 GPT‑6.1 Sol 並最佳化瀏覽紀錄管理的配置下,每次處理平均耗時約 4 分鐘,成本為 0.47 美元。
降至 1/76,不只是更換模型的成果
這次公布的數字有一點值得注意:比較的不是模型單獨的效能,而是模型與處理機制搭配後的結果。瀏覽器代理是一種能讀取網頁並進行資訊蒐集、填寫表單等工作的 AI。Asana 透過收購的 StackAI 提供這類業務自動化服務。
這次驗證從公開示範目錄中挑選 32 本書籍,蒐集每本書的 6 項資訊。研究人員使用 4 種模型和多種設定,總共進行 144 次測試。最初使用的模型 B,每次執行的預估模型成本至少為 36.21 美元;但只要重新檢視處理機制,成本就降至 1.24 美元。進一步採用 GPT‑6.1 Sol 的最佳化配置後,成本則降至 0.47 美元。
換句話說,即使維持使用模型 B,成本也能降至約 1/29。標題所說的 1/76 背後,模型選擇之前的處理設計改善也發揮了重要作用。
節省成本的關鍵,在於提供給 AI 的瀏覽紀錄
在先前的配置中,固定指令等內容會進行快取,但不斷累積的網頁內文和螢幕截圖紀錄則不在快取範圍內。快取是一種重複利用已處理輸入的機制。若無法重複利用紀錄,每次呼叫 AI 時都得重新傳送過去的資訊,並因此產生費用。
此外,系統幾乎每個步驟都會刪除舊圖片並縮短文字。由於紀錄頻繁改寫,單靠加入快取很難發揮效果。若刪除太多資訊,也可能導致系統重新造訪已讀過的頁面。
因此,研究人員將紀錄保留上限從 12 萬字提高至 48 萬字,並將瀏覽紀錄納入快取。螢幕截圖最多累積 20 張後,再只保留最新的一張。這種集中整理而非每次都整理的做法,延長了過往紀錄能在不修改的情況下重複使用的時間。
保留更多資訊,費用也能降低
減少提供給 AI 的資訊就能降低成本。這次的結果顯示,光靠這個想法無法解釋代理程式的成本。有時保留並重複利用資訊、減少不必要的重新確認,反而能降低整體處理成本。
在 GPT‑6.1 Sol 的測試中,於擴大紀錄保留上限的條件下重新檢視快取和圖片管理後,每次執行的預估模型成本從 1.97 美元降至 0.47 美元。最佳化後,89% 的輸入由快取提供,而這部分的費用僅為未使用快取時的 5%。
紀錄量也會影響任務是否能完成。使用 GPT‑6.1 Sol 產生回答的執行次數,在較小的保留上限下為 18 次中的 3 次;在較大的上限下則是 18 次全數完成。驗證中的這 18 次執行都得到了正確答案。
測試改善方案的工作也運用了 AI
除了實際操作瀏覽器的 GPT‑6.1 Sol,研究與改善工作還使用了 Codex 的 GPT‑6 Astra。它檢視程式碼結構、找出紀錄管理問題,並為實驗重新整理程式碼,同時平行測試多種設定。
這並不代表過程中沒有人參與。StackAI 技術長 Frank Hidalgo 確認提案,並選出要驗證的修改方案。實驗紀錄和輸出也由其他模型工作階段進行審查,並保存在 Asana 的開發平台 Command 中。變更則透過工單和拉取請求流程部署至正式環境。
Hidalgo 表示,若以人工方式進行,估計需要 1 至 2 個月的調查工作,約一週就完成了。這項時間差是與他的估計相比,並非由人類單獨執行相同工作的對照實驗結果。
評估是否導入時,應同時考量成本與完成率
這次的 0.47 美元是預估模型成本,不是包含人力和系統營運費用在內的總成本。此外,部分基準配置達到處理次數上限而未能完成,因此 36.21 美元以上、22.5 分鐘以上都是下限。主要比較數字是各配置執行 3 次的平均值,不能將相同的降幅套用到所有網頁業務。
在最佳化配置之間比較,模型 C 的成本為 0.66 美元、耗時 3.5 分鐘;GPT‑6.1 Sol 則為 0.47 美元、約 4 分鐘。就這項任務而言,Sol 的成本較低,但模型 C 的執行時間較短,成本和速度的排名並不相同。
Asana 已將這次的變更套用到 StackAI 的瀏覽器操作功能。接下來,該公司計畫將驗證整合至平台的評估功能,讓客戶和內部團隊能比較不同設定的成本、執行時間和回答品質。






コメント