
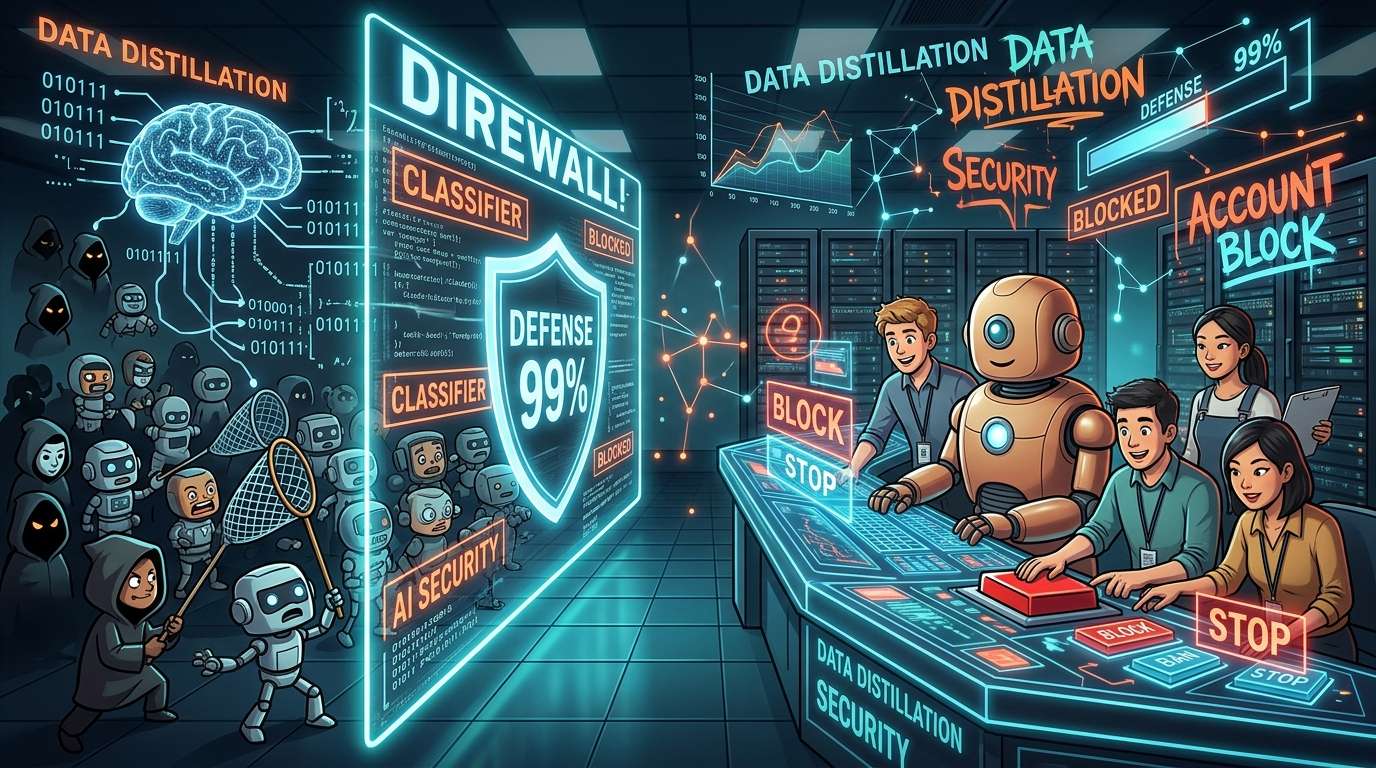
Anthropic表示,该公司加强了对大规模窃取对话式AI“Claude”推理过程信息(推理令牌)行为的防范,并将被提取的信息量减少了90%至99%。除了限制对推理信息的访问,该公司还部署了可识别提取迹象的分类器,并引入自动停用相关账户的机制。据称,目前已停用数万个账户。
如何防止对Claude的大规模访问
事情的起因是“蒸馏”。这是指以强大的AI模型输出为教材,训练另一个更小型模型的方法。这本是用于精简自家模型的正当技术,但也有人向其他公司的模型大量提问,并以其回答为线索,照搬整个模型的能力。Anthropic所关注的,正是后面这种有组织的提取行为。
据该公司介绍,攻击方利用了由数十万个虚假账户组成的网络。每个账户的活动都控制在看起来像普通用户的程度,整体上则收集海量回答。这种手法简直可以称作“账户海战术”,而非人海战术。
攻击者瞄准的是推理令牌,也就是模型得出答案前经历的内部思考步骤。如果不仅拿到最终答案,还掌握其思路,就能教会另一个模型“如何思考”。打个比方,这就像不仅模仿一道菜的成品味道,还把整本食谱步骤都拿走了。
Anthropic采取的措施主要有三项:限制对Claude内部推理步骤的访问;启用识别提取企图的分类器;自动停用被判定为可疑的账户。
数据揭示的措施成效及其局限
Anthropic称,防御措施启用后,被提取的推理令牌数量减少了90%至99%。该公司还表示,蒸馏成功案例在采取措施后大幅下降。尽管给出的是一个区间,但Anthropic声称至少已将其控制在原来的十分之一以下。
另一个不容忽视的问题,是该公司承认这些措施也会产生副作用。据称,正当用户有时也会被误判。拦截违规行为的筛查网越严密,正常使用的个人和企业也越容易被误伤。这种安全措施难以避免的局限,在AI服务中也不例外。
大量使用服务的开发者,以及集成了自动化工具的业务系统,其行为有时可能看起来与提取迹象相似。今后,如何平衡反作弊措施的力度与不妨碍正常使用的运营方式,将左右服务的易用性。
点名企业意味着什么
Anthropic此次点名中国企业智谱(Zhipu)和Moonshot,称其参与了相关行为。根据Anthropic的说法,智谱从美国主要模型中获取了网络安全相关能力,并将其用于自家的GLM-5.3。Anthropic还指称,Moonshot曾秘密通过Claude进行查询。这些均为Anthropic方面的说法,本次公布的材料中无法确认两家公司的看法。
Anthropic还提到,这样被提取的能力可能流入外国的军事系统或监控系统。值得注意的是,该公司将此事定位为安全保障问题,而非仅仅是商业模仿。
该公司还采取了另一项行动,呼吁其他AI开发企业也采用类似的防御措施。因为如果只有一家公司把守好大门,其他入口仍遭窃取,防范效果就会大打折扣。整个行业能否步调一致,将受到考验。
生成式AI领域的竞争,正从打造智能模型的较量,扩展为判断并管控谁在如何使用模型的较量。检测虚假账户、限制访问等看似不起眼的防御技术,今后或将越来越多地左右AI企业的竞争力。








コメント