
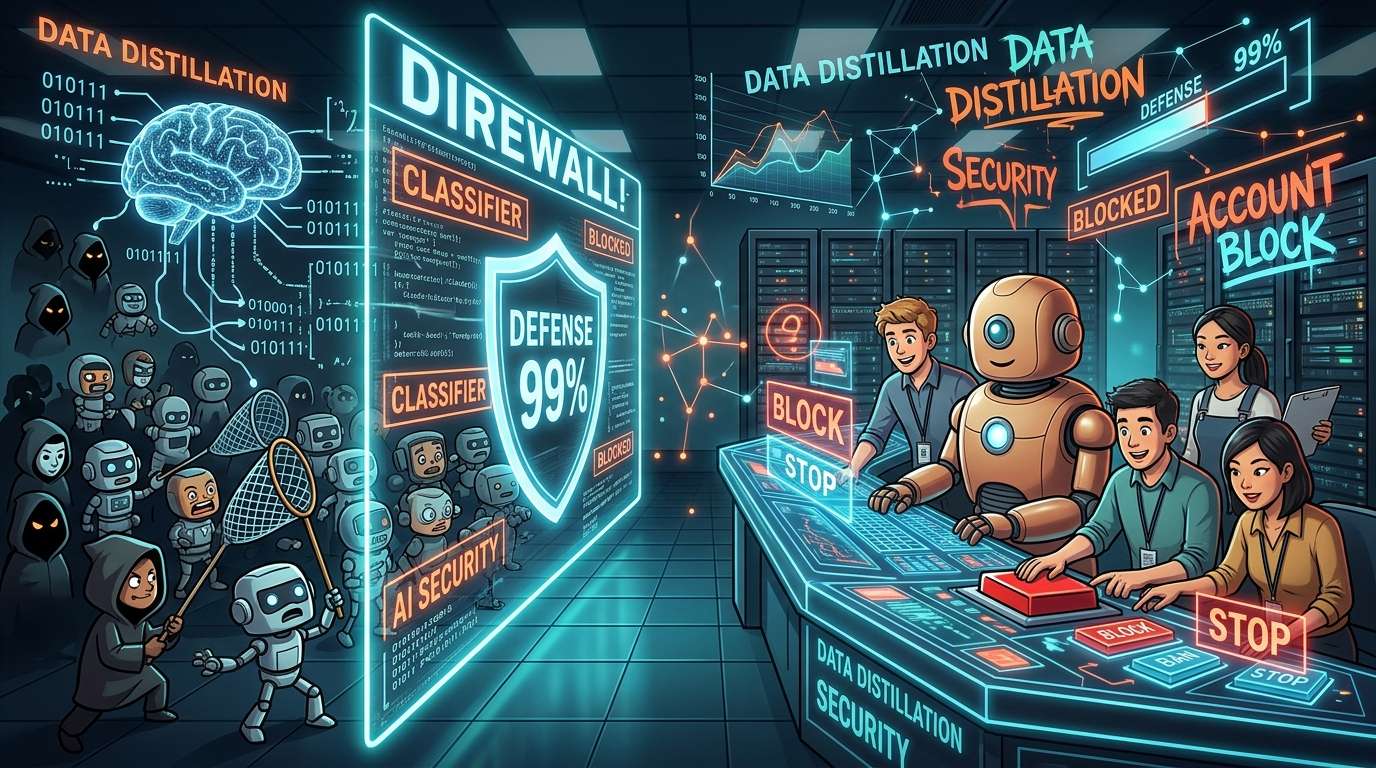
Anthropic ने बताया कि उसने संवादात्मक AI ‘Claude’ की तर्क-प्रक्रिया दिखाने वाली जानकारी—यानी रीजनिंग टोकन—बड़ी मात्रा में निकालने की कोशिशों के खिलाफ सुरक्षा मजबूत की है और निकाली गई जानकारी की मात्रा 90–99% घटाई है। कंपनी के अनुसार, तर्क-संबंधी जानकारी तक पहुंच सीमित करने के साथ-साथ उसने निष्कर्षण के संकेत पहचानने वाला एक वर्गीकारक सक्रिय किया है और संबंधित खातों को अपने-आप निलंबित करने की व्यवस्था लागू की है। अब तक ऐसे निलंबित खातों की संख्या हजारों के कई दर्जन तक पहुंच चुकी है।
Claude तक बड़े पैमाने पर पहुंच को कैसे रोका जाए
इसका आधार ‘डिस्टिलेशन’ है—एक ऐसी विधि जिसमें शक्तिशाली AI मॉडल के आउटपुट को प्रशिक्षण सामग्री बनाकर उससे एक छोटा, अलग मॉडल प्रशिक्षित किया जाता है। आम तौर पर यह अपनी कंपनी के मॉडल को हल्का बनाने की एक वैध तकनीक है। लेकिन इसका इस्तेमाल दूसरी कंपनियों के मॉडल से बड़े पैमाने पर सवाल पूछकर और उनके जवाबों से उनकी क्षमताओं की हूबहू नकल करने के लिए भी किया जा सकता है। Anthropic को इस तरह के संगठित निष्कर्षण पर आपत्ति है।
कंपनी के मुताबिक, हमलावर कई लाख नकली खातों के नेटवर्क का इस्तेमाल कर रहे हैं। हर खाते की गतिविधि इस तरह सीमित रखी जाती है कि वह सामान्य उपयोगकर्ता जैसा दिखे, जबकि सभी खाते मिलकर भारी मात्रा में जवाब जुटाते हैं। इसे मानव-लहर रणनीति नहीं, बल्कि ‘अकाउंट-लहर रणनीति’ कहने का मन होता है।
निशाना रीजनिंग टोकन हैं—यानी जवाब तक पहुंचने से पहले मॉडल जिन आंतरिक सोच-चरणों से गुजरता है। केवल अंतिम जवाब ही नहीं, बल्कि सोचने का पूरा तरीका हाथ लग जाए तो किसी दूसरे मॉडल को यह सिखाया जा सकता है कि ‘कैसे सोचना है’। इसे खाना पकाने से जोड़कर कहें तो यह सिर्फ तैयार पकवान के स्वाद की नकल करने जैसा नहीं, बल्कि उसकी पूरी रेसिपी साथ ले जाने जैसा है।
Anthropic ने मुख्य रूप से तीन कदम उठाए हैं: Claude के आंतरिक तर्क-चरणों तक पहुंच सीमित करना, निष्कर्षण की कोशिशों का पता लगाने वाला वर्गीकारक चलाना और संदिग्ध पाए गए खातों को अपने-आप निलंबित करना।
आंकड़ों से दिखता असर और उपायों की सीमाएं
Anthropic के मुताबिक, सुरक्षा उपाय लागू होने के बाद निकाले गए रीजनिंग टोकन की मात्रा 90–99% घट गई। कंपनी ने यह भी बताया कि उपाय शुरू होने के बाद डिस्टिलेशन के सफल मामलों में भारी गिरावट आई। आंकड़े एक दायरा बताते हैं, लेकिन कंपनी का दावा है कि निष्कर्षण को कम-से-कम मूल मात्रा के दसवें हिस्से से भी नीचे लाया गया।
एक और अहम बात वह दुष्प्रभाव है जिसे कंपनी खुद स्वीकार करती है: वैध उपयोगकर्ता भी कभी-कभी पहचान प्रणाली की चपेट में आ सकते हैं। अनधिकृत गतिविधि रोकने का जाल जितना बारीक बुना जाएगा, सामान्य उपयोगकर्ता और कंपनियां भी उसमें फंस सकती हैं। सुरक्षा उपायों से जुड़ी यह पुरानी समस्या AI सेवाओं में भी बनी हुई है।
बड़े पैमाने पर सेवा इस्तेमाल करने वाले डेवलपरों या स्वचालन उपकरणों से जुड़े कारोबारी सिस्टम का व्यवहार कभी-कभी निष्कर्षण के संकेतों जैसा दिख सकता है। आगे चलकर अनधिकृत गतिविधियों को रोकने की सख्ती और सामान्य उपयोग में बाधा न आने देने के बीच संतुलन ही सेवाओं के इस्तेमाल को आसान या मुश्किल बनाएगा।
कंपनियों के नाम लेकर लगाए गए आरोपों का क्या मतलब है
इस बार Anthropic ने चीनी कंपनियों Zhipu (智譜) और Moonshot का नाम इसमें शामिल पक्षों के तौर पर लिया। कंपनी के आरोप के अनुसार, Zhipu ने अमेरिका के प्रमुख मॉडलों से साइबर-संबंधी क्षमताएं हासिल कीं और उनका इस्तेमाल अपने GLM-5.3 के लिए किया। Anthropic ने Moonshot पर Claude से पूछे गए सवालों को गुप्त रूप से उसके जरिए भेजने का आरोप लगाया। ये सभी Anthropic के दावे हैं; इस सामग्री में दोनों कंपनियों का पक्ष उपलब्ध नहीं है।
Anthropic ने यह भी कहा कि इस तरह हासिल की गई क्षमताएं विदेशी सैन्य और निगरानी प्रणालियों तक पहुंच सकती हैं। यह बात ध्यान खींचती है कि कंपनी इसे केवल कारोबारी नकल नहीं, बल्कि राष्ट्रीय सुरक्षा का मुद्दा मान रही है।
एक और कदम के तौर पर कंपनी ने अन्य AI डेवलपरों से भी इसी तरह के सुरक्षा उपाय अपनाने की अपील की है। वजह यह है कि अगर सिर्फ एक कंपनी अपने दरवाजे पर सुरक्षा कड़ी करे और जानकारी किसी दूसरे रास्ते से निकाल ली जाए, तो उसका असर सीमित रहेगा। अब सवाल है कि क्या पूरा उद्योग एकजुट होकर ऐसे कदम उठा पाएगा।
जनरेटिव AI की प्रतिस्पर्धा अब सिर्फ बेहतर मॉडल बनाने की होड़ तक सीमित नहीं है। यह इस बात की पहचान और नियंत्रण की होड़ भी बनती जा रही है कि मॉडल का इस्तेमाल कौन और किस तरह कर रहा है। नकली खातों का पता लगाने और पहुंच सीमित करने जैसी साधारण दिखने वाली सुरक्षा तकनीकें आने वाले समय में AI कंपनियों की प्रतिस्पर्धी क्षमता तय करने में अधिक अहम हो सकती हैं।








コメント