
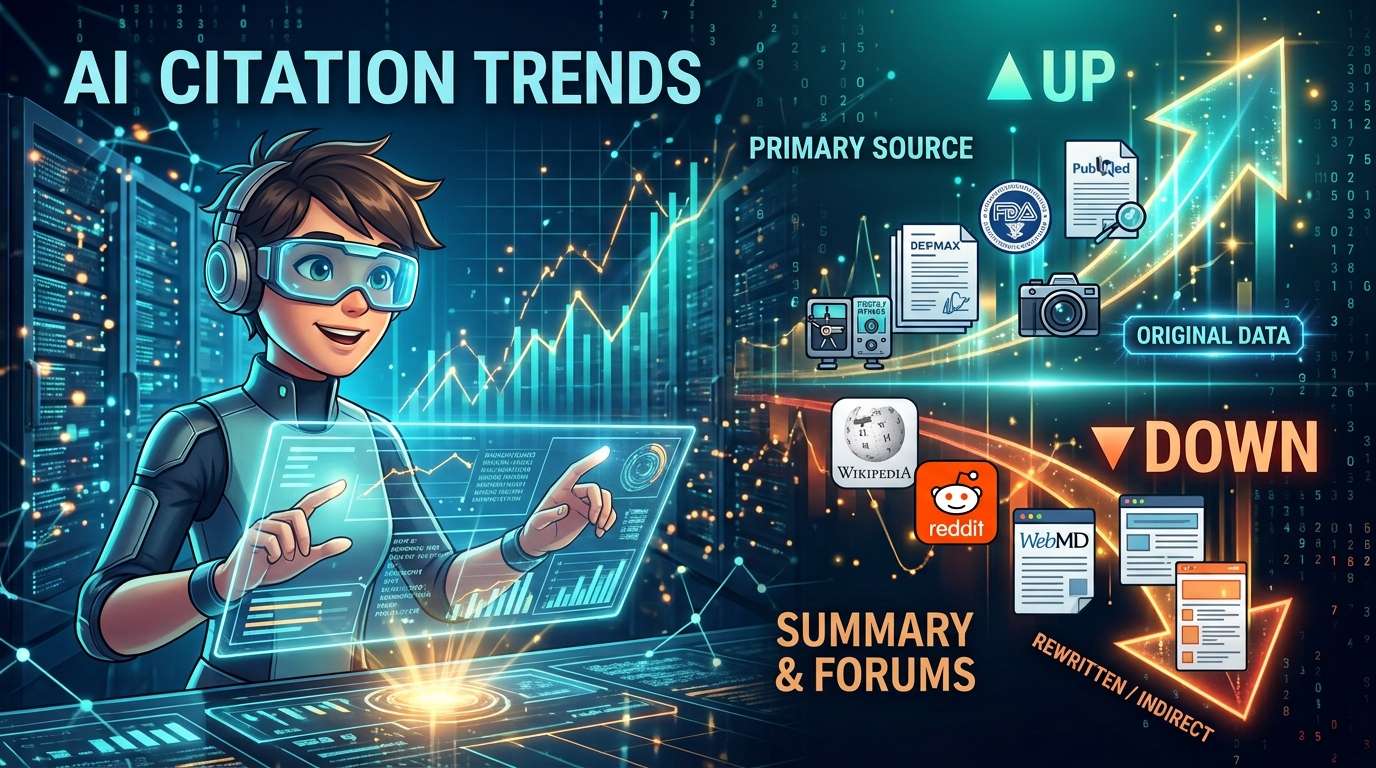
SEO टूल बनाने वाली Ahrefs ने ChatGPT के अमेरिका के लिए दिए गए जवाबों में उद्धृत डोमेन की रैंकिंग में हुए बदलाव प्रकाशित किए हैं। मार्च और सितंबर की तुलना में, मेडिकल शोध-पत्रों के डेटाबेस PubMed की रैंकिंग 64वें स्थान से बढ़कर चौथे स्थान पर आ गई, जबकि स्वास्थ्य-सूचना साइट WebMD 18वें स्थान से गिरकर 79वें पर पहुंच गई। शोध-डेटा और वास्तविक उत्पाद-परीक्षण जैसी मूल जानकारी रखने वाली साइटें शीर्ष पर आई हैं।
शोध-पत्र डेटाबेस में उछाल, जानकारी समझाने वाली साइटें पीछे
इस विश्लेषण में ChatGPT के अमेरिका के लिए दिए गए जवाबों में सबसे अधिक उद्धृत 200 डोमेन शामिल थे। मार्च के करीब 24 लाख और सितंबर के करीब 38 लाख जवाबों के आधार पर यह आंकड़ा तैयार किया गया।
रैंकिंग में आगे बढ़ने वालों में PubMed के अलावा सरकारी स्वास्थ्य और शोध संस्थान, नियामक प्राधिकरण तथा ऐसे परीक्षण साइटें प्रमुख थीं जो उत्पादों को खुद आजमाकर उनका मूल्यांकन करती हैं। उदाहरण के तौर पर FDA और RTINGS का उल्लेख किया गया है।
इसके उलट, शोध को सरल भाषा में समझाने वाली WebMD और Verywell Health के साथ-साथ Healthline और Investopedia जैसी स्वास्थ्य और वित्तीय जानकारी देने वाली साइटों की रैंकिंग गिरी। Britannica, Investopedia और New York Post शीर्ष 200 से बाहर हो गए।
Ahrefs का कहना है कि ऐसा लगता है कि ChatGPT जानकारी का सार बताने वाली साइटों के बजाय मूल स्रोतों को प्राथमिकता दे रहा है।
क्या अब ‘सार बताने वालों’ के बजाय ‘जानकारी के मालिक’ चुने जा रहे हैं?
स्वास्थ्य और वित्त से जुड़े व्याख्यात्मक लेख ऐसे क्षेत्र रहे हैं जिनमें खोज इंजनों पर अच्छा प्रदर्शन होता था। इनका काम शोध-पत्रों और सरकारी दस्तावेजों को समझकर आसान भाषा में पेश करना रहा है। लेकिन AI के जवाब तैयार करने के चरण में, ‘आसान भाषा में समझाने’ का काम AI खुद कर लेता है। ऐसे में यह स्वाभाविक लगता है कि AI समझाने वाले के बजाय मूल स्रोत को देखना चाहेगा।
एक और खास बात उत्पाद-परीक्षण साइटों का आगे आना है। केवल स्पेसिफिकेशन की तालिका को नए क्रम में पेश करने वाले लेखों से अलग, वास्तविक माप के आंकड़े और इस्तेमाल का अनुभव ऐसी बातें हैं जिन्हें सिर्फ वही साइट लिख सकती है। AI द्वारा उद्धृत किए जाने की शर्त शायद इस बात के करीब पहुंच रही है कि सामग्री कितनी मौलिक है।
Ahrefs ने साइट संचालकों को भी ऐसी सामग्री पर ध्यान देने की सलाह दी है जिसे सिर्फ वे ही बना सकते हैं। इनमें खास तौर पर मौलिक शोध, वास्तविक उत्पाद-परीक्षण और अपने उत्पादों की जानकारी शामिल हैं।
Reddit और Wikipedia के उद्धरणों का अनुपात काफी गिरा
अमेरिका के लिए दिए गए जवाबों में Reddit का उल्लेख करने वाले जवाबों का अनुपात मार्च के 19.1% से घटकर सितंबर में 2.3% रह गया। Wikipedia के लिए भी यह 14.1% से गिरकर 2.9% हो गया। फिर भी, Ahrefs के मुताबिक दोनों अब भी उन डोमेन में शामिल हैं जिन्हें ChatGPT अक्सर उद्धृत करता है।
Reddit के मामले में, एक अन्य विश्लेषण टूल Promptwatch ने अगस्त में इसी तरह की गिरावट दिखाई थी। ChatGPT Search के उद्धरणों में reddit.com का हिस्सा जुलाई के आखिरी और अगस्त के शुरुआती दिनों के औसत 3.83% से घटकर अगस्त के मध्य में 0.52% हो गया था। हालांकि, Ahrefs ‘Reddit का हवाला देने वाले जवाबों का अनुपात’ देखता है, इसलिए उसका माप Promptwatch से अलग है।
दुनिया भर के एक अलग नमूने में, ChatGPT ने site: सर्च (किसी खास साइट तक सीमित खोज) में जिन डोमेन को सबसे अधिक निर्दिष्ट किया, उनमें reddit.com नौवें स्थान पर था। इसका मतलब है कि उद्धरणों का अनुपात घटने के बाद भी खोज के दौरान Reddit की मौजूदगी बनी हुई है।
उद्धरणों की रैंकिंग और साइट पर आने वाले लोगों की संख्या अलग बातें हैं
यह ध्यान रखना जरूरी है कि यह रैंकिंग उद्धरणों की आवृत्ति बताती है, साइट पर आने वाले लोगों की संख्या नहीं। रैंकिंग गिरने का अर्थ यह नहीं कि साइट पर आने वाला ट्रैफिक भी उतना ही घटा है। इसी तरह, शीर्ष पर पहुंचने के बावजूद यह अलग बात है कि लोग उस साइट पर क्लिक करके उसे पढ़ते हैं या नहीं।
इसके अलावा, Ahrefs का ट्रैकिंग सिस्टम समय के साथ जांचे जाने वाले सवाल जोड़ता रहता है, इसलिए रैंकिंग में बदलाव सवालों के बदलने से भी हो सकता है। इसी वजह से कंपनी ने करीब 25,000 ऐसे सवालों की तुलना की जो मार्च और सितंबर, दोनों में सबसे अधिक पूछे जाने वाले शीर्ष 150,000 सवालों में शामिल थे। कंपनी के मुताबिक, इस तुलना में चार्ट में शामिल सभी साइटों की रैंकिंग एक ही दिशा में बदली।
हकीकत: ज्यादातर जवाबों में खोज नहीं होती
एक अन्य अध्ययन में देखा गया कि ChatGPT कितनी बार वेब पर खोज करता है। अगस्त और सितंबर में मुफ्त और लॉग इन न करने वाले उपयोगकर्ताओं के 6.66 करोड़ जवाबों में से 14.4% में वेब सर्च शामिल थी। इसमें GPT-5.6 Luna मॉडल और दुनिया भर का डेटा शामिल था।
जिन जवाबों में खोज की गई, उनमें जवाब देने से पहले पर्दे के पीछे औसतन करीब 1.6 सर्च हुईं। 1.5 करोड़ फैन-आउट में से 6.8% site: सर्च थीं, जो किसी खास साइट तक सीमित रहती हैं; इनका दायरा 1.16 लाख डोमेन तक था। सबसे अधिक खोजे गए करीब 160 डोमेन तक सीमित करने पर, 75.9% सर्च Apple या IKEA जैसी कंपनियों की आधिकारिक साइटों पर की गई थीं।
एक अन्य शोध कंपनी Nectiv ने API के जरिए GPT-5.6 Sol पर करीब 4,000 सवालों को प्रोसेस किया और प्रति सवाल औसतन 7.61 फैन-आउट पाए। हालांकि, मॉडल, सवालों और डेटा जुटाने के तरीकों में अंतर के कारण इसकी 1.6 से सीधी तुलना नहीं की जा सकती। Ahrefs का कहना है कि मुफ्त और लॉग इन न करने वाले उपयोगकर्ता, सशुल्क मॉडल या रीजनिंग मॉडल की तुलना में कम बार खोज करते हैं; यह भी अंतर का एक कारण है।
साइट संचालक किन बातों की पुष्टि करना चाहेंगे
Ahrefs के आंकड़े अगस्त से सितंबर के बीच हासिल किए गए एक ही मॉडल के स्नैपशॉट पर आधारित हैं। कंपनी ने यह भी कहा है कि भविष्य में मॉडल अपडेट होने पर रुझान बदल सकते हैं।
इसलिए वेबसाइट संचालकों के लिए व्यावहारिक कदम यह है कि वे नियमित रूप से जाँचें कि उनके प्रमुख विषयों पर ChatGPT किन पेजों का हवाला देता है और उनकी जगह किन स्रोतों को चुनता है। यदि व्याख्यात्मक लेख ही ट्रैफ़िक जुटाने का मुख्य साधन हैं, तो OpenAI के हर मॉडल अपडेट के बाद उनकी समीक्षा करना उपयोगी होगा।








コメント