
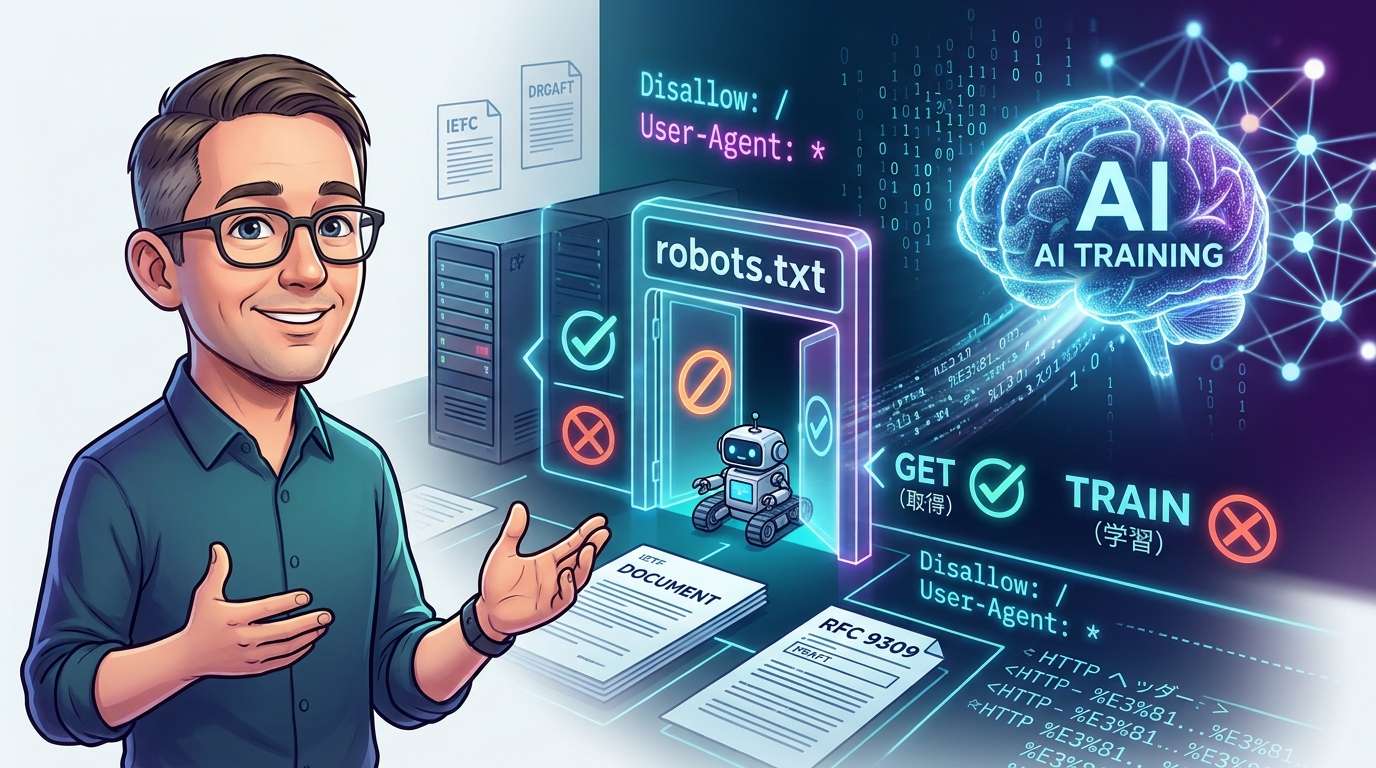
Google के Gary Illyes ने Search Central की वीडियो शृंखला “The Non-Canonical Cabinet” की दूसरी कड़ी में बताया कि मानक RFC 9309 के तहत robots.txt यह तय करता है कि क्रॉलर किन URL को प्राप्त कर सकता है, लेकिन डेटा प्राप्त होने के बाद उसका इस्तेमाल कैसे किया जाए, यह तय नहीं करता। उन्होंने कहा कि किसी खास AI क्रॉलर को रोकना हो तो उस क्रॉलर के यूज़र एजेंट का नाम स्पष्ट रूप से लिखना होगा।
“पहुंच रोकना” और “प्रशिक्षण में इस्तेमाल न करना” अलग बातें हैं
“robots.txt में AI प्रशिक्षण पर रोक लिख दी है, तो चिंता की बात नहीं।” ऐसा मानना धीरे-धीरे आम होता दिख रहा है। लेकिन Illyes की व्याख्या के मुताबिक, मामला इतना सीधा नहीं है। robots.txt किसी वेबसाइट के प्रवेश-द्वार पर लगे उस संकेत-पट्ट जैसा है, जो बताता है, “इस दरवाज़े से अंदर आ सकते हैं।” अंदर आने वाला व्यक्ति अपने साथ ले गई जानकारी का कैसे इस्तेमाल करता है, यह उस संकेत-पट्ट के दायरे में नहीं आता।
Illyes ने RFC 9309 में परिभाषित robots.txt को “पहुंच संबंधी इच्छाएं बताने वाला प्रोटोकॉल” बताया और कहा कि यह निर्देश नहीं दे सकता कि कोई सिस्टम क्रॉल किए गए डेटा का इस्तेमाल कैसे करे। वीडियो में पूछा गया था कि क्या AI को क्रॉल करने की अनुमति देते हुए उसी जानकारी को जनरेटिव AI मॉडल के प्रशिक्षण में इस्तेमाल होने से रोका जा सकता है। इसका जवाब है कि robots.txt अकेले इन दोनों में अंतर नहीं कर सकता।
robots.txt सिर्फ पहुंच तय करता है
Google के विनिर्देश पृष्ठ पर उसकी ओर से समर्थित चार निर्देश दिए गए हैं: User-Agent, Allow, Disallow और Sitemap। इनके अलावा की पंक्तियां अमान्य मानी जाती हैं और अनदेखी कर दी जाती हैं। वीडियो में “No-AI-Chicken-Training” नाम का एक काल्पनिक निर्देश दिखाया गया, लेकिन Google का पार्सर ऐसी कस्टम पंक्तियों को नहीं पढ़ता।
RFC 9309 के खंड 2.2.4 में विनिर्देश के दायरे से बाहर के रिकॉर्ड को कैसे संभालना है, यह क्रॉलर पर छोड़ दिया गया है। यानी अपनी ओर से कोई पंक्ति जोड़ने पर उस पर अमल करना है या नहीं, यह दूसरी पार्टी पर निर्भर करता है। वह काम कर भी सकती है और नहीं भी। कम से कम, यह “मानक के तहत सुनिश्चित प्रतिबद्धता” नहीं है।
व्यावहारिक तौर पर भरोसेमंद तरीका यह है कि जिस AI क्रॉलर को रोकना है, उसके यूज़र एजेंट को अलग से निर्दिष्ट करें और Disallow के जरिए उसकी पहुंच रोक दें। Illyes ने कहा कि अगर पूरी साइट को रोकना है, तो संबंधित टोकन को स्पष्ट रूप से लिखना होगा।
Google-Extended, Google का अपना उपयोग-नियंत्रण
तो Google के AI के लिए इस्तेमाल होने वाले Google-Extended की क्या भूमिका है? यह robots.txt का ऐसा टोकन है जिसका अपना अलग यूज़र एजेंट नहीं है; Google अपने मौजूदा क्रॉलर से ही साइटों को क्रॉल करता है। कंपनी की क्रॉलर सूची में बताया गया है कि यह टोकन “नियंत्रण” की भूमिका में इस्तेमाल होता है।
इससे यह नियंत्रित किया जा सकता है कि Google प्राप्त की गई सामग्री का इस्तेमाल भविष्य के Gemini मॉडल को प्रशिक्षित करने के लिए करे या नहीं, और Gemini Apps अथवा Vertex AI पर Grounding with Google Search में ग्राउंडिंग के लिए करे या नहीं। ग्राउंडिंग का अर्थ है उत्तर के समर्थन में जानकारी का संदर्भ लेना। इसका Google Search में शामिल होने पर कोई असर नहीं पड़ता और यह खोज-रैंकिंग का संकेत भी नहीं है।
यह ध्यान रखना जरूरी है कि “उपयोग का नियंत्रण” वाला यह अर्थ RFC 9309 से नहीं, बल्कि Google ने अपने उत्पादों के दस्तावेज़ों में तय किया है। यह robots.txt का ऐसा साझा नियम नहीं है जो दूसरी कंपनियों के AI पर भी लागू हो। इसे Google के लिए बने एक खास स्विच के रूप में समझना उचित होगा।
उपयोग के उद्देश्य बताने का मानकीकरण प्रस्ताव अभी मसौदा है
क्या क्रॉल करने की अनुमति और प्राप्त सामग्री के इस्तेमाल की इच्छा को अलग-अलग बताने का कोई तरीका हो सकता है? इस समस्या पर काम भी हो रहा है। Illyes, Mozilla के Martin Thomson के साथ मिलकर IETF का एक इंटरनेट ड्राफ्ट लिख रहे हैं। 19 अगस्त का मौजूदा संस्करण robots.txt में “Content-Usage” नियम और उससे संबंधित HTTP हेडर जोड़कर RFC 9309 को अपडेट करने का प्रस्ताव रखता है।
भूमिकाओं का बंटवारा स्पष्ट है। Allow और Disallow पहले की तरह यह तय करते हैं कि किन URL को क्रॉल किया जा सकता है, जबकि Content-Usage यह बताता है कि प्राप्त सामग्री का इस्तेमाल किस तरह किया जाए, यह आपकी इच्छा है। यह इच्छा सिर्फ उन पाथ पर लागू होती है जिन्हें क्रॉलर को प्राप्त करने की अनुमति है। ड्राफ्ट के उदाहरण में, क्रॉल की अनुमति देने वाले robots.txt में Content-Usage का “train-ai=n” विवरण जोड़ा गया है।
हालांकि, अभी यह कार्यसमूह के दस्तावेज़ के चरण में है। IETF Datatracker के रिकॉर्ड के मुताबिक, IESG (इंटरनेट तकनीकी मानकीकरण की जिम्मेदारी निभाने वाला संचालन समूह) को समीक्षा के लिए दस्तावेज़ अभी तक नहीं भेजा गया है और कार्यसमूह की ओर से इसे भेजने की योजना अगस्त 2026 की है। “train-ai” लेबल एक अलग शब्दावली ड्राफ्ट (14 सितंबर की तारीख वाला) में आता है, लेकिन उसमें स्पष्ट कहा गया है कि यह कार्यसमूह के भीतर बनी सहमति को नहीं दर्शाता। मौजूदा ड्राफ्ट की वैधता 20 फरवरी 2027 तक है; उससे पहले संशोधित संस्करण आया तो वह इसकी जगह लेगा।
यानी, प्रशिक्षण में इस्तेमाल की इच्छा को क्रॉलर की अनुमति से अलग बताने का मानक तरीका फिलहाल मसौदे तक ही सीमित है। इसे पहले से लागू साझा नियम मानना जल्दबाज़ी होगी।
जापानी URL को प्रतिशत-एन्कोड करना सुरक्षित है
इस कड़ी में AI के अलावा व्यावहारिक विषयों पर भी चर्चा हुई। Google की चेरी प्रोमाविन ने सलाह दी कि robots.txt में अंग्रेज़ी के अलावा अन्य लिपियों के अक्षरों या इमोजी वाले पाथ लिखते समय “एन्कोड किए गए रूप का इस्तेमाल करना चाहिए।” Google का पार्सर मूल अक्षरों को एन्कोड करके संसाधित कर सकता है, लेकिन इससे दूसरे या पुराने क्रॉलर भ्रमित हो सकते हैं।
वीडियो में इमोजी को सीधे लिखने वाले उदाहरण पर “Google में काम करता है, लेकिन अन्य जगहों पर टूट सकता है” और पर्सेंट-एन्कोड किए गए उदाहरण पर “सुरक्षित और मानक तरीका” लिखा था। Google के स्पेसिफिकेशन पेज के मुताबिक, उसका पार्सर मूल UTF-8 और पर्सेंट-एन्कोडिंग को एक ही तरह से मानता है। RFC 9309 का व्याकरण भी पाथ में UTF-8 अक्षरों की अनुमति देता है, लेकिन यह ज़रूरी नहीं कि दूसरी कंपनियों के क्रॉलर भी उनकी व्याख्या इसी तरह करें।
कई साइटें अपने URL में जापानी डायरेक्टरी और पेज के नाम इस्तेमाल करती हैं। अगर AI क्रॉलर को अलग-अलग नियंत्रित करने की कोशिश कर रहे हैं, तो पाथ लिखने के तरीके पर भी ध्यान देना चाहिए।
साइट संचालक अभी क्या कर सकते हैं
संक्षेप में, अगर AI के इस्तेमाल को सीमित रखते हुए Google Search में अपनी साइट की दृश्यता बनाए रखनी है, तो उठाए जाने वाले कदम संबंधित बॉट या उत्पाद के अनुसार अलग-अलग होंगे। किसी खास AI क्रॉलर को यूज़र एजेंट बताकर Disallow निर्देश देने से पेजों तक उसकी पहुंच रोकी जा सकती है। Gemini के लिए Google ने आधिकारिक तौर पर Google-Extended को नियंत्रण के रूप में बताया है, जो प्रशिक्षण और ग्राउंडिंग—दोनों पर लागू होता है।
क्रॉलिंग की अनुमति देते हुए केवल प्रशिक्षण से इनकार करने का कोई साझा तरीका अभी सिर्फ़ मसौदे में है। अब वह दौर नहीं रहा जब robots.txt की एक पंक्ति से सब कुछ तय हो जाता था; फिलहाल हर क्रॉलर के आधिकारिक दस्तावेज़ जांचना ज़रूरी है। मानकीकरण आगे बढ़ने पर संभव है कि प्रवेश-नियंत्रण और इस्तेमाल के बारे में अपनी इच्छा जताने के लिए अलग-अलग निर्देश लिखे जा सकें।
वीडियो के विवरण में बताया गया है कि इस शृंखला की अगली कड़ी में 404 स्टेटस कोड पर चर्चा होगी।






コメント