
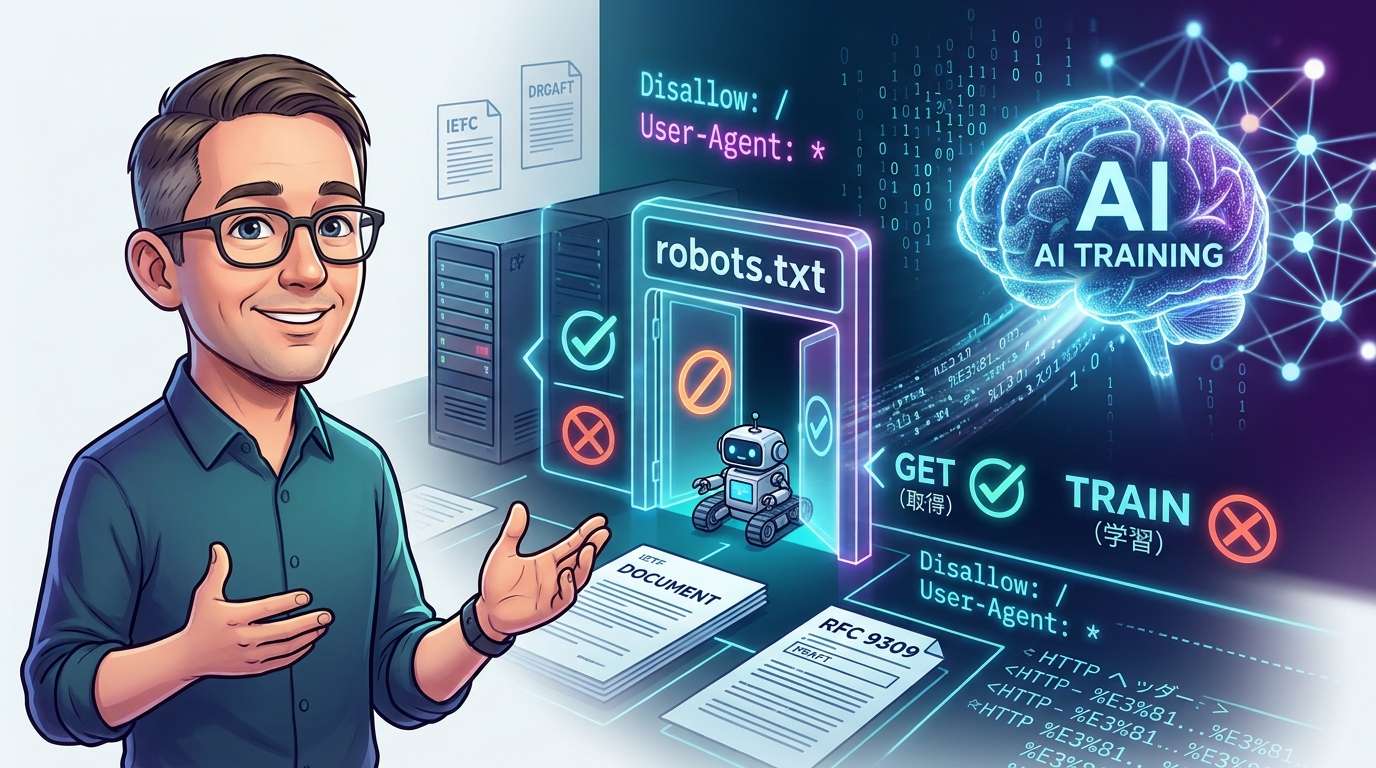
Googleのゲイリー・イリーズ氏は、Search Centralの動画シリーズ「The Non-Canonical Cabinet」の第2回で、robots.txtは標準仕様のRFC 9309上、クローラーが取得してよいURLを定めるものであり、取得後のデータの扱いまでは決めないと説明しました。特定のAIクローラーを締め出したい場合は、そのクローラーのユーザーエージェントを名指しで書く必要があるとしています。
「拒否」と「学習させない」は別の話
「robots.txtにAI学習禁止と書いておけば安心」。そんな理解が、じわりと広まっているように見えます。ところがイリーズ氏の説明に従えば、話はそう単純ではありません。robots.txtは、サイトの玄関先で「このドアから入っていいですよ」と案内する看板のようなものです。中に入った人が持ち帰った情報をどう使うかまでは、看板の守備範囲に入っていません。
イリーズ氏は、RFC 9309が定義するrobots.txtを「アクセスの希望を伝えるプロトコル」と位置づけ、クロール済みのデータをシステムがどう扱うかは指示できないという趣旨を述べました。この動画で出た質問は、AIによるクロールは許可しつつ、同じ情報を生成AIモデルの学習には使わせないという設定ができるか、というものでした。答えは、robots.txtだけではその区別はできない、ということになります。
robots.txtが決めるのはアクセスまで
Googleの仕様ページが挙げる、同社が対応する項目は4つです。User-Agent、Allow、Disallow、Sitemapで、これ以外の行は無効として無視されます。動画では「No-AI-Chicken-Training」という架空の指示が画面に映されましたが、こうした独自の行はGoogleのパーサーには読まれません。
RFC 9309の2.2.4節は、仕様の範囲外のレコードをどう処理するかをクローラー側の判断に委ねています。つまり独自の行を書き足しても、それに応じるかどうかは相手次第です。効くかもしれないし、効かないかもしれない。少なくとも「標準で守られる約束」ではありません。
実務で確実なのは、止めたいAIクローラーのユーザーエージェントを個別に指定し、Disallowでアクセス自体を断る方法です。サイト全体を拒否したいなら、対象のトークンを明示的に書く必要があるとイリーズ氏は述べています。
Google-ExtendedはGoogle独自の利用制御
では、GoogleのAI向けに使われるGoogle-Extendedはどう位置づけられるのでしょうか。これは独立したユーザーエージェントを持たないrobots.txtのトークンで、Googleは既存のクローラーを使って巡回します。同社のクローラー一覧では、このトークンは「制御の役割」で使われると説明されています。
管理の対象は、Googleが取得したコンテンツを将来のGeminiモデルの学習に使うか、Gemini Appsや、Vertex AI上のGrounding with Google Searchでのグラウンディング(回答の裏づけとなる情報の参照)に使うかどうかです。Google検索への掲載には影響せず、検索順位のシグナルでもないとされています。
ここで押さえておきたいのは、この「利用の制御」という意味はRFC 9309ではなく、Googleが自社製品のドキュメントで定めたものだという点です。robots.txtの共通ルールとして他社のAIにも通用するわけではありません。Google向けの専用スイッチと考えるのが妥当でしょう。
利用目的を示す標準化案はまだ草案
クロールの可否と、取得後の利用希望を分けて書けないのか。この課題に向けた動きもあります。イリーズ氏は、MozillaのMartin Thomson氏とともに、IETFのインターネットドラフトを共同で執筆しています。8月19日付の現行版は、robots.txtに「Content-Usage」という規則と、対応するHTTPヘッダーを加えてRFC 9309を更新する内容です。
役割分担は明快です。AllowとDisallowは従来どおりクロールできるURLを決め、Content-Usageは取得したコンテンツをどう使ってほしいかという希望を示します。この希望が対象になるのは、クローラーに取得が許可されているパスだけです。ドラフトの例では、クロールを許可するrobots.txtに「train-ai=n」というContent-Usageの記述が加えられています。
ただし、現時点では作業部会の文書という段階です。IETF Datatrackerの記録では、IESG(インターネット技術標準化を担う運営グループ)へのレビュー提出はまだ行われておらず、作業部会の送付予定は2026年8月でした。「train-ai」というラベルは別の語彙ドラフト(9月14日付)に登場しますが、そちらは作業部会内の合意を反映したものではないと明記されています。現行ドラフトの有効期限は2027年2月20日で、それまでに改訂版が出れば置き換わります。
つまり、学習への利用希望をクローラーの許可と切り離して表明する標準的な書き方は、いまのところ草案にとどまります。すでに使える共通ルールとして扱うのは早すぎます。
日本語URLはパーセントエンコードが安全
この回では、AI以外の実務的な話題も取り上げられました。Googleのチェリー・プロマウィン氏は、英語以外の文字や絵文字を含むパスをrobots.txtに書く場合は「エンコードされた形式を使うべき」と助言しています。Googleのパーサーは生の文字をエンコードして処理できますが、他のクローラーや古いクローラーでは混乱する可能性があるためです。
動画では、絵文字をそのまま書いた例に「Googleでは動くが、他では壊れるかもしれない」、パーセントエンコードした例に「安全で標準的な方法」というラベルが付けられていました。Googleの仕様ページによれば、同社のパーサーは生のUTF-8とパーセントエンコードを同じものとして扱います。RFC 9309の文法もパスにUTF-8文字を許していますが、他社のクローラーまで同じ解釈をするとは限りません。
日本語のディレクトリ名やページ名をURLに使っているサイトは少なくありません。AIクローラーを個別に制御しようとするなら、パスの書き方にも目を配っておきたいところです。
サイト運営者が今できること
整理すると、AIによる利用を制限しつつGoogle検索での見え方を保ちたい場合、取るべき手段は対象のボットや製品ごとに異なります。特定のAIクローラーには、ユーザーエージェントを指定したDisallowでページへのアクセスを止められます。Geminiについては、Googleが公式に示している制御がGoogle-Extendedで、学習とグラウンディングの両方が対象です。
一方、クロールを許可したまま学習だけを断る共通の書き方は、まだ草案の中にしかありません。robots.txtの一行で全部が決まる時代ではなく、クローラーごとの公式ドキュメントを確かめる作業が当面は欠かせません。標準化が進めば、入口の管理と利用の希望表明が別々に書ける日が来るかもしれません。
なお、シリーズの次回は404ステータスコードを扱うと動画の概要欄で案内されています。






コメント