
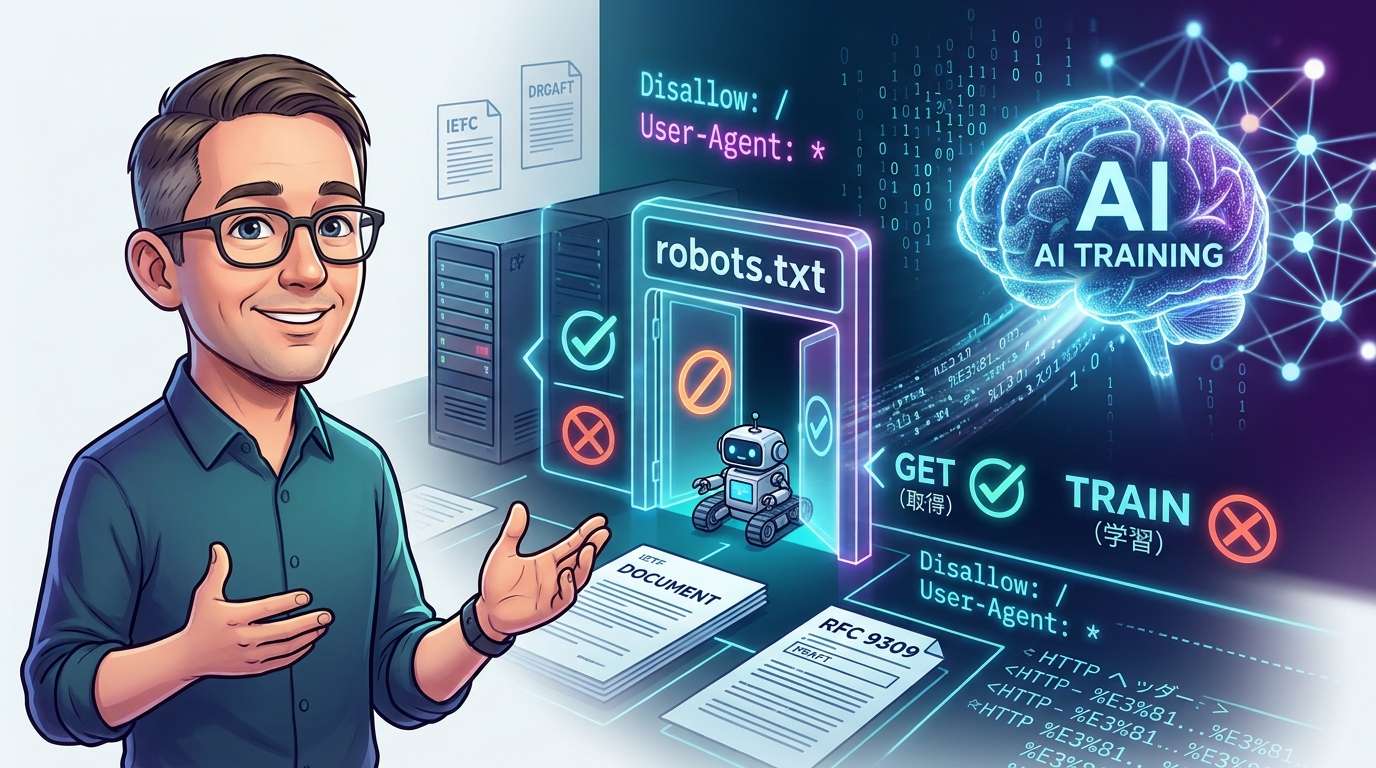
Gary Illyes, da Google, explicou no segundo episódio da série de vídeos do Search Central, «The Non-Canonical Cabinet», que, segundo a norma RFC 9309, o robots.txt define os URLs que um crawler pode obter, mas não determina o que acontece aos dados depois de obtidos. Para bloquear um crawler de IA específico, é necessário indicar explicitamente o User-Agent desse crawler.
«Recusar o acesso» e «impedir o treino» são coisas diferentes
A ideia de que «basta escrever no robots.txt que a IA não pode usar o conteúdo para treinar» parece estar a ganhar terreno. Mas, a julgar pela explicação de Illyes, a questão não é assim tão simples. O robots.txt é como um letreiro à entrada de um site que indica: «Pode entrar por esta porta». O que as pessoas fazem com a informação que levam depois de entrar já não é da competência desse letreiro.
Illyes descreveu o robots.txt definido pela RFC 9309 como um «protocolo para comunicar preferências de acesso» e explicou que não é possível dar instruções sobre o tratamento dos dados rastreados pelos sistemas. A pergunta colocada no vídeo era se seria possível permitir o rastreio por IA, mas impedir que a mesma informação fosse utilizada para treinar modelos de IA generativa. A resposta é que o robots.txt, por si só, não permite fazer essa distinção.
O robots.txt só determina o acesso
A página de especificações da Google enumera quatro diretivas suportadas pela empresa: User-Agent, Allow, Disallow e Sitemap. Qualquer outra linha é inválida e ignorada. No vídeo, surgiu no ecrã uma diretiva fictícia, «No-AI-Chicken-Training», mas o parser da Google não consegue ler este tipo de linha personalizada.
A secção 2.2.4 da RFC 9309 deixa ao critério de cada crawler o tratamento dos registos que estão fora do âmbito da especificação. Ou seja, mesmo que se acrescentem linhas personalizadas, depende do crawler em causa respeitá-las ou não. Podem funcionar, ou não. Em todo o caso, não são uma «garantia protegida pela norma».
Na prática, a forma segura de bloquear um crawler de IA é especificar individualmente o seu User-Agent e usar Disallow para impedir o próprio acesso. Illyes afirmou que, para recusar o acesso a todo o site, é necessário indicar explicitamente o token em causa.
Google-Extended é um controlo de utilização específico da Google
Qual é, então, o papel do Google-Extended, utilizado para a IA da Google? Trata-se de um token do robots.txt sem um User-Agent próprio: a Google percorre os sites com os crawlers que já utiliza. A lista de crawlers da empresa explica que este token é usado para «controlo».
O controlo abrange a utilização dos conteúdos obtidos pela Google no treino de futuros modelos Gemini e no Gemini Apps ou no Grounding with Google Search no Vertex AI (fundamentação das respostas através da consulta de informações que as sustentam). Não afeta a inclusão nos resultados da Pesquisa Google nem constitui um sinal de classificação.
Importa ter presente que este sentido de «controlo da utilização» não decorre da RFC 9309, mas sim da documentação que a Google definiu para os seus próprios produtos. Não se trata de uma regra comum do robots.txt que também se aplique às ferramentas de IA de outras empresas. O mais adequado é encará-lo como um interruptor específico para a Google.
A proposta de normalização das indicações de utilização continua em fase de rascunho
Será possível indicar separadamente se o rastreio é permitido e quais as preferências de utilização dos dados depois de obtidos? Há também iniciativas a tentar resolver esta questão. Illyes está a coescrever um Internet-Draft do IETF com Martin Thomson, da Mozilla. A versão atual, datada de 19 de agosto, propõe atualizar a RFC 9309, acrescentando ao robots.txt uma regra «Content-Usage» e o cabeçalho HTTP correspondente.
A divisão de funções é clara. Allow e Disallow continuam a determinar os URLs que podem ser rastreados, enquanto Content-Usage indica como se pretende que o conteúdo obtido seja utilizado. Esta indicação só se aplica aos caminhos que o crawler está autorizado a obter. No exemplo do rascunho, o robots.txt permite o rastreio e inclui a indicação Content-Usage «train-ai=n».
No entanto, por enquanto, trata-se apenas de um documento de um grupo de trabalho. Os registos do IETF Datatracker mostram que ainda não foi enviado para revisão pelo IESG (o grupo responsável pela normalização técnica da Internet), e que o envio pelo grupo de trabalho está previsto para agosto de 2026. O rótulo «train-ai» aparece noutro rascunho de vocabulário, datado de 14 de setembro, mas o documento salienta que este não reflete o consenso do grupo de trabalho. O rascunho atual expira a 20 de fevereiro de 2027 e será substituído se, até essa data, for publicada uma versão revista.
Assim, a forma normalizada de expressar preferências sobre a utilização dos dados para treino, separadamente da autorização de rastreio, continua por enquanto em fase de rascunho. É demasiado cedo para a tratar como uma regra comum já disponível.
Para URLs em japonês, a codificação percentual é a opção mais segura
Neste episódio, foram também abordados temas práticos não relacionados com a IA. Cherry Prommawin, da Google, aconselhou a «usar o formato codificado» ao incluir no robots.txt caminhos com caracteres não ingleses ou emojis. O parser da Google consegue codificar e processar caracteres literais, mas outros crawlers, sobretudo os mais antigos, podem ficar confusos.
No vídeo, o exemplo com um emoji escrito diretamente tinha a indicação «Funciona na Google, mas pode falhar noutros», enquanto o exemplo com codificação percentual era apresentado como «método seguro e normalizado». Segundo a página de especificações da Google, o seu parser trata o UTF-8 literal e a codificação percentual como equivalentes. A gramática da RFC 9309 também permite caracteres UTF-8 nos caminhos, mas não há garantia de que os crawlers de outras empresas os interpretem da mesma forma.
São muitos os sites que usam nomes de diretórios ou páginas em japonês nos seus URLs. Se pretende controlar individualmente os crawlers de IA, convém também prestar atenção à forma como escreve os caminhos.
O que os operadores de sites podem fazer agora
Em suma, se os operadores de sites quiserem limitar a utilização por IA e, ao mesmo tempo, preservar a forma como os seus sites aparecem na Pesquisa Google, as medidas a tomar variam consoante o bot ou produto em causa. Para crawlers de IA específicos, é possível impedir o acesso às páginas com uma diretiva Disallow que indique o agente de utilizador. No caso do Gemini, o mecanismo de controlo oficialmente indicado pela Google é o Google-Extended, que abrange tanto o treino como o grounding.
Por outro lado, ainda só existe em fase de rascunho uma forma comum de permitir o rastreio e, ao mesmo tempo, recusar apenas o treino. Já não estamos numa época em que uma única linha do robots.txt decide tudo: por enquanto, é indispensável consultar a documentação oficial de cada crawler. Com o avanço da normalização, talvez venha a ser possível definir separadamente o controlo do acesso e as preferências de utilização.
A descrição do vídeo informa que o próximo episódio da série abordará o código de estado 404.






コメント