
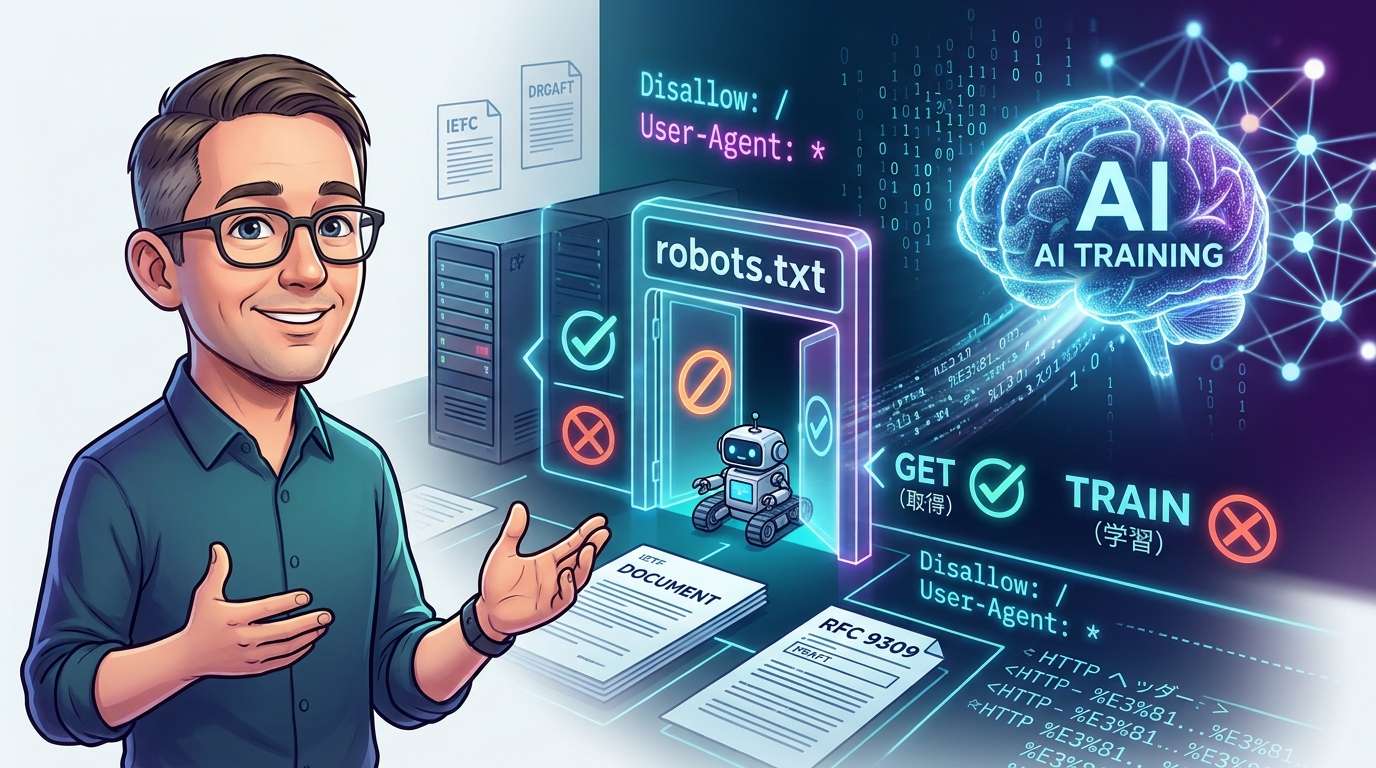
Googles Gary Illyes erklärte in der zweiten Folge der Search-Central-Videoserie „The Non-Canonical Cabinet“, dass robots.txt gemäß dem Standard RFC 9309 festlegt, welche URLs ein Crawler abrufen darf, nicht aber, was anschließend mit den abgerufenen Daten geschieht. Wer einen bestimmten KI-Crawler ausschließen möchte, muss den User-Agent dieses Crawlers ausdrücklich nennen.
„Zugriff verweigern“ und „nicht fürs Training verwenden“ sind zwei verschiedene Dinge
„Wenn in robots.txt steht, dass KI-Training verboten ist, ist man auf der sicheren Seite.“ Dieses Verständnis scheint sich allmählich zu verbreiten. Doch Illyes’ Erklärung zufolge ist die Sache nicht so einfach. robots.txt ist wie ein Schild am Eingang einer Website, das sagt: „Durch diese Tür dürfen Sie eintreten.“ Was jemand mit den Informationen macht, die er mitnimmt, fällt nicht mehr in den Zuständigkeitsbereich des Schildes.
Illyes bezeichnete robots.txt, wie in RFC 9309 definiert, als „Protokoll zur Mitteilung von Zugriffspräferenzen“ und erklärte sinngemäß, dass sich damit nicht vorgeben lässt, wie ein System gecrawlte Daten behandelt. Die Frage im Video lautete, ob man KI-Crawling erlauben, dieselben Informationen aber vom Training generativer KI-Modelle ausschließen könne. Die Antwort lautet: Mit robots.txt allein lässt sich diese Unterscheidung nicht treffen.
robots.txt regelt nur den Zugriff
Laut der Spezifikationsseite von Google unterstützt das Unternehmen vier Einträge: User-Agent, Allow, Disallow und Sitemap. Alle anderen Zeilen sind ungültig und werden ignoriert. Im Video war die fiktive Anweisung „No-AI-Chicken-Training“ zu sehen. Solche benutzerdefinierten Zeilen werden vom Parser von Google nicht gelesen.
Abschnitt 2.2.4 von RFC 9309 überlässt es den einzelnen Crawlern, wie sie mit Einträgen außerhalb der Spezifikation umgehen. Selbst wenn man eigene Zeilen hinzufügt, hängt es also vom jeweiligen Gegenüber ab, ob sie beachtet werden. Sie können wirken oder auch nicht. Zumindest sind sie keine „standardmäßig geschützte Zusage“.
In der Praxis ist es am zuverlässigsten, den User-Agent des jeweiligen KI-Crawlers anzugeben, den man stoppen möchte, und ihm mit Disallow den Zugriff zu verweigern. Wer eine ganze Website ausschließen möchte, muss das betreffende Token ausdrücklich nennen, erklärte Illyes.
Google-Extended ist Googles eigene Kontrolle der Datennutzung
Wie ist Google-Extended für Googles KI-Anwendungen einzuordnen? Dabei handelt es sich um ein Token für robots.txt ohne eigenen User-Agent; Google nutzt zum Crawlen seine vorhandenen Crawler. In der Liste seiner Crawler wird erklärt, dass das Token der „Steuerung“ dient.
Gesteuert wird, ob Google abgerufene Inhalte für das Training künftiger Gemini-Modelle oder für das Grounding in Gemini Apps und in Grounding with Google Search auf Vertex AI verwenden darf – also für den Abruf von Informationen, die Antworten untermauern. Die Aufnahme in die Google-Suche wird dadurch nicht beeinflusst; das Token ist auch kein Signal für das Suchranking.
Wichtig ist dabei: Diese Bedeutung von „Nutzungskontrolle“ stammt nicht aus RFC 9309, sondern aus der Dokumentation zu Googles eigenen Produkten. Als gemeinsame robots.txt-Regel gilt sie nicht automatisch auch für die KI anderer Anbieter. Am besten versteht man sie als speziellen Schalter für Google.
Standardisierungsvorschlag zur Angabe des Nutzungszwecks ist noch ein Entwurf
Lässt sich die Frage, ob Crawling erlaubt ist, getrennt von der gewünschten Nutzung der abgerufenen Inhalte angeben? Auch zu diesem Problem gibt es Bemühungen. Illyes verfasst gemeinsam mit Martin Thomson von Mozilla einen Internet-Draft für die IETF. Die aktuelle Fassung vom 19. August ergänzt RFC 9309 um eine Regel namens „Content-Usage“ und einen entsprechenden HTTP-Header.
Die Aufgaben sind klar verteilt: Allow und Disallow legen wie bisher fest, welche URLs gecrawlt werden dürfen. Content-Usage gibt an, wie die abgerufenen Inhalte nach Möglichkeit verwendet werden sollen. Diese Präferenz gilt nur für Pfade, auf die der Crawler zugreifen darf. Im Beispiel des Entwurfs wird eine robots.txt, die Crawling erlaubt, um den Content-Usage-Eintrag „train-ai=n“ ergänzt.
Derzeit handelt es sich allerdings noch um ein Dokument der Arbeitsgruppe. Aus den Aufzeichnungen des IETF Datatracker geht hervor, dass der Entwurf noch nicht zur Prüfung an die IESG (Internet Engineering Steering Group), das Leitungsgremium für die Internet-Standardisierung, übermittelt wurde. Die Arbeitsgruppe plant die Übermittlung für August 2026. Die Bezeichnung „train-ai“ findet sich in einem separaten Entwurf zu einem Vokabular vom 14. September; dort wird jedoch ausdrücklich darauf hingewiesen, dass sie keinen Konsens innerhalb der Arbeitsgruppe widerspiegelt. Der aktuelle Entwurf läuft am 20. Februar 2027 aus und wird ersetzt, falls bis dahin eine überarbeitete Fassung erscheint.
Eine standardisierte Möglichkeit, den gewünschten Einsatz fürs Training unabhängig von der Erlaubnis zum Crawling anzugeben, gibt es also vorerst nur als Entwurf. Es ist noch zu früh, sie als bereits verfügbare gemeinsame Regel zu behandeln.
Bei japanischen URLs ist Prozentkodierung sicherer
In dieser Folge kamen auch praktische Themen jenseits von KI zur Sprache. Googles Cherry Prommawin riet dazu, Pfade mit nicht-englischen Schriftzeichen oder Emojis in robots.txt in „kodierter Form“ anzugeben. Zwar kann Googles Parser rohe Zeichen kodieren und verarbeiten, andere oder ältere Crawler könnten dadurch jedoch verwirrt werden.
Im Video war das Beispiel mit einem Emoji in seiner ursprünglichen Form mit „Funktioniert bei Google, könnte anderswo aber Probleme verursachen“ beschriftet, das prozentkodierte Beispiel dagegen mit „Sichere und standardisierte Methode“. Laut Googles Spezifikationsseite behandelt der Parser des Unternehmens rohes UTF-8 und Prozentkodierung gleich. Die Grammatik von RFC 9309 erlaubt zwar UTF-8-Zeichen in Pfaden, doch andere Crawler müssen sie nicht zwangsläufig genauso interpretieren.
Viele Websites verwenden japanische Verzeichnis- oder Seitennamen in ihren URLs. Wer KI-Crawler gezielt steuern möchte, sollte daher auch auf die Schreibweise der Pfade achten.
Was Website-Betreiber jetzt tun können
Zusammengefasst: Wer die Nutzung durch KI einschränken und zugleich die Sichtbarkeit in der Google-Suche erhalten möchte, muss je nach betroffenem Bot oder Produkt unterschiedlich vorgehen. Bei bestimmten KI-Crawlern lässt sich der Zugriff auf Seiten mit einer Disallow-Regel für den jeweiligen User-Agent unterbinden. Für Gemini ist Google-Extended die von Google offiziell angegebene Steuerungsmöglichkeit; sie betrifft sowohl das Training als auch das Grounding.
Eine allgemeingültige Schreibweise, mit der sich das Training untersagen lässt, während Crawling weiterhin erlaubt bleibt, gibt es bislang nur als Entwurf. Eine einzige Zeile in robots.txt regelt nicht alles – vorerst bleibt es unerlässlich, die offiziellen Dokumentationen der einzelnen Crawler zu prüfen. Wenn die Standardisierung voranschreitet, könnte es eines Tages möglich sein, die Zugriffssteuerung und die Angaben zur gewünschten Nutzung getrennt voneinander festzulegen.
In der Videobeschreibung wird darauf hingewiesen, dass sich die nächste Folge der Serie mit dem Statuscode 404 befassen wird.






コメント