
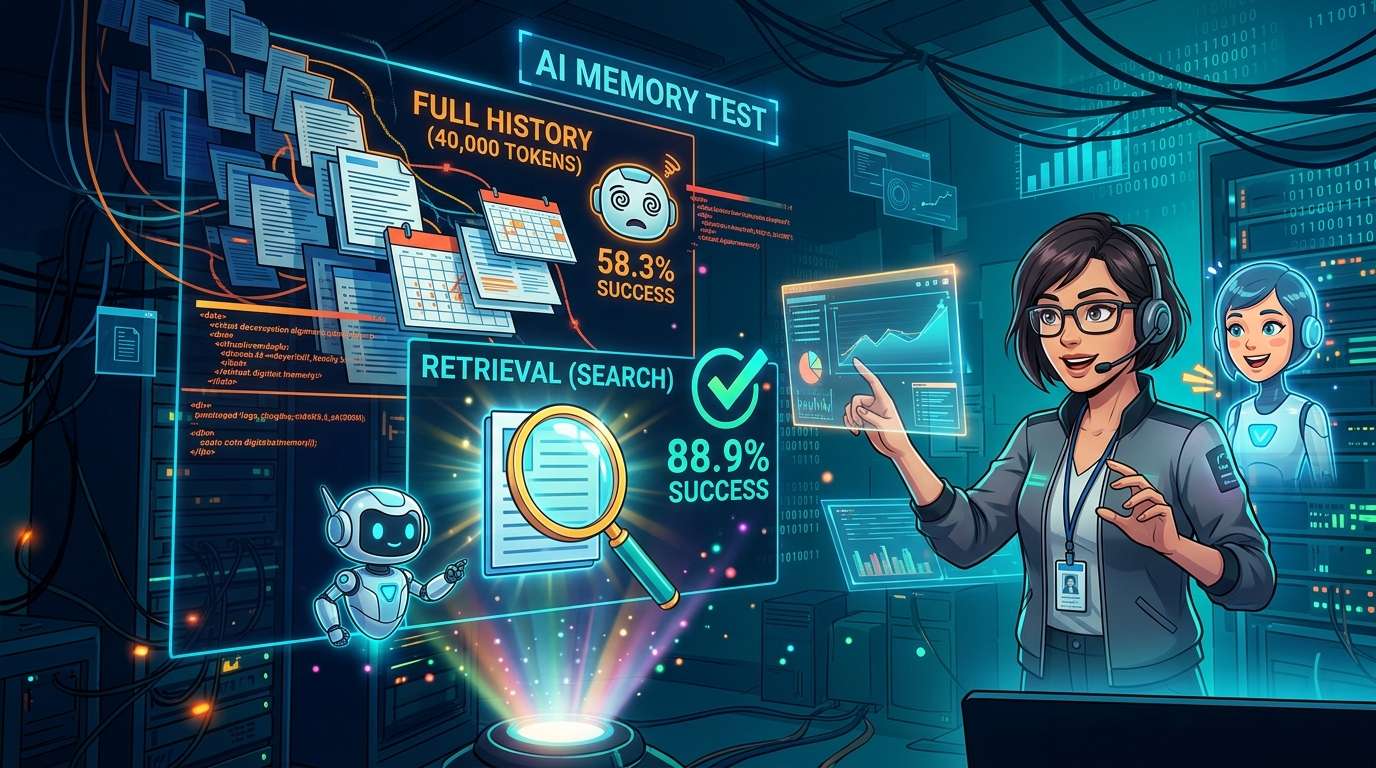
Sebuah pengujian yang membandingkan empat cara untuk memberi asisten AI “memori” dimuat di media ilmu data Towards Data Science. Dalam uji coba menggunakan riwayat sekitar 40 ribu token milik seorang manajer proyek fiktif dan 30 permintaan, tingkat keberhasilan GPT-4o mini dalam menyelesaikan tugas adalah 58.3% saat seluruh riwayat diberikan, dan 88.9% dengan metode pencarian yang hanya mengambil bagian yang diperlukan.
“Mengingat” dan “mampu menggunakan” adalah dua hal berbeda
Titik awal pengujian ini adalah DolphinBench, tes baru untuk mengukur kemampuan memori AI. Teks lengkapnya dapat dibacadi artikel pengujian ini.
Sebagian besar tes memori konvensional menanyakan fakta masa lalu secara langsung, misalnya “Di kedai kopi mana Sam suka membeli kopi?” Namun, menurut pembuat DolphinBench, pertanyaan itu sendiri menjadi petunjuk bahwa jawabannya tercatat di suatu tempat. Karena itu, tes ini meminta AI melakukan tugas—“Tolong pesan kopi”—lalu memeriksa apakah AI menggunakan fakta yang benar.
Rancangannya menggunakan riwayat percakapan sekitar 500 ribu token untuk masing-masing dari tiga tokoh fiktif, lalu memberikan 200 permintaan kepada setiap tokoh. Hasilnya harus dilaporkan bersama biaya dan waktu, bukan hanya akurasi.
Tes ini dibuat oleh perusahaan yang menjual sistem memori bernama Mem0. Dalam pengumumannya, konfigurasi perusahaan tersebut menempati posisi teratas dengan berhasil menyelesaikan 70.67% permintaan. Penulis pengujian ini tidak mereplikasi DolphinBench ataupun menguji produk perusahaan tertentu. Ia hanya mengadopsi gagasan dasarnya untuk membuat eksperimen kecil sendiri.
Empat cara mengelola memori yang diuji dengan Dana, manajer proyek fiktif
Tokoh utama eksperimen ini adalah Dana Whitfield, seorang manajer proyek fiktif. Penulis menyiapkan riwayat percakapan selama satu tahun yang terdiri dari 80 percakapan, lalu menyisipkan sejumlah jebakan di dalamnya.
Riwayat satu tahun dan 30 permintaan
Riwayat tersebut berjumlah sekitar 40 ribu token. Sebanyak 30 percakapan masing-masing menyebutkan satu fakta, seperti tempat makan siang yang biasa dikunjungi, waktu rapat, tanggal peluncuran proyek, atau orang yang bertanggung jawab. Sebelas percakapan kemudian mengubah fakta tersebut, sedangkan 39 sisanya berisi obrolan ringan tentang printer, kereta, cuaca, dan sebagainya. Percakapan sehari-hari sengaja dicampurkan agar fakta-fakta itu tidak terlalu menonjol.
Ada 30 permintaan. Masing-masing mengharuskan model memanggil salah satu alat untuk menjadwalkan rapat, memesan makanan, mengirim pesan, atau menetapkan tugas. Sembilan di antaranya membutuhkan dua fakta, seperti nama orang yang bertanggung jawab dan tanggal. Penilaian tidak melihat teks balasan, tetapi hanya memeriksa apakah nilai yang diteruskan ke alat sudah benar. Untuk setiap fakta, disiapkan pula satu pertanyaan biasa guna melihat apakah model dapat menjawab dengan nilai terbaru.
Empat metode yang dibandingkan
Ada empat metode: “tanpa memori”, yang tidak memberikan informasi apa pun; “seluruh riwayat”, yang setiap kali memberikan seluruh riwayat sebanyak 40 ribu token; “ringkasan”, yang membaca riwayat secara bertahap dan menulis ulang ringkasan sekitar 1.000 kata; serta “pencarian”, yang mengambil dan memberikan lima cuplikan riwayat paling relevan dengan permintaan.
Ibaratnya, perbedaannya adalah antara memberikan seluruh buku harian setahun setiap pagi, memberikan selembar contekan yang dirangkum seseorang, atau mengambil hanya halaman yang relevan setiap kali ada permintaan.
Model yang digunakan adalah GPT-4o mini dari OpenAI dan Claude Haiku 4.5 dari Anthropic, dengan total 1,260 kali eksekusi. Catatan seluruh eksperimen disimpan di Weights & Biases, alat untuk mengelola eksperimen.
コメント