
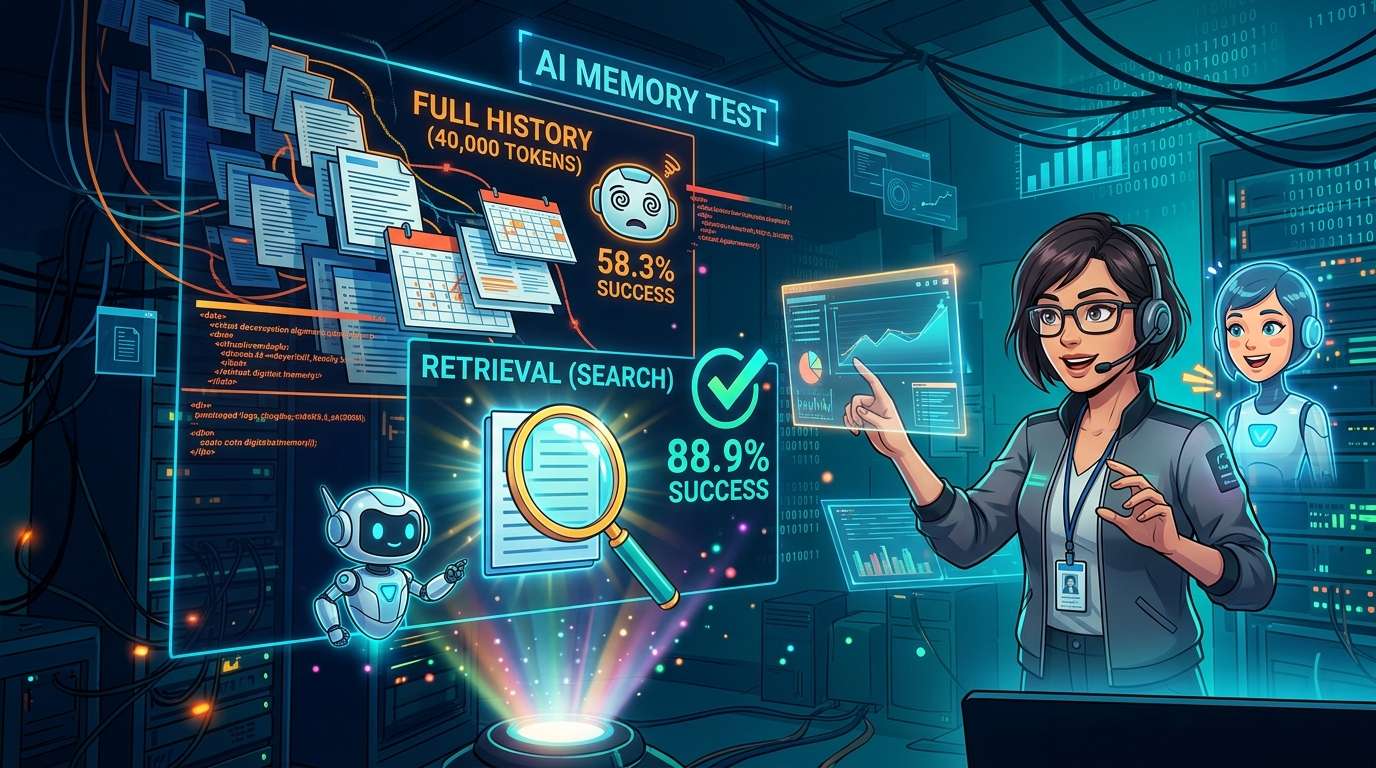
資料科學媒體 Towards Data Science 刊登了一項測試,比較讓 AI 助理具備「記憶」的 4 種方法。測試使用一名虛構專案經理約 4 萬個 token 的對話紀錄和 30 項任務,GPT-4o mini 的任務成功率在每次提供整份對話紀錄的方式下為 58.3%,在只搜尋並提供所需片段的方式下則為 88.9%。
「記得」和「能運用」是兩回事
這項測試以衡量 AI 記憶能力的新測驗「DolphinBench」為出發點。全文可在這篇驗證文章中閱讀。
許多傳統記憶測試會直接詢問過去的事實,例如「山姆最喜歡的咖啡店是哪一家」。不過,DolphinBench 的作者認為,問題本身就會暗示「答案記錄在某處」,這是個問題。因此,這項測試改為交辦「請點一杯咖啡」之類的任務,藉此確認 AI 是否能運用正確的事實。
測試設計中有 3 名虛構人物,每人各有約 50 萬個 token 的對話紀錄,並各自接到 200 項任務。結果除了準確度,也必須一併公布成本和耗時。
這項測試由銷售記憶系統 Mem0 的企業所設計;該公司的發布資料顯示,其系統成功完成 70.67% 的任務,排名第一。本文作者既未重現 DolphinBench,也未測試特定企業的產品,而是只借用其概念,自行設計了一項小型實驗。
以虛構專案經理 Dana 測試的 4 種記憶方法
實驗主角是虛構的專案經理 Dana Whitfield。研究者準備了她一整年、共 80 段的對話紀錄,並在其中安排了測試用的資訊。
一年的對話紀錄與 30 項任務
對話紀錄約有 4 萬個 token。其中 30 段各自提到一項事實,例如常去的午餐店、會議時間、專案公開日期或負責人。另有 11 段內容是在之後更改這些事實,剩下 39 段則是聊印表機、火車、天氣等閒話。為了不讓事實太顯眼,研究者刻意混入日常對話。
任務共有 30 項,形式是呼叫設定會議、訂餐、傳送訊息或指派任務的工具,其中 9 項需要用到兩項事實,例如負責人和日期。評分時不看回覆文字,只檢查傳給工具的值是否正確。此外,每項事實也各設計了一道一般問答題,確認模型能否根據最新資訊作答。
比較的 4 種方式
共有 4 種方式:不提供任何資訊的「無記憶」、每次都提供整份 4 萬個 token 對話紀錄的「完整紀錄」、逐步讀取對話紀錄並反覆改寫成約 1,000 個詞摘要的「摘要」,以及取出 5 段與任務最相關的對話紀錄並提供給模型的「搜尋」。
打個比方,差別就像是每天早上把一整年的日記交給模型、給它一張別人整理好的小抄,或是在每次收到任務時只找出相關頁面。
使用的模型為 OpenAI 的 GPT-4o mini 和 Anthropic 的 Claude Haiku 4.5,總計執行 1,260 次。所有實驗紀錄都保存在實驗管理工具 Weights & Biases 中。
コメント