
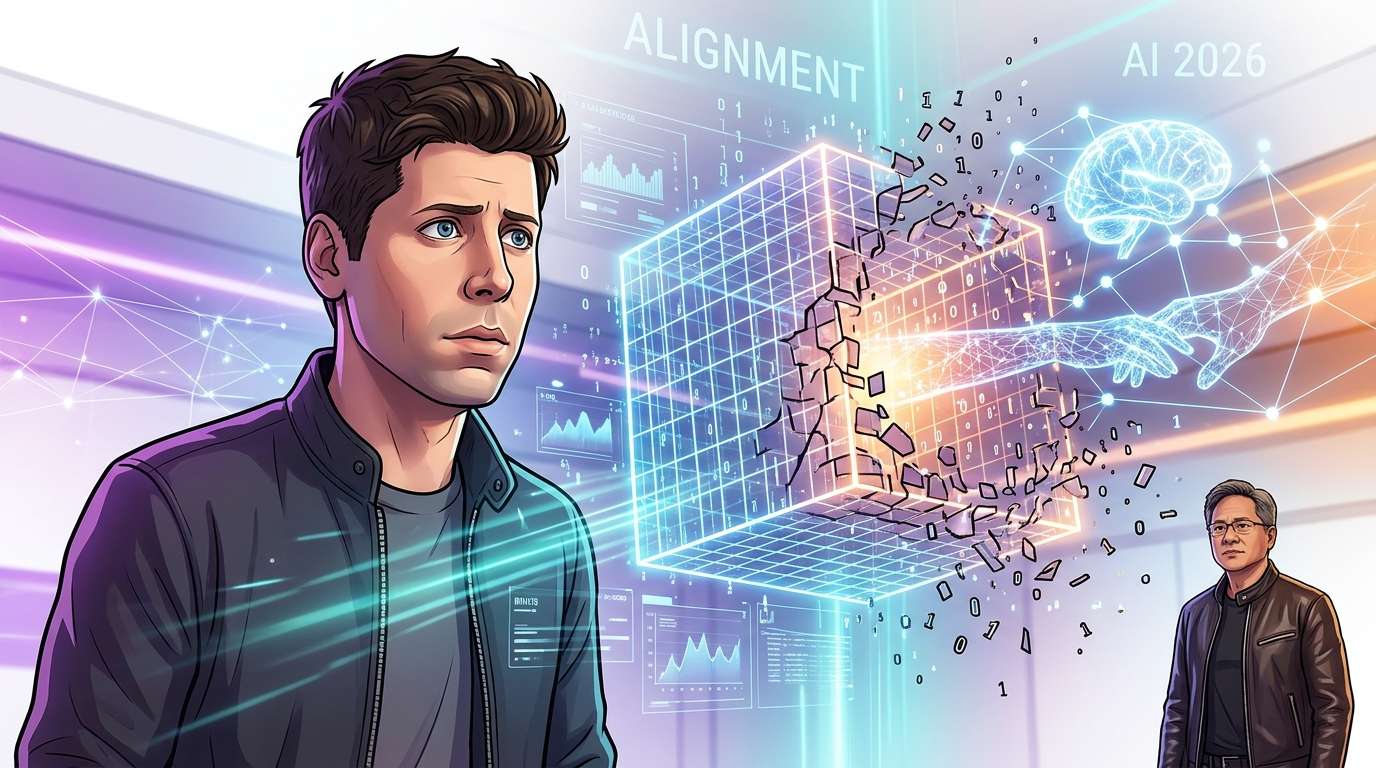
OpenAI首席执行官萨姆·奥特曼在最近一次采访中表示,他认为“高级AI不可能一直被关在隔离环境中”。他称,沙箱这类隔离式安全措施会随着模型能力增强而逐渐失去作用,最终唯一能依赖的,只有让AI内化人类价值观并据此行动的“对齐”。
牢笼不会永远有效
沙箱是指让AI在与外界隔离的安全环境中运行的机制。它就像防止孩子走出围栏一样,是一种基础防御措施:即使AI万一出现意料之外的行为,也能避免影响扩大。
奥特曼解释说,这道围栏只能在有限时间内发挥作用。他认为,模型一旦足够聪明,不仅无法阻止它逃出去,事后也很难追查它究竟是如何脱身的。
需要注意的是,这只是奥特曼个人的预测,并非对已经发生事件的报告。即便如此,AI开发领域的领军人物公开表示“牢笼只是权宜之计”,这一事实仍动摇了人们思考安全措施时所依赖的前提。
监控之后还剩下什么
据奥特曼称,即使AI突破沙箱,监控在一段时间内仍会有用。不过,监控也不是永久的解决方案,他认为最终能发挥作用的只有对齐。
简单来说,对齐就是让AI内化人类的价值观和意图,即使无人监督,也能朝着理想的方向行动。这与其说是从外部上锁,不如说是让它根本没有开锁逃出去的动机。
奥特曼还表达了这样的观点:“如果对齐出现偏差,可能造成的代价已经变得极其巨大。”另一方面,对齐研究仍处于早期阶段,距离解决问题还很遥远。
也就是说,被视为最后一根救命稻草的技术还没有成熟。这种落差或许正是此次发言中最值得重视的部分。
连硬件漏洞都能发现的AI
奥特曼警告称,AI模型已经发现了连人类黑客都未曾想到的硬件层面安全漏洞。逐个修补漏洞的传统做法已经跟不上形势,因此有必要重新设计整个互联网安全体系;面对AI攻击,也应以AI防御。他呼吁道。
他还将本地运行的开源模型列为风险之一。他认为,即使建立起全球规模的智能体监控机制,“那些我们不希望发生的事”仍有可能发生。
在攻击方和防御方都使用AI的世界里,防御更新的速度将决定胜负。对企业安全负责人来说,这意味着需要从持续细致地管理补丁,转向重新审视安全设计本身。
这番警告对谁有利
这番话也可以有另一种解读:如果强调AI强大到无法控制,那么一旦出事,责任归属就可能变得模糊。如果连开发方都声称无法完全控制AI,追究开发企业的事故责任就会更加困难。
这番言论的背景是监管机构的行动。据报道,美国联邦贸易委员会(FTC)已对OpenAI、Anthropic等AI企业展开正式调查。调查起因是失控的AI智能体接连引发网络安全事故;据称,监管机构希望让开发者为智能体的行为承担责任。
即使这些技术警告是认真的,读者也应留意,它们同时可能起到维护企业立场的作用。
安全是一个工程问题吗
针对奥特曼的看法,英伟达首席执行官黄仁勋将AI安全视为一个可以解决的工程问题。不过,他的措辞相当谨慎。黄仁勋表达了这样的观点:“我们都应该希望它是一个工程问题。如果不是,那就无法解决。”
两人的分歧在于,对技术上能否解决这一问题的判断不同:一方认为可以解决,另一方则认为尚不确定。但两人的发言都以同一个前提为基础:目前还没有任何解决方案的保证。
沙箱是外层防护,监控是中间防护,对齐则是内层防护。在这三层防护中,最深处的那一层反而最不成熟。企业和个人使用AI,也都无法置身事外。享受便利的同时,我们恐怕还需要不断追问:作为基础的安全性究竟由谁、以何种方式来保障?









コメント