
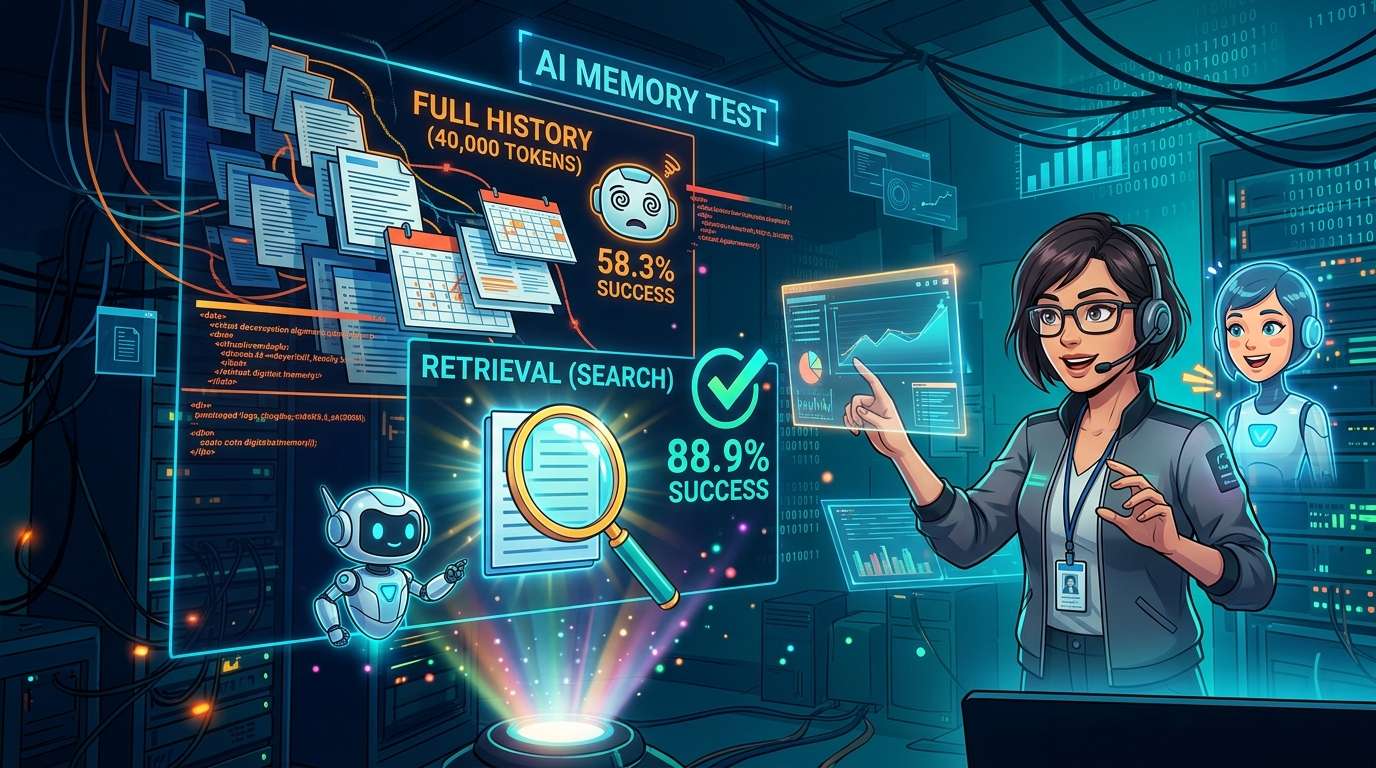
نشرت منصة Towards Data Science المتخصصة في علوم البيانات اختبارًا يقارن أربع طرق لمنح المساعدين الذكيين «ذاكرة». وفي تجربة استخدمت سجلًا من نحو 40 ألف رمز لمدير مشروع خيالي و30 طلبًا، بلغ معدل نجاح GPT-4o mini في إنجاز المهام 58.3% عند تمرير السجل كاملًا، مقابل 88.9% عند البحث عن الأجزاء اللازمة فقط وتمريرها.
«التذكّر» و«القدرة على استخدام ما نتذكّره» أمران مختلفان
ينطلق الاختبار من DolphinBench، وهو اختبار جديد لقياس قدرة الذكاء الاصطناعي على التذكّر. والنص الكامل متاح فيمقال التحقق هذا.
تطرح اختبارات الذاكرة التقليدية في كثير من الأحيان أسئلة مباشرة عن حقائق سابقة، مثل: «ما المقهى الذي يفضله سام؟». لكن مؤلفي DolphinBench يرون مشكلة في أن السؤال نفسه يلمّح إلى أن الإجابة مسجلة في مكان ما. لذلك يطلب الاختبار إنجاز مهمة، مثل «اطلب القهوة»، ثم يتحقق مما إذا كان النموذج قد استخدم الحقيقة الصحيحة.
يقوم تصميم الاختبار على ثلاثة أشخاص خياليين، لكل منهم سجل محادثات يضم نحو 500 ألف رمز، ثم يُكلَّف كل شخص بـ200 طلب. ويشترط الإبلاغ عن النتائج من حيث الدقة والتكلفة والوقت أيضًا.
أنشأت هذا الاختبار شركة تبيع نظامًا للذاكرة يُدعى Mem0، وأعلنت أن إعدادها حقق نجاحًا في 70.67% من الطلبات، متصدرةً النتائج. أما كاتب الاختبار الذي نعرضه هنا فلم يحاول إعادة إنتاج DolphinBench أو اختبار منتج شركة بعينها، بل استعان بالفكرة وصمم تجربة صغيرة خاصة به.
أربع طرق للذاكرة اختُبرت على دانا، مديرة المشروع الخيالية
بطلة التجربة هي دانا ويتفيلد، مديرة مشروع خيالية. أُعدّ لها سجل محادثات يغطي عامًا كاملًا ويضم 80 محادثة، وزُرعت فيه بعض التفاصيل المقصودة.
سجل يمتد عامًا و30 طلبًا
يبلغ السجل نحو 40 ألف رمز. وتذكر 30 محادثة منه، كلٌّ منها، حقيقة واحدة، مثل مطعم الغداء الذي ترتاده، أو موعد اجتماع، أو تاريخ إطلاق مشروع، أو الشخص المسؤول عنه. وتغيّر 11 محادثة تلك الحقائق لاحقًا، فيما تتناول المحادثات الـ39 المتبقية أحاديث عابرة عن الطابعة والقطارات والطقس، وغيرها. وقد أُدرجت الأحاديث اليومية عمدًا حتى لا تبرز الحقائق.
هناك 30 طلبًا، تتطلب استدعاء إحدى أدوات تحديد موعد اجتماع أو طلب وجبة أو إرسال رسالة أو إسناد مهمة. ويحتاج 9 منها إلى حقيقتين، مثل الشخص المسؤول والتاريخ. ولم يستند التقييم إلى نص الرد، بل اقتصر على التحقق مما إذا كانت القيم التي مُررت إلى الأداة صحيحة. كما أُعدّ سؤال مباشر واحد عن كل حقيقة، لاختبار قدرة النموذج على الإجابة استنادًا إلى أحدث قيمة.
الطرق الأربع موضع المقارنة
الطرق أربع: «بلا ذاكرة»، من دون تمرير أي معلومات؛ و«السجل الكامل»، بتمرير سجل المحادثات البالغ 40 ألف رمز كاملًا في كل مرة؛ و«التلخيص»، بقراءة السجل تدريجيًا وإعادة صياغة ملخص من نحو 1,000 كلمة؛ و«البحث»، باستخراج خمس مقاطع من السجل ذات صلة بالطلب وتمريرها.
يمكن تشبيه الأمر بتسليم شخص يوميًا مذكرات عام كامل، أو ورقة غش من صفحة واحدة أعدّها أحدهم، أو استخراج الصفحات ذات الصلة فقط عند كل طلب.
كان النموذجان المستخدمان GPT-4o mini من OpenAI وClaude Haiku 4.5 من Anthropic، ونُفذت 1,260 تجربة إجمالًا. وحُفظ سجل التجارب كلها في أداة إدارة التجارب Weights & Biases.
コメント