
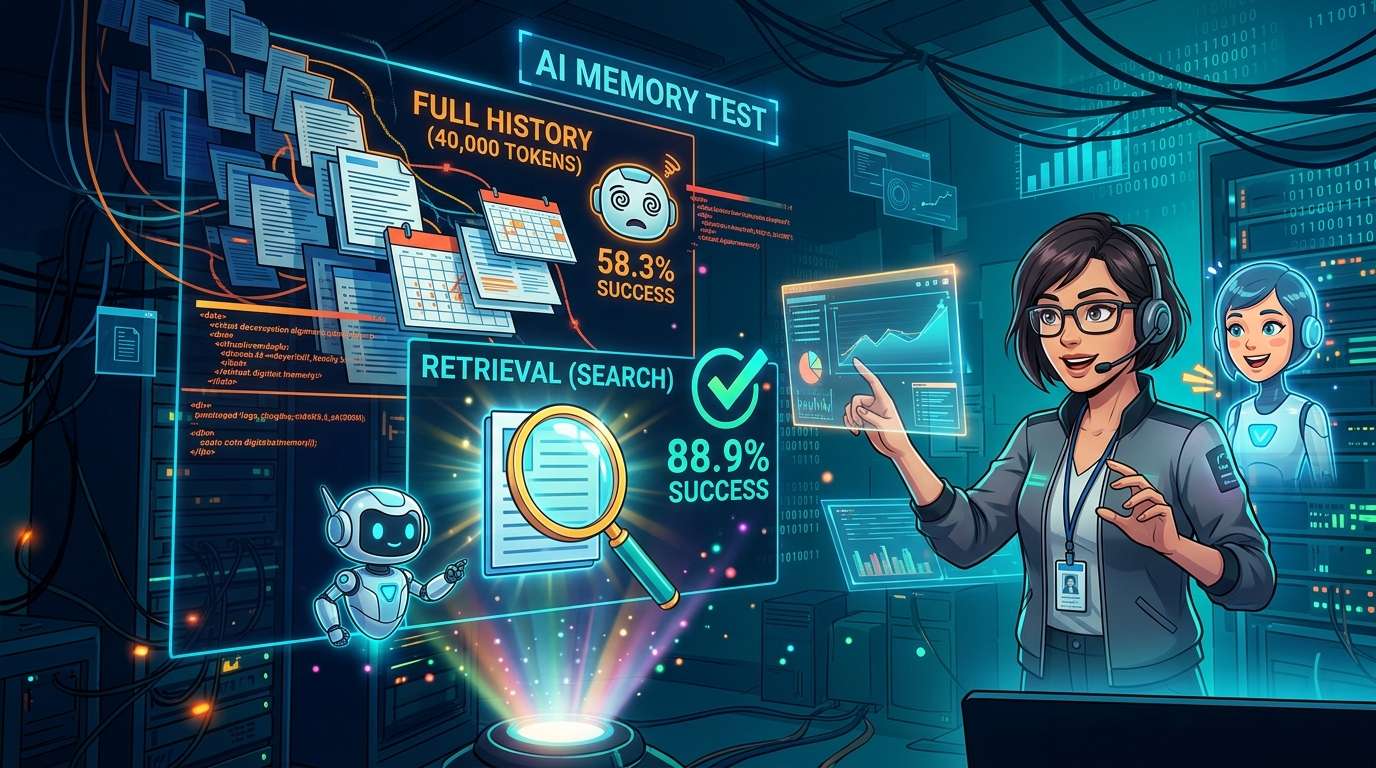
AI असिस्टेंट को “याददाश्त” देने के चार तरीकों की तुलना करने वाला एक परीक्षण डेटा साइंस मीडिया आउटलेट Towards Data Science में प्रकाशित हुआ है। एक काल्पनिक प्रोजेक्ट मैनेजर की लगभग 40,000 टोकन की बातचीत के इतिहास और 30 अनुरोधों पर किए गए परीक्षण में GPT-4o mini की काम पूरा करने की सफलता दर पूरी बातचीत का इतिहास देने पर 58.3% रही, जबकि सिर्फ़ ज़रूरी हिस्से खोजकर देने पर यह 88.9% थी।
“याद होना” और “काम में लेना” अलग बातें हैं
AI की याददाश्त मापने वाले नए परीक्षण “DolphinBench” से इस पड़ताल की शुरुआत हुई। पूरा लेखइस परीक्षण पर लेखमें पढ़ा जा सकता है।
याददाश्त के कई पुराने परीक्षण सीधे अतीत की किसी बात के बारे में पूछते हैं, जैसे “सैम की पसंदीदा कॉफी शॉप कौन-सी है?” लेकिन DolphinBench के लेखकों का कहना है कि सवाल ही यह संकेत दे देता है कि जवाब कहीं दर्ज है। इसलिए इस परीक्षण में “कॉफी ऑर्डर करो” जैसा काम दिया जाता है और देखा जाता है कि क्या AI ने सही तथ्य का इस्तेमाल किया।
इस परीक्षण में तीन काल्पनिक लोगों में से हर एक को लगभग 500,000 टोकन की बातचीत का इतिहास दिया जाता है और प्रत्येक से 200 अनुरोध पूरे करने को कहा जाता है। परिणामों में सटीकता के साथ लागत और समय की जानकारी देना भी अनिवार्य है।
यह परीक्षण Mem0 नामक याददाश्त प्रणाली बेचने वाली कंपनी ने बनाया था। कंपनी की घोषणा के मुताबिक, उसके सिस्टम ने 70.67% अनुरोध सफलतापूर्वक पूरे करके पहला स्थान हासिल किया। इस पड़ताल के लेखक ने न तो DolphinBench को दोहराया और न ही किसी खास कंपनी के उत्पाद का परीक्षण किया। उन्होंने सिर्फ़ इसका विचार लेकर अपना छोटा प्रयोग तैयार किया।
काल्पनिक प्रोजेक्ट मैनेजर डाना के साथ आज़माई गई याददाश्त की चार तकनीकें
इस प्रयोग की मुख्य किरदार काल्पनिक प्रोजेक्ट मैनेजर डाना व्हिटफील्ड हैं। उनके एक साल के 80 बातचीत-सत्रों का इतिहास तैयार किया गया और उसमें कुछ पेचीदगियां जोड़ी गईं।
एक साल का इतिहास और 30 अनुरोध
बातचीत का इतिहास लगभग 40,000 टोकन का है। इसमें से 30 बातचीतों में एक-एक तथ्य बताया गया है—जैसे अक्सर दोपहर का खाना खाने की जगह, बैठक का समय, प्रोजेक्ट की लॉन्च तारीख या उसका ज़िम्मेदार व्यक्ति। बाद की 11 बातचीतों में उन तथ्यों को बदल दिया गया है, जबकि बाकी 39 में प्रिंटर, ट्रेन और मौसम जैसी आम बातें हैं। तथ्यों को अलग से उभरने से रोकने के लिए जानबूझकर रोज़मर्रा की बातचीत भी मिलाई गई।
कुल 30 अनुरोध थे। इनमें बैठक तय करने, खाना ऑर्डर करने, संदेश भेजने या काम सौंपने के लिए किसी टूल का इस्तेमाल करना था। इनमें से 9 अनुरोधों के लिए दो तथ्यों की ज़रूरत थी, जैसे ज़िम्मेदार व्यक्ति और तारीख। अंक देते समय जवाब के शब्दों को नहीं पढ़ा गया; सिर्फ़ यह देखा गया कि टूल को दी गई जानकारी सही थी या नहीं। हर तथ्य के बारे में एक सामान्य सवाल भी तैयार किया गया, ताकि यह जांचा जा सके कि जवाब में सबसे नई जानकारी दी गई या नहीं।
तुलना के चार तरीके
चार तरीकों की तुलना की गई। “बिना याददाश्त” में कुछ भी नहीं दिया गया; “पूरा इतिहास” में हर बार 40,000 टोकन की बातचीत पूरी की पूरी दी गई; “सारांश” में इतिहास को हिस्सों में पढ़कर लगभग 1,000 शब्दों का सारांश बार-बार अपडेट किया गया; और “खोज” में अनुरोध से जुड़े इतिहास के पांच अंश निकालकर दिए गए।
इसे यूं समझें: हर सुबह एक साल की डायरी पूरी की पूरी थमा देना, किसी के बनाए एक पन्ने के चीट शीट के साथ भेजना, या हर अनुरोध के लिए सिर्फ़ उससे जुड़ा पन्ना निकालकर देना।
मॉडल OpenAI का GPT-4o mini और Anthropic का Claude Haiku 4.5 थे। कुल 1,260 बार प्रयोग चलाए गए। सभी प्रयोगों का रिकॉर्ड प्रयोग प्रबंधन टूल Weights & Biases में रखा गया है।
コメント