
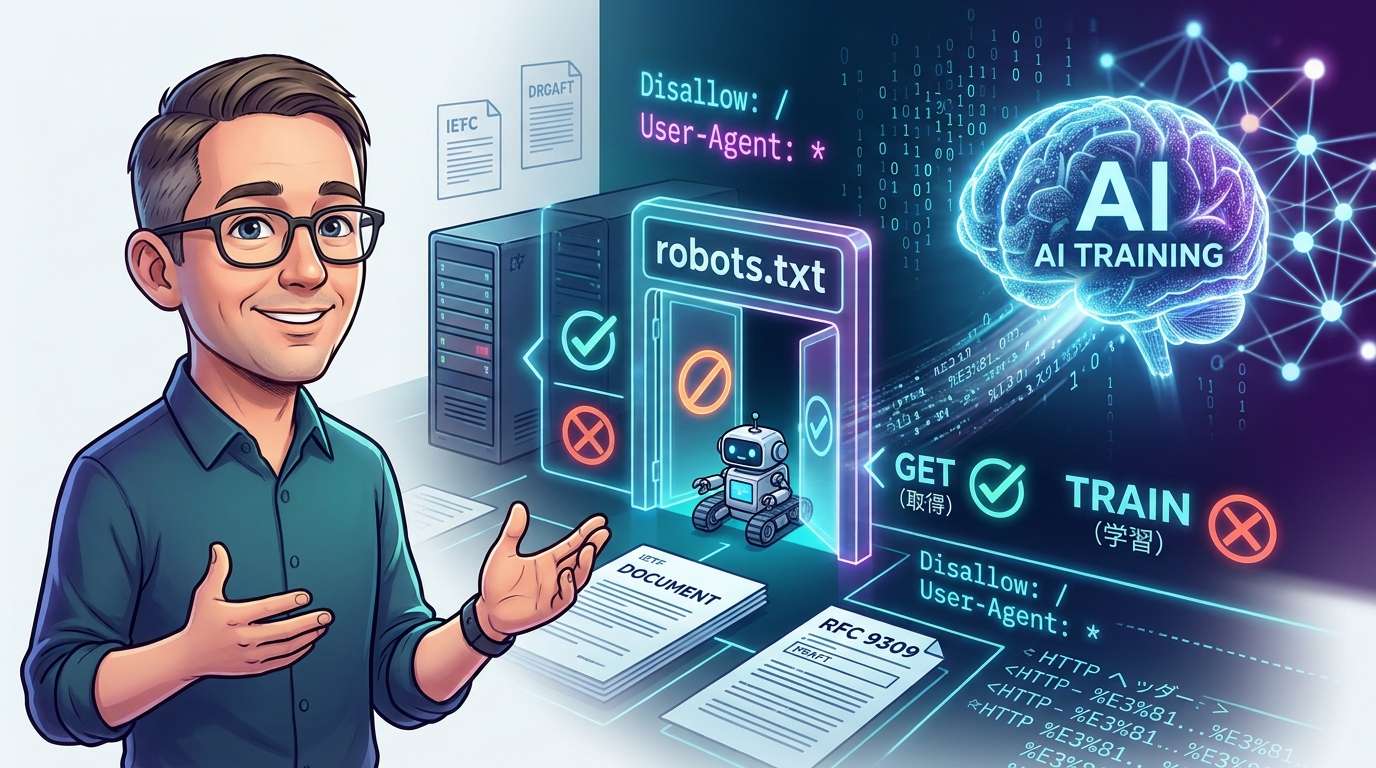
Dalam episode kedua serial video Search Central, “The Non-Canonical Cabinet”, Gary Illyes dari Google menjelaskan bahwa menurut standar robots.txt RFC 9309, file tersebut menentukan URL mana yang boleh diakses crawler, tetapi tidak mengatur bagaimana data diperlakukan setelah diambil. Ia mengatakan bahwa untuk memblokir crawler AI tertentu, nama user-agent crawler tersebut harus disebutkan secara eksplisit.
“Menolak akses” dan “tidak mengizinkan pelatihan” adalah dua hal berbeda
“Kalau kita menulis larangan pelatihan AI di robots.txt, berarti aman.” Pemahaman seperti ini tampaknya kian meluas. Namun, menurut penjelasan Illyes, persoalannya tidak sesederhana itu. robots.txt ibarat papan di pintu masuk situs yang memberi tahu, “Silakan masuk lewat pintu ini.” Namun, bagaimana informasi yang dibawa pulang oleh orang yang sudah masuk akan digunakan bukanlah urusan papan tersebut.
Illyes menyebut robots.txt yang didefinisikan dalam RFC 9309 sebagai “protokol untuk menyampaikan preferensi akses”, dan menjelaskan bahwa file itu tidak dapat menentukan bagaimana sistem memperlakukan data yang sudah dirayapi. Pertanyaan dalam video tersebut adalah apakah AI dapat diizinkan merayapi konten, tetapi dilarang menggunakan informasi yang sama untuk melatih model AI generatif. Jawabannya: robots.txt saja tidak dapat membedakan kedua hal itu.
robots.txt hanya mengatur akses
Halaman spesifikasi Google mencantumkan empat elemen yang didukung perusahaan: User-Agent, Allow, Disallow, dan Sitemap. Baris lain di luar itu dianggap tidak valid dan diabaikan. Dalam video tersebut, ditampilkan instruksi rekaan “No-AI-Chicken-Training”, tetapi baris khusus seperti itu tidak akan dibaca oleh parser Google.
Bagian 2.2.4 RFC 9309 menyerahkan penanganan entri di luar cakupan spesifikasi kepada keputusan crawler. Artinya, meskipun Anda menambahkan baris khusus, apakah pihak lain akan mematuhinya bergantung pada mereka. Bisa saja berfungsi, bisa juga tidak. Setidaknya, itu bukan “jaminan yang dilindungi standar”.
Cara yang dapat diandalkan dalam praktik adalah menyebutkan user-agent setiap crawler AI yang ingin diblokir secara terpisah, lalu menolak aksesnya dengan Disallow. Illyes mengatakan bahwa jika ingin menolak seluruh situs, token yang dituju harus disebutkan secara eksplisit.
Google-Extended adalah kontrol penggunaan khusus Google
Lalu, bagaimana posisi Google-Extended, yang digunakan untuk AI Google? Ini adalah token robots.txt yang tidak memiliki user-agent tersendiri; Google merayapi situs menggunakan crawler yang sudah ada. Dalam daftar crawler-nya, Google menjelaskan bahwa token ini digunakan sebagai “mekanisme kontrol”.
Pengaturan ini menentukan apakah konten yang diperoleh Google akan digunakan untuk melatih model Gemini mendatang, Gemini Apps, atau grounding pada Grounding with Google Search di Vertex AI (merujuk informasi sebagai dasar pendukung jawaban). Pengaturan tersebut tidak memengaruhi pencantuman di Google Penelusuran dan bukan merupakan sinyal peringkat penelusuran.
Yang perlu dicatat, makna “kontrol penggunaan” ini bukan berasal dari RFC 9309, melainkan ditetapkan Google dalam dokumentasi produknya sendiri. Makna ini tidak berlaku sebagai aturan umum robots.txt bagi AI perusahaan lain. Lebih tepat jika menganggapnya sebagai sakelar khusus untuk Google.
Usulan standar untuk menyatakan tujuan penggunaan masih berupa draf
Apakah izin merayapi dan preferensi penggunaan setelah konten diambil bisa dinyatakan secara terpisah? Upaya untuk mengatasi persoalan ini juga tengah berjalan. Illyes bersama Martin Thomson dari Mozilla menulis draf Internet IETF. Versi terkini, tertanggal 19 Agustus, mengusulkan pembaruan terhadap RFC 9309 dengan menambahkan aturan “Content-Usage” ke robots.txt serta header HTTP yang sesuai.
Pembagian perannya jelas. Allow dan Disallow tetap menentukan URL yang boleh dirayapi, sedangkan Content-Usage menyatakan preferensi tentang bagaimana konten yang diperoleh sebaiknya digunakan. Preferensi ini hanya berlaku untuk jalur yang boleh diakses crawler. Dalam contoh di draf, robots.txt yang mengizinkan perayapan dilengkapi keterangan Content-Usage “train-ai=n”.
Namun, saat ini dokumen tersebut masih berada pada tahap dokumen kelompok kerja. Catatan IETF Datatracker menunjukkan bahwa dokumen itu belum diajukan untuk ditinjau oleh IESG (kelompok pengelola yang bertanggung jawab atas standardisasi teknis internet), sementara pengajuan oleh kelompok kerja dijadwalkan pada Agustus 2026. Label “train-ai” muncul dalam draf kosakata terpisah tertanggal 14 September, tetapi draf tersebut secara tegas menyatakan bahwa isinya tidak mencerminkan kesepakatan dalam kelompok kerja. Draf saat ini berlaku hingga 20 Februari 2027 dan akan digantikan jika versi revisi diterbitkan sebelum tanggal tersebut.
Dengan kata lain, cara standar untuk menyatakan preferensi penggunaan konten untuk pelatihan secara terpisah dari izin crawler masih sebatas draf. Terlalu dini untuk menganggapnya sebagai aturan umum yang sudah dapat digunakan.
Untuk URL berbahasa Jepang, percent-encoding lebih aman
Dalam episode ini, topik praktis di luar AI juga dibahas. Cherry Prommawin dari Google menyarankan agar path yang memuat karakter non-Inggris atau emoji ditulis dalam robots.txt menggunakan “format terenkode”. Parser Google dapat memproses karakter mentah dengan mengenkodenya, tetapi crawler lain atau crawler versi lama mungkin kebingungan.
Dalam video, contoh yang menuliskan emoji secara langsung diberi label “berfungsi di Google, tetapi mungkin bermasalah di tempat lain”, sedangkan contoh dengan pengodean persen diberi label “cara yang aman dan standar”. Menurut halaman spesifikasi Google, parser perusahaan itu memperlakukan UTF-8 mentah dan pengodean persen sebagai hal yang sama. Tata bahasa RFC 9309 juga mengizinkan karakter UTF-8 dalam path, tetapi belum tentu crawler perusahaan lain menafsirkannya dengan cara yang sama.
Banyak situs menggunakan nama direktori atau halaman berbahasa Jepang dalam URL. Jika ingin mengatur crawler AI satu per satu, penulisan path juga perlu diperhatikan.
Yang dapat dilakukan pengelola situs saat ini
Singkatnya, cara yang perlu ditempuh berbeda-beda, bergantung pada bot atau produk yang dituju, jika pengelola situs ingin membatasi penggunaan oleh AI sekaligus mempertahankan tampilan situs di Google Search. Akses crawler AI tertentu ke halaman dapat dihentikan dengan aturan Disallow yang mencantumkan user agent-nya. Untuk Gemini, kontrol yang secara resmi ditunjukkan Google adalah Google-Extended, yang mencakup pelatihan dan grounding.
Sementara itu, sintaks umum untuk menolak penggunaan bagi pelatihan saja sambil tetap mengizinkan crawling masih sebatas rancangan. Kita belum berada pada masa ketika satu baris di robots.txt bisa mengatur semuanya; untuk saat ini, memeriksa dokumentasi resmi setiap crawler tetap penting. Jika standardisasi terus berkembang, kelak pengaturan akses dan pernyataan preferensi penggunaan mungkin bisa ditulis secara terpisah.
Sebagai informasi, deskripsi video menyebutkan bahwa episode berikutnya dalam seri ini akan membahas kode status 404.






コメント