
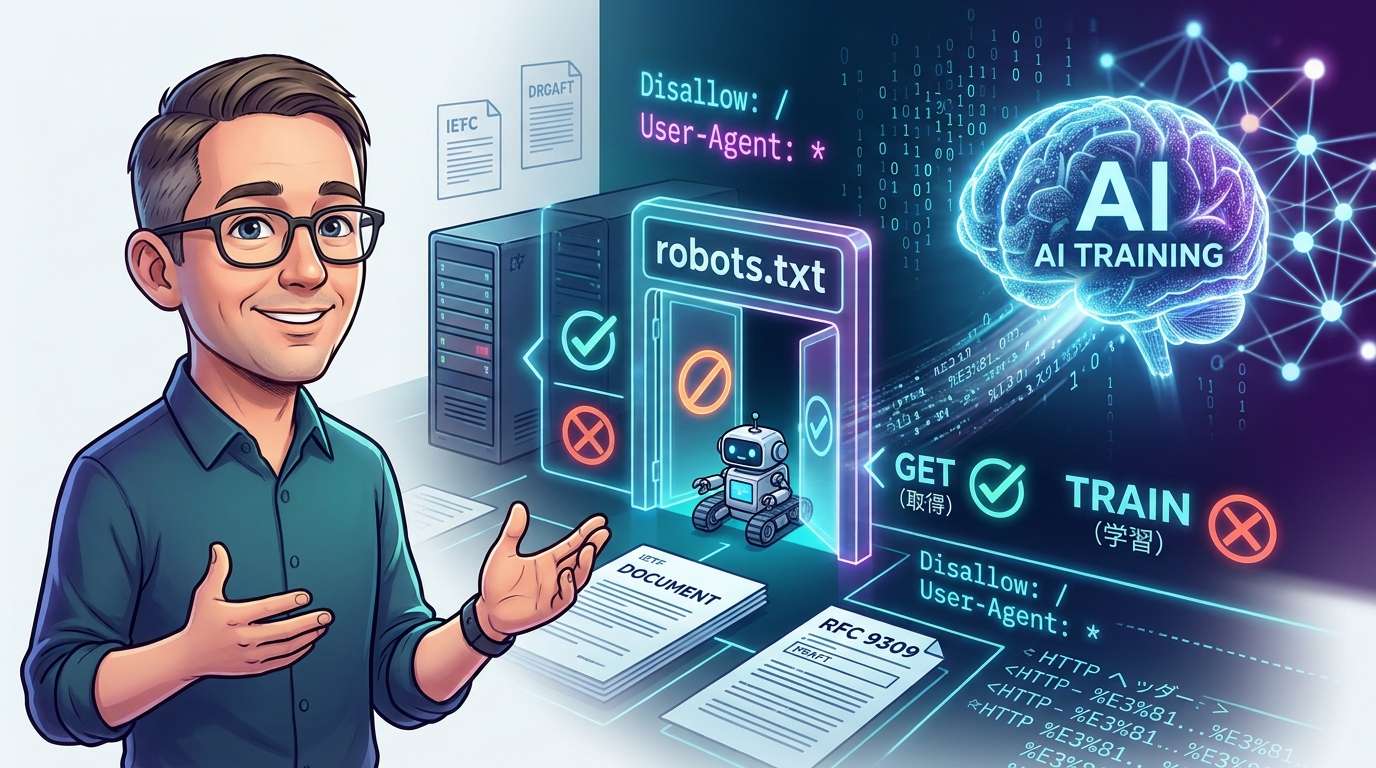
أوضح غاري إيليز من Google، في الحلقة الثانية من سلسلة فيديوهات Search Central «The Non-Canonical Cabinet»، أن robots.txt، وفقًا للمواصفة القياسية RFC 9309، يحدد عناوين URL التي يُسمح للزاحف بجلبها، ولا يحدد كيفية التعامل مع البيانات بعد جلبها. وأضاف أنه إذا أراد الموقع حظر زاحف معيّن للذكاء الاصطناعي، فعليه أن يذكر وكيل المستخدم الخاص بذلك الزاحف بالاسم.
«الرفض» و«منع التدريب» أمران مختلفان
«ما دمت أكتب في robots.txt أنني أمنع التدريب على الذكاء الاصطناعي، فأنا في مأمن». يبدو أن هذا الفهم آخذ في الانتشار تدريجيًا. لكن وفقًا لشرح إيليز، المسألة ليست بهذه البساطة. يشبه robots.txt لافتة عند مدخل الموقع تقول: «يمكنكم الدخول من هذا الباب». أما كيفية استخدام من دخلوا للمعلومات التي أخذوها معهم، فلا تدخل ضمن نطاق ما تنظمه اللافتة.
وصف إيليز robots.txt، كما تحدده RFC 9309، بأنه «بروتوكول للتعبير عن تفضيلات الوصول»، وأوضح أن هذا البروتوكول لا يمكنه توجيه الأنظمة بشأن كيفية تعاملها مع البيانات التي جرى الزحف إليها. وكان السؤال المطروح في الفيديو هو ما إذا كان بالإمكان السماح بالزحف بواسطة الذكاء الاصطناعي، مع منع استخدام المعلومات نفسها لتدريب نماذج الذكاء الاصطناعي التوليدي. والإجابة هي أن robots.txt وحده لا يتيح هذا التمييز.
robots.txt يحدد الوصول فحسب
تذكر صفحة مواصفات Google أربعة توجيهات تدعمها الشركة: User-Agent وAllow وDisallow وSitemap. أما الأسطر الأخرى فتُعد غير صالحة ويتم تجاهلها. وعرض الفيديو توجيهًا خياليًا بعنوان «No-AI-Chicken-Training»، لكن محلل Google لا يقرأ مثل هذه الأسطر المخصصة.
تترك الفقرة 2.2.4 من RFC 9309 للمزاحف قرار كيفية التعامل مع السجلات التي تقع خارج نطاق المواصفة. وهذا يعني أن إضافة أسطر مخصصة لا تضمن أن يستجيب لها الطرف الآخر؛ فقد تنجح وقد لا تنجح. لكنها، على أقل تقدير، ليست «التزامًا تضمنه المواصفة القياسية».
الطريقة العملية الموثوقة هي تحديد وكيل المستخدم لكل زاحف للذكاء الاصطناعي تريد إيقافه، ثم رفض الوصول نفسه باستخدام Disallow. وقال إيليز إن من أراد رفض الوصول إلى الموقع بأكمله، فعليه أن يذكر الرمز المستهدف صراحةً.
Google-Extended أداة تحكم مخصصة لاستخدام Google
ما موقع Google-Extended، إذًا، الذي يُستخدم لأغراض الذكاء الاصطناعي لدى Google؟ إنه رمز في robots.txt لا يمتلك وكيل مستخدم مستقلًا، وتستخدم Google زواحفها الحالية في عملية التصفح. وتوضح قائمة زواحف الشركة أن هذا الرمز يُستخدم «لأغراض التحكم».
يشمل التحكم تحديد ما إذا كان المحتوى الذي تحصل عليه Google سيُستخدم في تدريب نماذج Gemini المستقبلية، أو في Gemini Apps، أو في عملية الإسناد إلى مصادر (أي الرجوع إلى معلومات تدعم الإجابات) عبر Grounding with Google Search على Vertex AI. ولا يؤثر ذلك في ظهور المحتوى ضمن نتائج Google Search، كما أنه ليس إشارة لترتيب نتائج البحث.
النقطة المهمة هنا هي أن معنى «التحكم في الاستخدام» هذا لا يستند إلى RFC 9309، بل إلى ما حددته Google في وثائق منتجاتها. ولا ينطبق ذلك بوصفه قاعدة مشتركة في robots.txt على أنظمة الذكاء الاصطناعي التابعة لشركات أخرى. ومن الأنسب اعتباره مفتاحًا مخصصًا لـGoogle.
المقترح المعياري لتحديد أغراض الاستخدام لا يزال مسودة
هل يمكن الفصل بين السماح بالزحف والتعبير عن التفضيلات المتعلقة باستخدام البيانات بعد جلبها؟ هناك تحرك لمعالجة هذه المسألة أيضًا. ويشارك إيليز في كتابة مسودة إنترنت لدى IETF مع مارتن طومسون من Mozilla. وتتضمن النسخة الحالية المؤرخة في 19 أغسطس تحديث RFC 9309 بإضافة قاعدة «Content-Usage» إلى robots.txt، إلى جانب ترويسة HTTP مقابلة.
تقسيم الأدوار واضح: يظل Allow وDisallow مسؤولين عن تحديد عناوين URL التي يمكن الزحف إليها، بينما يعبّر Content-Usage عن التفضيلات بشأن كيفية استخدام المحتوى الذي جرى الحصول عليه. ولا تنطبق هذه التفضيلات إلا على المسارات المسموح للزاحف بالحصول على محتواها. وفي مثال المسودة، يُضاف توجيه Content-Usage يتضمن «train-ai=n» إلى ملف robots.txt يسمح بالزحف.
لكن الوثيقة لا تزال في مرحلة العمل ضمن مجموعة العمل. ووفقًا لسجل IETF Datatracker، لم تُقدَّم بعد للمراجعة إلى IESG (مجموعة الإدارة المسؤولة عن وضع معايير الإنترنت)، وكان من المقرر إرسالها إلى مجموعة العمل في أغسطس 2026. ويظهر الوسم «train-ai» في مسودة مفردات أخرى مؤرخة في 14 سبتمبر، لكن الوثيقة تنص صراحةً على أنها لا تعكس توافقًا داخل مجموعة العمل. وتنتهي صلاحية المسودة الحالية في 20 فبراير 2027، وستحل محلها نسخة منقحة إذا صدرت قبل ذلك الموعد.
بعبارة أخرى، لا تزال الطريقة المعيارية للتعبير عن تفضيلات استخدام البيانات في التدريب، بمعزل عن السماح للزاحف بالوصول، مجرد مسودة حتى الآن. ومن المبكر التعامل معها على أنها قاعدة مشتركة متاحة للاستخدام.
الترميز بالنسبة المئوية لعناوين URL اليابانية أكثر أمانًا
تناولت هذه الحلقة أيضًا موضوعات عملية لا تتعلق بالذكاء الاصطناعي. ونصحت تشيري برومّاوين من Google باستخدام «الصيغة المُرمَّزة» عند إدراج مسارات تتضمن أحرفًا غير إنجليزية أو رموزًا تعبيرية في robots.txt. فمحلّل Google قادر على ترميز الأحرف الخام ومعالجتها، لكن ذلك قد يربك برامج زحف أخرى أو أقدم.
في الفيديو، وُصف مثال كتابة الرموز التعبيرية مباشرة بأنه «يعمل على Google، لكنه قد يتعطل في أماكن أخرى»، بينما وُصف المثال الذي يستخدم الترميز المئوي بأنه «طريقة آمنة ومعيارية». ووفقًا لصفحة مواصفات Google، يتعامل محلّلها مع UTF-8 الخام والترميز المئوي على أنهما شيء واحد. كما تسمح قواعد RFC 9309 بأحرف UTF-8 في المسارات، لكن ليس مضمونًا أن تفسّر برامج زحف الشركات الأخرى ذلك بالطريقة نفسها.
تستخدم مواقع كثيرة أسماء مجلدات وصفحات باللغة اليابانية في عناوين URL. وإذا كنت تحاول التحكم في برامج زحف الذكاء الاصطناعي كلٌّ على حدة، فمن الأفضل الانتباه أيضًا إلى طريقة كتابة المسارات.
ما يمكن لمشغّلي المواقع فعله الآن
خلاصة القول، إذا أردت تقييد استخدام المحتوى بواسطة الذكاء الاصطناعي مع الحفاظ على طريقة ظهور الموقع في بحث Google، فستختلف الخطوات اللازمة بحسب الروبوت أو المنتج المستهدف. ويمكن منع برامج زحف ذكاء اصطناعي محددة من الوصول إلى الصفحات باستخدام توجيه Disallow مع تحديد وكيل المستخدم الخاص بها. أما Gemini، فالآلية التي تعلن عنها Google رسميًا هي Google-Extended، وهي تشمل التدريب وربط الإجابات بالمصادر (grounding) على حد سواء.
أما الصيغة الموحدة التي تتيح رفض استخدام المحتوى في التدريب مع السماح بالزحف، فلا تزال موجودة في المسودات فحسب. لم يعد سطر واحد في robots.txt كافيًا لحسم كل شيء، لذا لا غنى في الوقت الراهن عن مراجعة الوثائق الرسمية الخاصة بكل برنامج زحف. وقد يتيح التقدم في وضع المعايير يومًا ما فصل إدارة الوصول عن التعبير عن تفضيلات استخدام المحتوى.
ويشير وصف الفيديو إلى أن الحلقة التالية من السلسلة ستتناول رمز الحالة 404.






コメント