
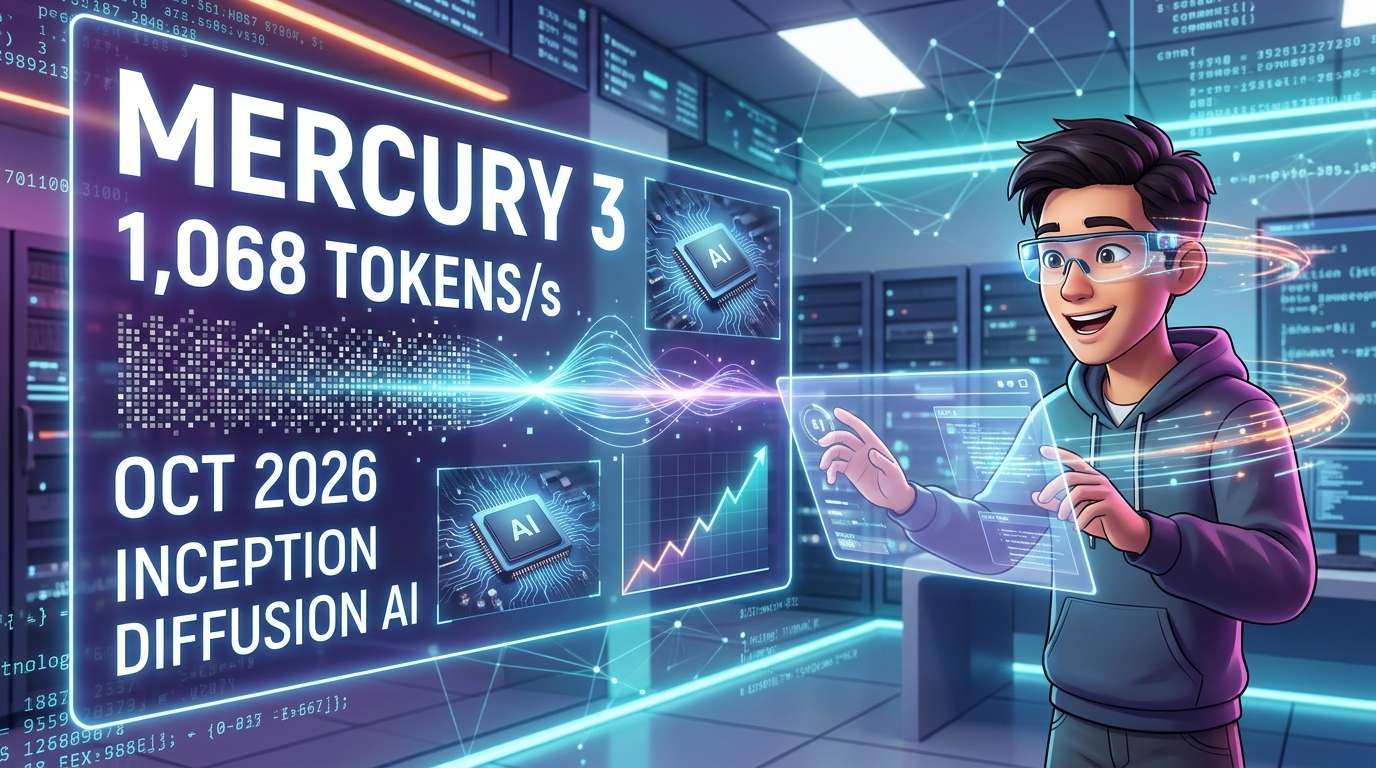
A startup norte-americana de IA Inception anunciou o modelo de linguagem de difusão «Mercury 3» em outubro de 2026. Segundo a comparação da empresa, o modelo gera 1 068 tokens por segundo em GPUs da Nvidia e é 4–8 vezes mais rápido do que o GPT-6 Luna e o Claude Haiku 5.5. A empresa afirma também que superou os concorrentes em 8 dos 12 itens de referência, num exemplo de como a competição na IA se está a alargar da «inteligência» para o «tempo de espera».
O que está por detrás de um modelo que não escreve uma palavra de cada vez
Os modelos de linguagem dominantes, como o GPT e o Claude, geram texto palavra a palavra, por ordem. Para produzir a palavra seguinte, é preciso que a anterior já esteja definida — é como esperar numa fila para a caixa. Por mais rápidos que sejam os computadores, esta estrutura de «espera numa única fila» não muda.
O Mercury 3 usa uma abordagem chamada modelo de difusão. Leva para o texto um conceito popularizado pela IA de geração de imagens: primeiro, cria um rascunho geral da resposta e, depois, aperfeiçoa-o ao longo de várias etapas de processamento. Segundo a Inception, como consegue processar muitas palavras em simultâneo, tem vantagem em termos de velocidade. A Google também está a desenvolver investigação nesta área e, depois da demonstração do Gemini Diffusion, lançou em junho o modelo aberto «DiffusionGemma». É até 4 vezes mais rápido do que o Gemma 4 padrão, embora os resultados sejam considerados um pouco inferiores.
Segundo a Inception, o Mercury 3 tem mais de 40 vezes os parâmetros do Mercury 1 original, mas mantém uma velocidade equivalente. Face à versão compacta Mercury 1 mini, o desempenho triplicou, afirma a empresa. Mesmo nos modelos de difusão, o desempenho melhora de forma consistente à medida que aumenta a escala. A empresa considera este resultado um sinal importante.
Os resultados dos benchmarks não são todos iguais
No anúncio, destaca-se o número «primeiro lugar em 8 de 12 itens». No entanto, a comparação foi feita pela própria empresa e os três modelos foram testados com definições intermédias.
A maior diferença está no cumprimento de instruções. No IFBench, o Mercury 3 obteve 76,84 pontos, cerca de 15 pontos acima do GPT-6 Luna. Também alcançou 51,08 pontos no SWE-Bench Atlas, que avalia a programação autónoma, destacando-se dos concorrentes, que obtiveram 33,33 e 32,26 pontos.
Por outro lado, o Claude Haiku 5.5 venceu no DeepSWE, um benchmark com tarefas de programação mais longas. O mesmo modelo também leva vantagem em tarefas que exigem encontrar informação em textos longos. Nos dois itens da Artificial Analysis, o GPT-6 Luna fica ligeiramente à frente. É provavelmente por isso que a apresentação resumida da empresa descreve com cautela a qualidade como «igual ou superior», tendo em conta estes resultados.
Quanto à velocidade, a comparação da empresa indica 1 068 tokens por segundo para o Mercury 3, contra cerca de 240 para o Claude Haiku 5.5 e cerca de 130 para o GPT-6 Luna. Ainda não foram divulgados resultados de uma verificação independente por terceiros. O mais sensato é encarar estes números como uma «alegação promissora» e testá-los nos próprios casos de utilização.
Quando o tempo de espera se torna um fator de valor
A Inception aponta como principais áreas de utilização os agentes de IA, a pesquisa, o apoio ao cliente e o apoio à aprendizagem. Os agentes, em particular, dividem uma tarefa em várias etapas e, a cada uma delas, têm de esperar pela resposta do modelo. Mesmo que o atraso em cada etapa seja pequeno, o efeito acumulado pode alterar significativamente a experiência do utilizador.
Os primeiros clientes também destacam a velocidade. Kuan Zou, fundador da Octen AI, que desenvolve uma função de pesquisa para óculos inteligentes, afirma: «Nos óculos inteligentes, uma resposta que demora 5 segundos parece avariada.» A pesquisa em si demorava cerca de 80 milissegundos; o modelo de linguagem era o estrangulamento. Com o Mercury 3, o tempo de resposta mediano passou a ser de 0,9 segundos e o processamento total ficou nos 2,2 segundos.
A General Learning, empresa do setor da educação, afirma que passou a conseguir dar dicas e corrigir trabalhos dos alunos em cerca de 1 segundo. A Lorikeet, que presta serviços de apoio ao cliente, também reportou melhorias nos resultados, além de respostas mais rápidas. A TinyFish AI, que automatiza a navegação em sites, afirma ter resolvido 25 de 50 tarefas de navegação em sites reais, superando o GPT-6.1-Sol. No entanto, não foram apresentados números concretos do lado da OpenAI.
Na decisão de adoção, há mais fatores a considerar além da velocidade
É relativamente fácil começar a usar o Mercury 3. Além da plataforma da própria Inception, está disponível na OpenRouter, na Baseten e na Vercel. A empresa considera que a transição a partir de sistemas existentes exige pouco esforço, uma vez que o modelo usa uma API compatível com os modelos da OpenAI. Aceita até 1 milhão de tokens de entrada.
O preço normal é de 0,20 dólares por milhão de tokens de entrada e 0,70 dólares por milhão de tokens de saída. No momento do anúncio, o serviço estava a ser disponibilizado por metade do preço, mas não foi indicado até quando duraria o desconto. Quando voltar ao preço normal, o custo por milhão de tokens de saída será superior ao do GPT-6 Luna e do Claude Haiku 5.5, ambos a 0,50 dólares, no caso de entradas curtas. No entanto, para entradas muito longas, os dois modelos concorrentes são bastante mais caros.
Em fevereiro de 2026, a Inception lançou o «Mercury 2», apresentado como o primeiro modelo de difusão a incluir uma etapa de raciocínio intermédio antes da resposta. Antes disso, tinha angariado 50 milhões de dólares. Entre os investidores figuram a Nvidia, a Microsoft e as unidades de investimento NVentures, M12 e Snowflake Ventures, associadas à Nvidia, à Microsoft e à Snowflake.
No fim de contas, a escolha não depende apenas da velocidade. A qualidade, o preço, o desempenho com textos longos e o grau de sensibilidade do seu serviço aos tempos de espera também contam. A decisão depende da combinação destes fatores. Para aplicações em que a resposta em tempo real é essencial, o Mercury 3 poderá ser uma opção a experimentar.






コメント