
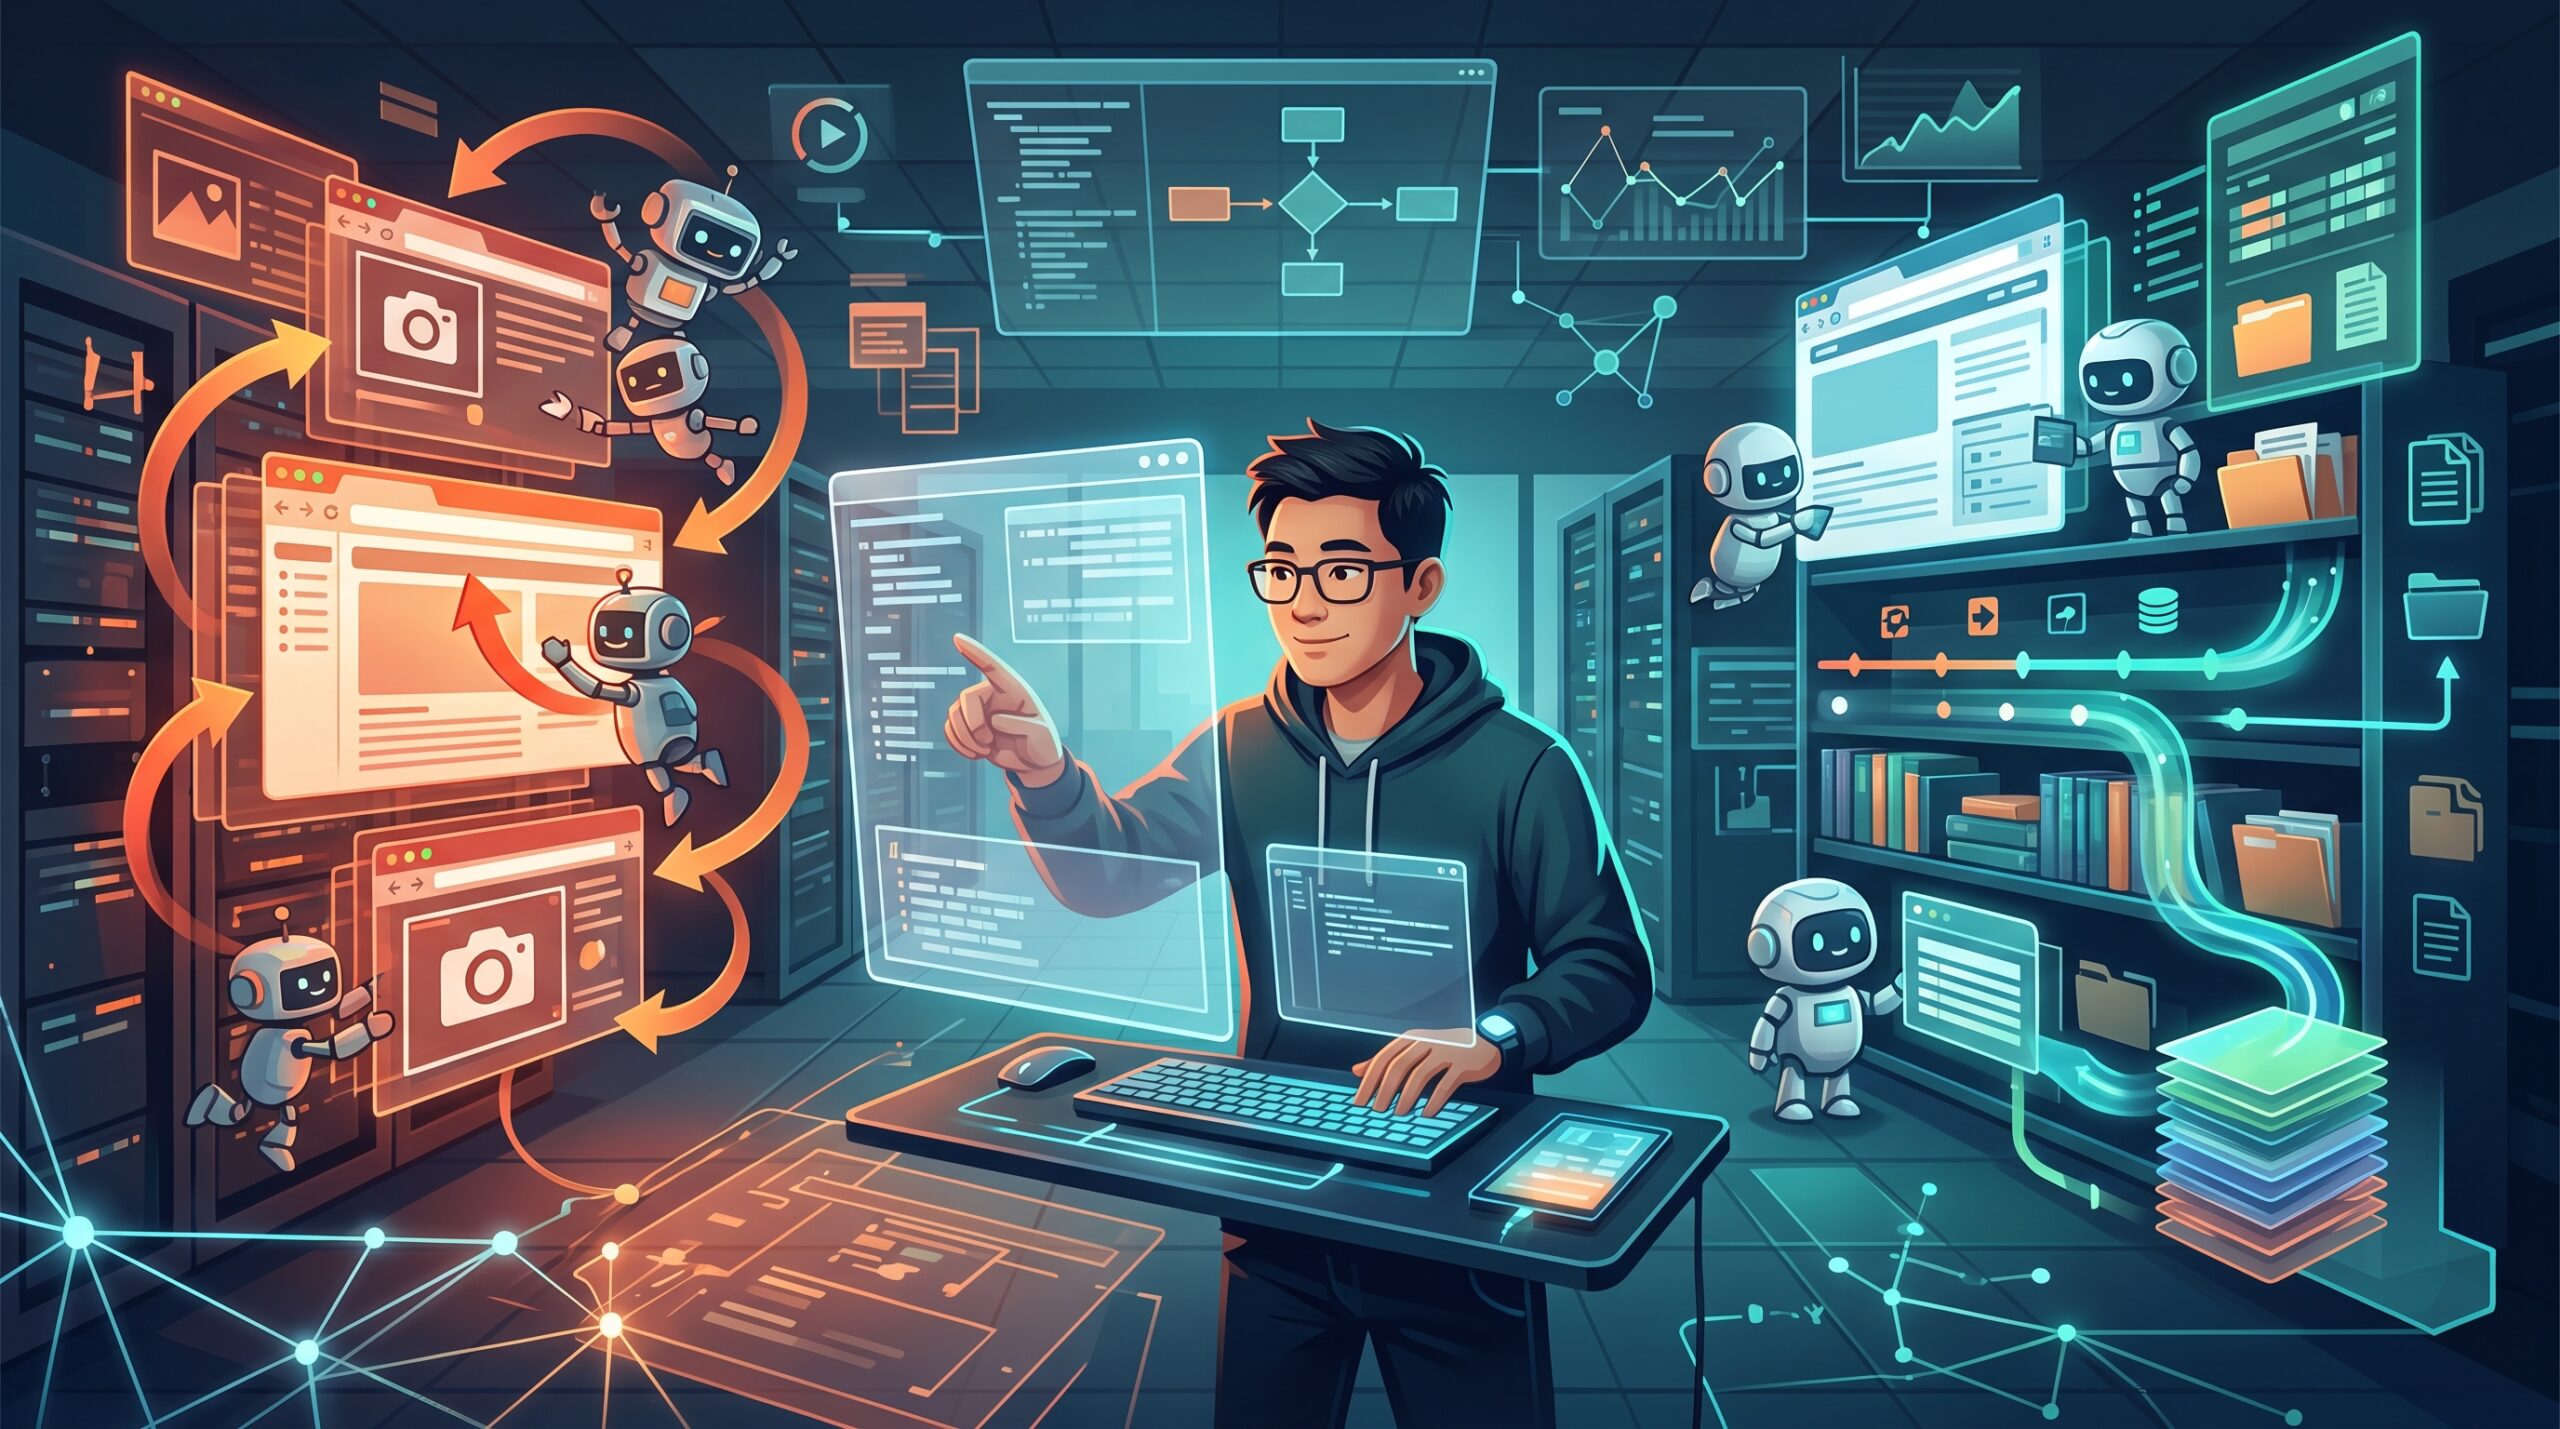
Asana anunció que, al probar una IA de StackAI que automatiza las operaciones en el navegador, redujo el coste estimado del modelo a una septuagésima sexta parte y multiplicó por cinco la velocidad de procesamiento, en comparación con la configuración de producción anterior. Con una configuración optimizada que utiliza GPT‑6.1 Sol y gestiona mejor el historial de navegación, cada ejecución costó una media de 0,47 dólares y duró unos 4 minutos.
Reducir el coste a una septuagésima sexta parte no fue solo cuestión de cambiar de modelo
Lo importante de estas cifras es que no comparan el rendimiento de los modelos por separado, sino el resultado de combinar un modelo con un proceso de trabajo. Un agente de navegador es una IA que lee páginas web y realiza tareas como recopilar información o rellenar formularios. Asana ofrece la automatización de este tipo de tareas a través de StackAI, empresa que adquirió.
En las pruebas, se recopilaron seis datos de cada uno de los 32 libros de un catálogo público de demostración. Se realizaron 144 ejecuciones con cuatro modelos y varios ajustes. Con el modelo B, que se usaba inicialmente, el coste estimado por ejecución era de 36,21 dólares o más; bastó con revisar el proceso para reducirlo a 1,24 dólares. Con una configuración optimizada que utiliza GPT‑6.1 Sol, bajó aún más, hasta 0,47 dólares.
En otras palabras, incluso manteniendo el modelo B, se pudo reducir el coste a aproximadamente una vigésima novena parte. Detrás del titular sobre la reducción a una septuagésima sexta parte, la mejora del diseño del proceso antes de elegir el modelo desempeñó un papel importante.
La clave del ahorro estaba en el historial de navegación que se proporciona a la IA
En la configuración anterior, se almacenaban en caché las instrucciones fijas y otros elementos, pero no el contenido de las páginas ni el historial de capturas de pantalla que se iba acumulando. La caché permite reutilizar entradas procesadas previamente. Si no se puede reutilizar el historial, hay que volver a enviar la información anterior cada vez que se invoca la IA, lo que genera un coste adicional.
Además, en casi cada paso se eliminaban las imágenes antiguas y se acortaban los textos. Como el historial cambiaba con frecuencia, añadir una caché por sí solo difícilmente podía dar buenos resultados. Borrar demasiada información también podía hacer que el agente volviera a visitar páginas que ya había leído.
Por eso, se aumentó el límite de historial conservado de 120.000 a 480.000 caracteres y se incluyó el historial de navegación en la caché. Para las capturas de pantalla, se optó por acumular hasta 20 antes de conservar solo la más reciente. En vez de depurarlo todo en cada paso, se hizo de una vez, prolongando así el periodo durante el cual podía reutilizarse el historial anterior sin modificarlo.
Conservar más información también puede reducir los costes
Reducir la información que se proporciona a la IA abarata el proceso. Sin embargo, estos resultados muestran que esa idea, por sí sola, no basta para explicar el coste de los agentes. En algunos casos, conservar y reutilizar información y evitar comprobaciones redundantes puede abaratar el proceso en su conjunto.
Con GPT‑6.1 Sol, al ampliar el límite de historial conservado y revisar la caché y la gestión de imágenes, el coste estimado por ejecución bajó de 1,97 a 0,47 dólares. Tras la optimización, el 89 % de las entradas procedía de la caché y el coste de esa parte equivalía al 5 % del que habría tenido sin utilizarla.
La cantidad de historial también influye en la finalización de las tareas. Con GPT‑6.1 Sol, se pudieron generar respuestas en 3 de 18 ejecuciones cuando el límite de historial era menor, frente a las 18 de 18 cuando era mayor. En las pruebas, las 18 respuestas fueron correctas.
También se utilizó IA para probar propuestas de mejora
Además de GPT‑6.1 Sol, que manejaba el navegador, se utilizó GPT‑6 Astra de Codex para investigar y plantear mejoras. Analizó la estructura del código, identificó problemas en la gestión del historial, reorganizó el código para realizar pruebas y verificó en paralelo varias configuraciones.
Eso no significa que no intervinieran personas. Frank Hidalgo, CTO de StackAI, revisó las propuestas y eligió qué cambios probar. Los registros y resultados de los experimentos también fueron revisados en otra sesión de modelo y se guardaron en Command, la plataforma de desarrollo de Asana. Los cambios pasaron por tickets y solicitudes de incorporación de cambios antes de llegar al entorno de producción.
Hidalgo explicó que una investigación que, según su estimación, habría llevado entre uno y dos meses de trabajo manual se completó en aproximadamente una semana. Esta comparación se basa en su estimación y no en los resultados de un experimento de control en el que personas realizaran la misma tarea sin ayuda de la IA.
Al decidir si se implementa, hay que valorar conjuntamente el coste y la tasa de finalización
Los 0,47 dólares son el coste estimado del modelo, no el coste total, que incluiría la mano de obra y la operación del sistema. Además, algunas configuraciones de referencia alcanzaron el límite de ejecuciones sin completar la tarea; por tanto, las cifras de 36,21 dólares o más y 22,5 minutos o más son valores mínimos. Las principales cifras comparativas son promedios de tres ejecuciones por configuración, y no cabe aplicar el mismo porcentaje de reducción a todo tipo de tareas web.
Entre las configuraciones optimizadas, el modelo C costó 0,66 dólares y tardó 3,5 minutos, mientras que GPT‑6.1 Sol costó 0,47 dólares y tardó unos 4 minutos. En esta tarea, Sol fue más barato, pero el modelo C fue más rápido: el orden cambia según se mida el coste o la velocidad.
Asana ya ha incorporado estos cambios a la función de automatización del navegador de StackAI. En adelante, prevé integrar las pruebas en las funciones de evaluación de la plataforma para que los clientes y los equipos internos puedan comparar el coste, el tiempo de ejecución y la calidad de las respuestas de cada configuración.






コメント