
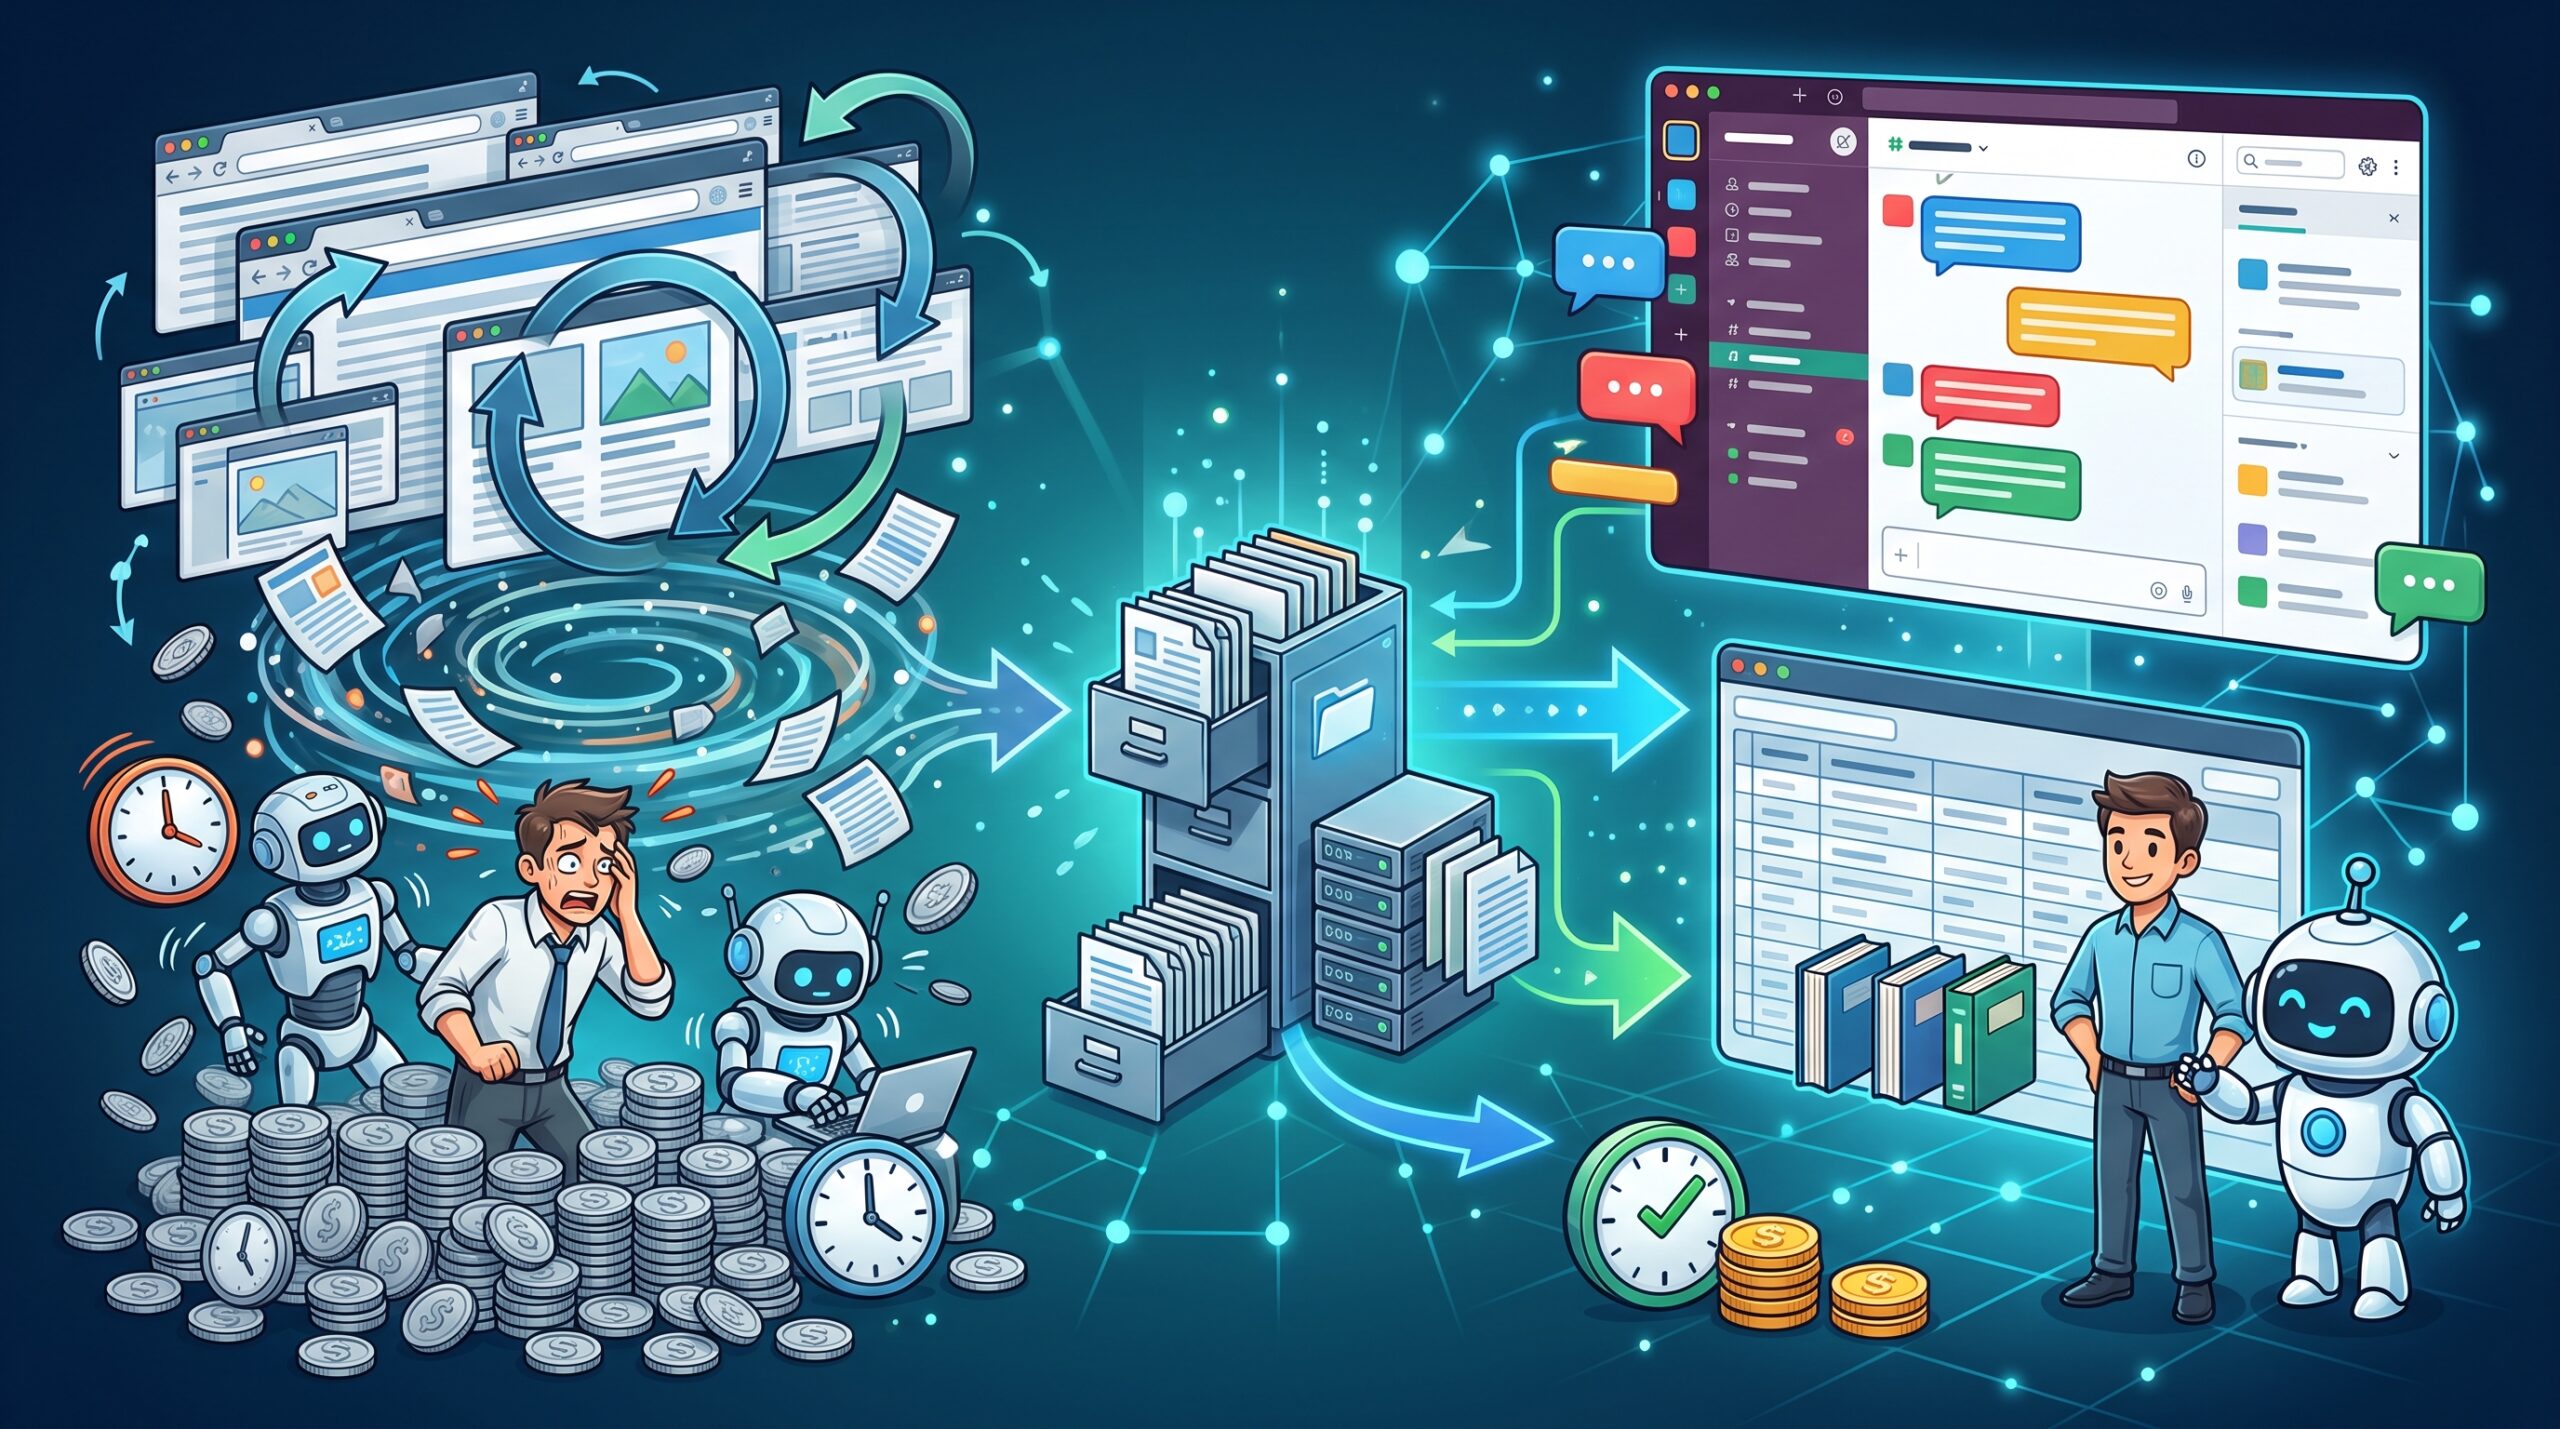
Asana anunció que, en una prueba para optimizar la IA de navegación web de StackAI, la configuración con GPT‑6.1 Sol alcanzó un coste estimado del modelo de 0,47 dólares por ejecución, con una duración de unos 4 minutos. Frente a la configuración inicial de producción, el coste se redujo a aproximadamente una setentaiseisava parte y la velocidad de procesamiento se multiplicó por cinco.
Reducir el coste a 1/76 no se consiguió solo cambiando de modelo
Abrir una página web, buscar la información necesaria y rellenar un formulario. Los agentes de navegación web que realizan este tipo de tareas, a diferencia de una IA que genera una respuesta de una sola vez, llaman al modelo repetidamente durante el trabajo. StackAI, adquirida por Asana, permite a los clientes crear automatizaciones que abarcan varias aplicaciones empresariales sin escribir código.
Lo importante de estas cifras es que la reducción a aproximadamente una setentaiseisava parte combina mejoras en el proceso y un cambio de modelo. Incluso con el modelo B utilizado inicialmente, la optimización redujo el coste estimado del modelo por ejecución de más de 36,21 dólares a 1,24 dólares. Después, al utilizar GPT‑6.1 Sol, el coste bajó a 0,47 dólares. Una parte importante del ahorro se logró antes de cambiar de modelo.
Además, el coste al que se hace referencia aquí es una estimación del coste de uso del modelo. No significa que el coste total, incluidos los gastos de servidor y la mano de obra de desarrollo y operación, se haya reducido en la misma proporción.
Si se recorta demasiado el historial, la IA vuelve a leer las mismas páginas
Frank Hidalgo, CTO de StackAI y responsable de la investigación, pidió a GPT‑6 Astra de Codex que analizara el código y comprobara propuestas de mejora. Uno de los problemas detectados era que, con cada consulta al modelo, se volvían a enviar el contenido de las páginas y el historial de capturas de pantalla. Aunque podían reutilizarse elementos como las instrucciones fijas, no se aplicaba el mismo mecanismo al historial de navegación, que no dejaba de crecer.
Además, casi en cada paso se eliminaban imágenes antiguas y se truncaba el texto. Cuando el historial se modifica con frecuencia, la caché —que permite reutilizar entradas procesadas anteriormente y reducir costes— resulta menos eficaz. Si se elimina demasiada información, la IA también puede volver a visitar páginas que ya ha leído. Así, una estrategia pensada para acortar las entradas podía acabar aumentando el trabajo.
En lugar de borrar las imágenes cada vez, se acumulan 20 antes de organizarlas
En la prueba se fijaron límites de conservación del historial de 120.000 y 480.000 caracteres, y se modificaron las políticas de caché y gestión de imágenes. Se realizaron 144 ejecuciones con cuatro modelos. La tarea era la misma en todos los casos: recopilar seis datos de cada uno de los 32 libros de un catálogo público de demostración.
La configuración optimizada con GPT‑6.1 Sol acumulaba hasta 20 capturas de pantalla y, después, conservaba solo la más reciente. En lugar de eliminar imágenes en cada paso, las organizaba en bloque para ampliar el tiempo durante el cual el historial podía reutilizarse sin cambios.
Incluso comparando únicamente GPT‑6.1 Sol, al revisar la caché y la gestión de imágenes con un límite de conservación del historial más amplio, el coste estimado del modelo bajó de 1,97 dólares a 0,47 dólares. Tras la optimización, el 89 % de las entradas pasó por la caché y esa parte costó el 5 % de lo que cuestan las entradas normales. La clave no fue simplemente reducir la información, sino diseñar el sistema para que la información conservada pudiera reutilizarse con facilidad.
No solo cambió el coste: también mejoró la tasa de finalización
La gestión del historial también influyó en la capacidad de completar las tareas. Con GPT‑6.1 Sol, se generó una respuesta en solo 3 de 18 ejecuciones cuando el límite de conservación era bajo. Con un límite más amplio, se generó una respuesta en las 18 ejecuciones y, según se indicó, todos los resultados fueron correctos.
Aun así, conviene interpretar con cautela la comparación de aproximadamente 1/76 del coste y una velocidad cinco veces mayor. En la configuración inicial hubo ejecuciones que alcanzaron el límite de pasos antes de completarse, por lo que las cifras de más de 36,21 dólares y más de 22,5 minutos son valores mínimos. Además, las principales cifras comparativas son promedios de tres ejecuciones por configuración y corresponden a esta tarea de recopilación de información. No permiten concluir que se obtenga la misma reducción en otros sitios web o tareas.
Cada modelo también destaca en aspectos distintos. Tras la optimización, el modelo C costó 0,66 dólares y tardó 3,5 minutos: fue más caro que GPT‑6.1 Sol, con un coste de 0,47 dólares, pero más rápido que sus aproximadamente 4 minutos. Al implementarlos, es necesario comparar por separado el coste y la velocidad.
La IA realiza las pruebas y las personas revisan los cambios
En esta ocasión, GPT‑6 Astra no solo propuso mejoras, sino que también modificó el código y ejecutó las pruebas para mantener constantes las condiciones del experimento. Otra sesión del modelo revisó el trabajo, y las solicitudes y los resultados se registraron en Command, la plataforma de desarrollo de Asana. Hidalgo señaló que la investigación, que habría llevado entre uno y dos meses de trabajo manual, se completó en aproximadamente una semana. Esta diferencia de plazos se basa en la estimación del responsable y no en un experimento comparativo realizado manualmente.
Este caso muestra que, al calcular los costes operativos de la IA, puede ser tan importante analizar cómo se realizan las llamadas al modelo y cómo se conserva el historial como revisar el precio del modelo. Asana ha incorporado estos cambios a la función de navegación web de StackAI. En el futuro, prevé integrar pruebas en las funciones de evaluación para que los clientes y los equipos internos puedan comparar el coste, el tiempo de ejecución y la calidad de las respuestas de cada configuración.






コメント