
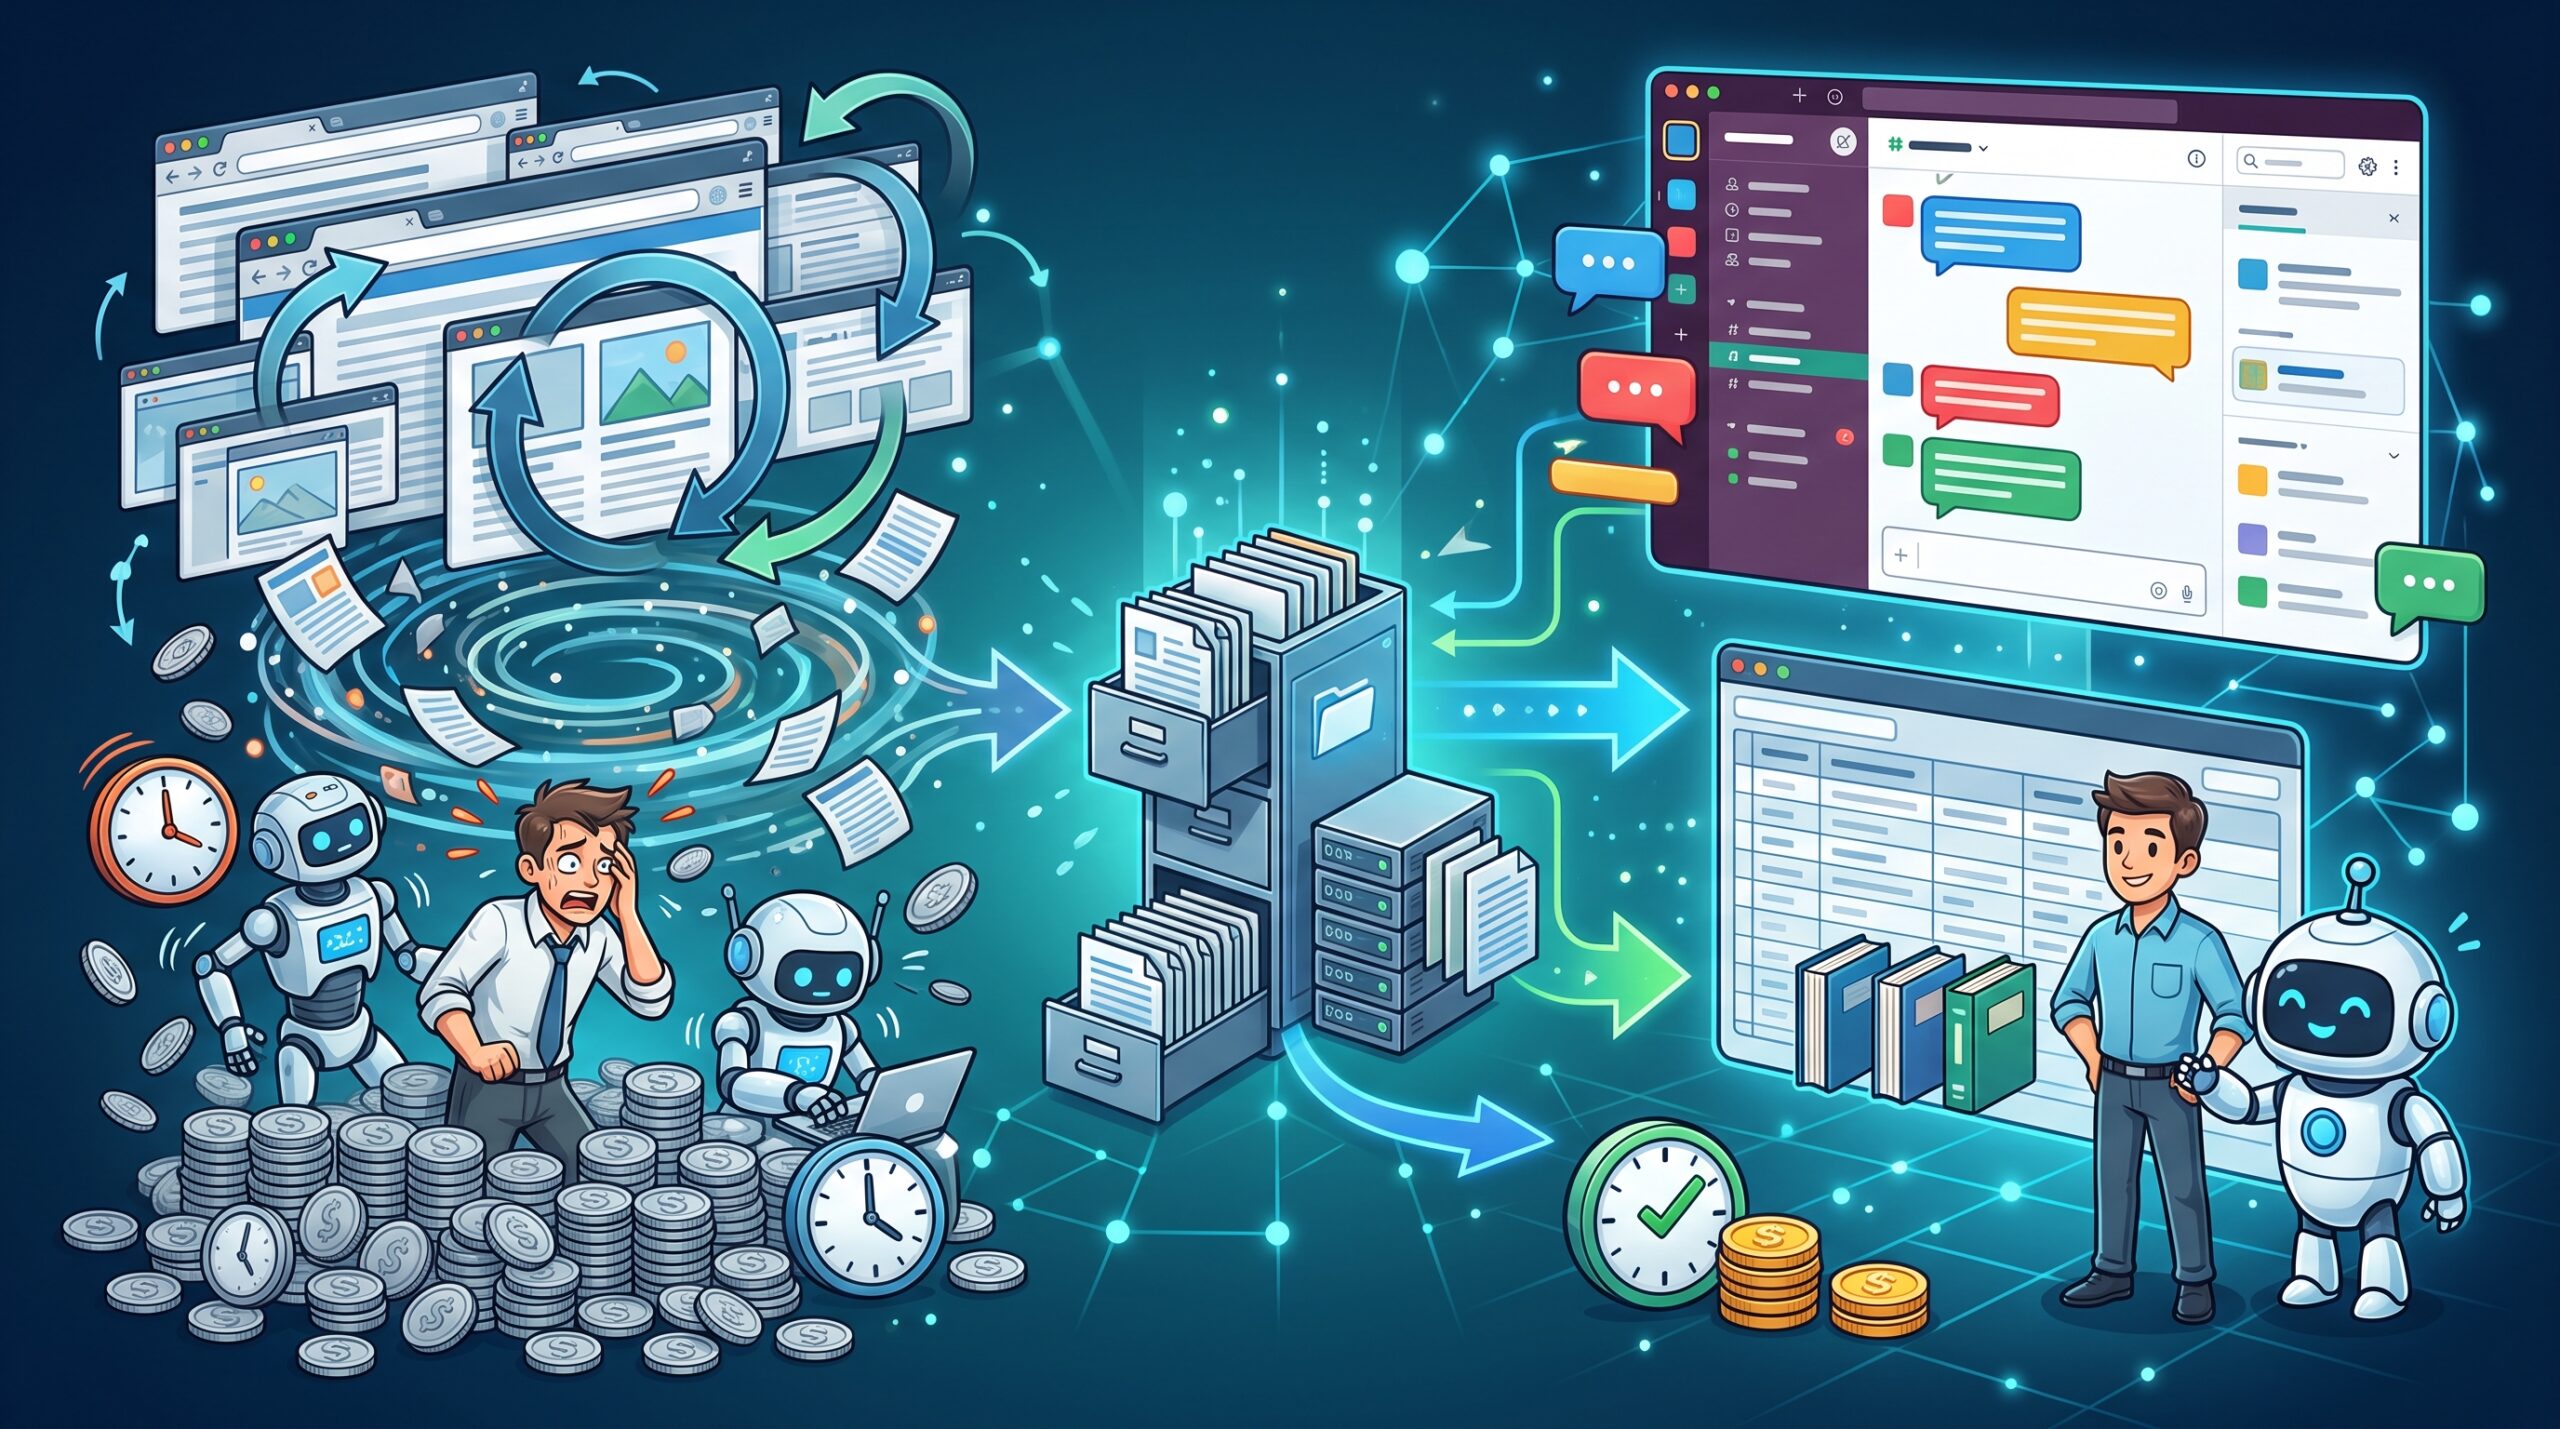
Asana ने बताया कि StackAI के ब्राउज़र संचालन वाले AI को बेहतर बनाने के परीक्षण में GPT‑6.1 Sol का इस्तेमाल करने वाली व्यवस्था की अनुमानित मॉडल लागत प्रति रन औसतन 0.47 डॉलर रही और इसे पूरा होने में लगभग 4 मिनट लगे। शुरुआती प्रोडक्शन व्यवस्था की तुलना में लागत लगभग 1/76 रह गई और प्रक्रिया करीब 5 गुना तेज़ हुई।
लागत 1/76 रहना सिर्फ़ मॉडल बदलने का नतीजा नहीं
वेब पेज खोलना, ज़रूरी जानकारी ढूँढ़ना और फ़ॉर्म भरना—ये ऐसे काम हैं जिन्हें ब्राउज़र एजेंट अपने ज़िम्मे ले सकते हैं। एक बार जवाब तैयार करने वाले AI से अलग, ये एजेंट काम के दौरान मॉडल को बार-बार बुलाते हैं। Asana द्वारा अधिग्रहीत StackAI में ग्राहक बिना कोड लिखे, कई व्यावसायिक ऐप्लिकेशनों में फैले स्वचालन के चरण तैयार कर सकते हैं।
इन आँकड़ों में ध्यान देने वाली बात यह है कि लागत में लगभग 1/76 की कमी में प्रक्रिया में सुधार और मॉडल बदलना, दोनों शामिल हैं। शुरुआत में इस्तेमाल किए गए मॉडल B के साथ भी, अनुकूलन के बाद अनुमानित मॉडल लागत प्रति रन 36.21 डॉलर से अधिक से घटकर 1.24 डॉलर रह गई। इसके बाद GPT‑6.1 Sol इस्तेमाल करने पर लागत 0.47 डॉलर हुई। लागत में बड़ी कमी मॉडल बदलने से पहले ही हासिल कर ली गई थी।
यहाँ बताई गई लागत मॉडल के इस्तेमाल के शुल्क का अनुमान है। इसका मतलब यह नहीं है कि सर्वर खर्च और विकास तथा संचालन से जुड़ी श्रम लागत समेत कुल खर्च भी इसी अनुपात में घट गया।
इतिहास बहुत ज़्यादा घटाने पर AI वही पेज फिर से पढ़ सकता है
जाँच का नेतृत्व करने वाले StackAI के CTO Frank Hidalgo ने Codex में GPT‑6 Astra से कोड का विश्लेषण करने और सुधार के प्रस्तावों की जाँच करने को कहा। सामने आई समस्याओं में से एक यह थी कि हर बार मॉडल से अनुरोध करते समय पेज का मुख्य पाठ और स्क्रीनशॉट का इतिहास फिर से भेजा जा रहा था। स्थिर निर्देशों जैसी कुछ चीज़ों का दोबारा इस्तेमाल हो पा रहा था, लेकिन लगातार बढ़ते ब्राउज़िंग इतिहास के लिए वही व्यवस्था लागू नहीं थी।
इसके अलावा, लगभग हर चरण पर पुरानी तस्वीरें हटाई जा रही थीं और पाठ को छोटा किया जा रहा था। इतिहास में बार-बार बदलाव करने से कैश का असर घटता है—यह कैश पहले संसाधित इनपुट का फिर से इस्तेमाल करके शुल्क कम रखने में मदद करता है। बहुत ज़्यादा जानकारी मिटाने पर AI उस पेज पर दोबारा जा सकता है जिसे वह पहले ही पढ़ चुका हो। इस तरह इनपुट छोटा करने की कोशिश उलटे काम बढ़ा सकती थी।
तस्वीरें हर बार मिटाने के बजाय 20 जमा होने पर उन्हें व्यवस्थित करें
परीक्षण में इतिहास की अधिकतम सीमा 1,20,000 और 4,80,000 वर्ण रखी गई, कैश और तस्वीरों के प्रबंधन के तरीके बदले गए और 4 मॉडल के साथ कुल 144 बार काम चलाया गया। सभी परीक्षणों में एक ही काम दिया गया: सार्वजनिक डेमो कैटलॉग से 32 किताबों के बारे में, हर किताब के लिए 6 जानकारियाँ जुटाना।
GPT‑6.1 Sol की अनुकूलित व्यवस्था में स्क्रीनशॉट 20 तक जमा किए गए और फिर केवल सबसे नया स्क्रीनशॉट रखा गया। हर बार उन्हें हटाने के बजाय एक साथ व्यवस्थित करने से, इतिहास में बदलाव किए बिना उसे दोबारा इस्तेमाल करने की अवधि बढ़ाई गई।
सिर्फ़ GPT‑6.1 Sol की तुलना करने पर भी, इतिहास की बड़ी सीमा वाली स्थिति में कैश और तस्वीरों के प्रबंधन की समीक्षा करने से अनुमानित मॉडल लागत 1.97 डॉलर से घटकर 0.47 डॉलर रह गई। अनुकूलन के बाद 89% इनपुट कैश के ज़रिए आया और उस हिस्से का शुल्क सामान्य इनपुट के शुल्क का 5% था। असर सिर्फ़ जानकारी घटाने से नहीं, बल्कि बची हुई जानकारी को आसानी से दोबारा इस्तेमाल करने लायक बनाने से पड़ा।
सिर्फ़ लागत नहीं, काम पूरा करने की दर भी बदली
इतिहास प्रबंधन का असर इस बात पर भी पड़ा कि काम पूरा हो पाता है या नहीं। GPT‑6.1 Sol के साथ, कम अधिकतम सीमा वाली स्थिति में 18 में से सिर्फ़ 3 बार जवाब तैयार हो पाया। बड़ी सीमा वाली स्थिति में हर 18 बार जवाब तैयार हुआ और सभी नतीजे सही बताए गए।
हालाँकि, लगभग 1/76 और करीब 5 गुना की तुलना को सावधानी से देखना चाहिए। शुरुआती व्यवस्था के कुछ रन काम पूरा होने से पहले ही चरणों की अधिकतम संख्या तक पहुँच गए थे, इसलिए 36.21 डॉलर से अधिक की लागत और 22.5 मिनट से अधिक का समय न्यूनतम सीमा दर्शाते हैं। मुख्य तुलना के आँकड़े भी हर व्यवस्था के 3 रन का औसत हैं और इस बार जानकारी जुटाने के लिए दिए गए काम के नतीजे हैं। यह निष्कर्ष नहीं निकाला जा सकता कि दूसरी वेबसाइटों या कामों में भी लागत इसी अनुपात में घटेगी।
अलग-अलग मॉडल अलग कामों में बेहतर हो सकते हैं। अनुकूलन के बाद मॉडल C ने 0.66 डॉलर की लागत और 3.5 मिनट का समय लिया। GPT‑6.1 Sol के 0.47 डॉलर और लगभग 4 मिनट की तुलना में यह महँगा था, लेकिन काम पूरा करने में कम समय लगा। इस्तेमाल के लिए चुनते समय कम लागत और तेज़ी की अलग-अलग तुलना करनी चाहिए।
AI प्रयोग चलाए, इंसान बदलावों की समीक्षा करे
इस बार GPT‑6 Astra ने सिर्फ़ सुधार के सुझाव नहीं दिए, बल्कि प्रयोग की शर्तें एकसमान रखने के लिए कोड में बदलाव किए और उनकी जाँच भी की। एक अन्य मॉडल सत्र ने काम की समीक्षा की, जबकि अनुरोधों और नतीजों को Asana के विकास मंच Command में दर्ज किया गया। Hidalgo के अनुसार, जिस जाँच में हाथ से काम करने पर 1–2 महीने लगने का अनुमान था, वह लगभग 1 हफ़्ते में पूरी हो गई। इस अवधि का अंतर उनके अनुमान पर आधारित है, न कि इंसानों द्वारा किए गए तुलनात्मक प्रयोग के नतीजे पर।
इस मामले से पता चलता है कि AI के संचालन खर्च पर विचार करते समय, मॉडल की प्रति-इकाई कीमत जितनी ही अहम जाँच यह भी है कि उसे कितनी बार बुलाया जाता है और उसका इतिहास कैसे रखा जाता है। Asana ने इस बार किए गए बदलाव StackAI की ब्राउज़र संचालन सुविधा में लागू कर दिए हैं। आगे कंपनी मूल्यांकन सुविधा में परीक्षण शामिल करने की योजना बना रही है, ताकि ग्राहक और आंतरिक टीमें हर सेटिंग के लिए लागत, काम पूरा करने का समय और जवाबों की गुणवत्ता की तुलना कर सकें।






コメント