
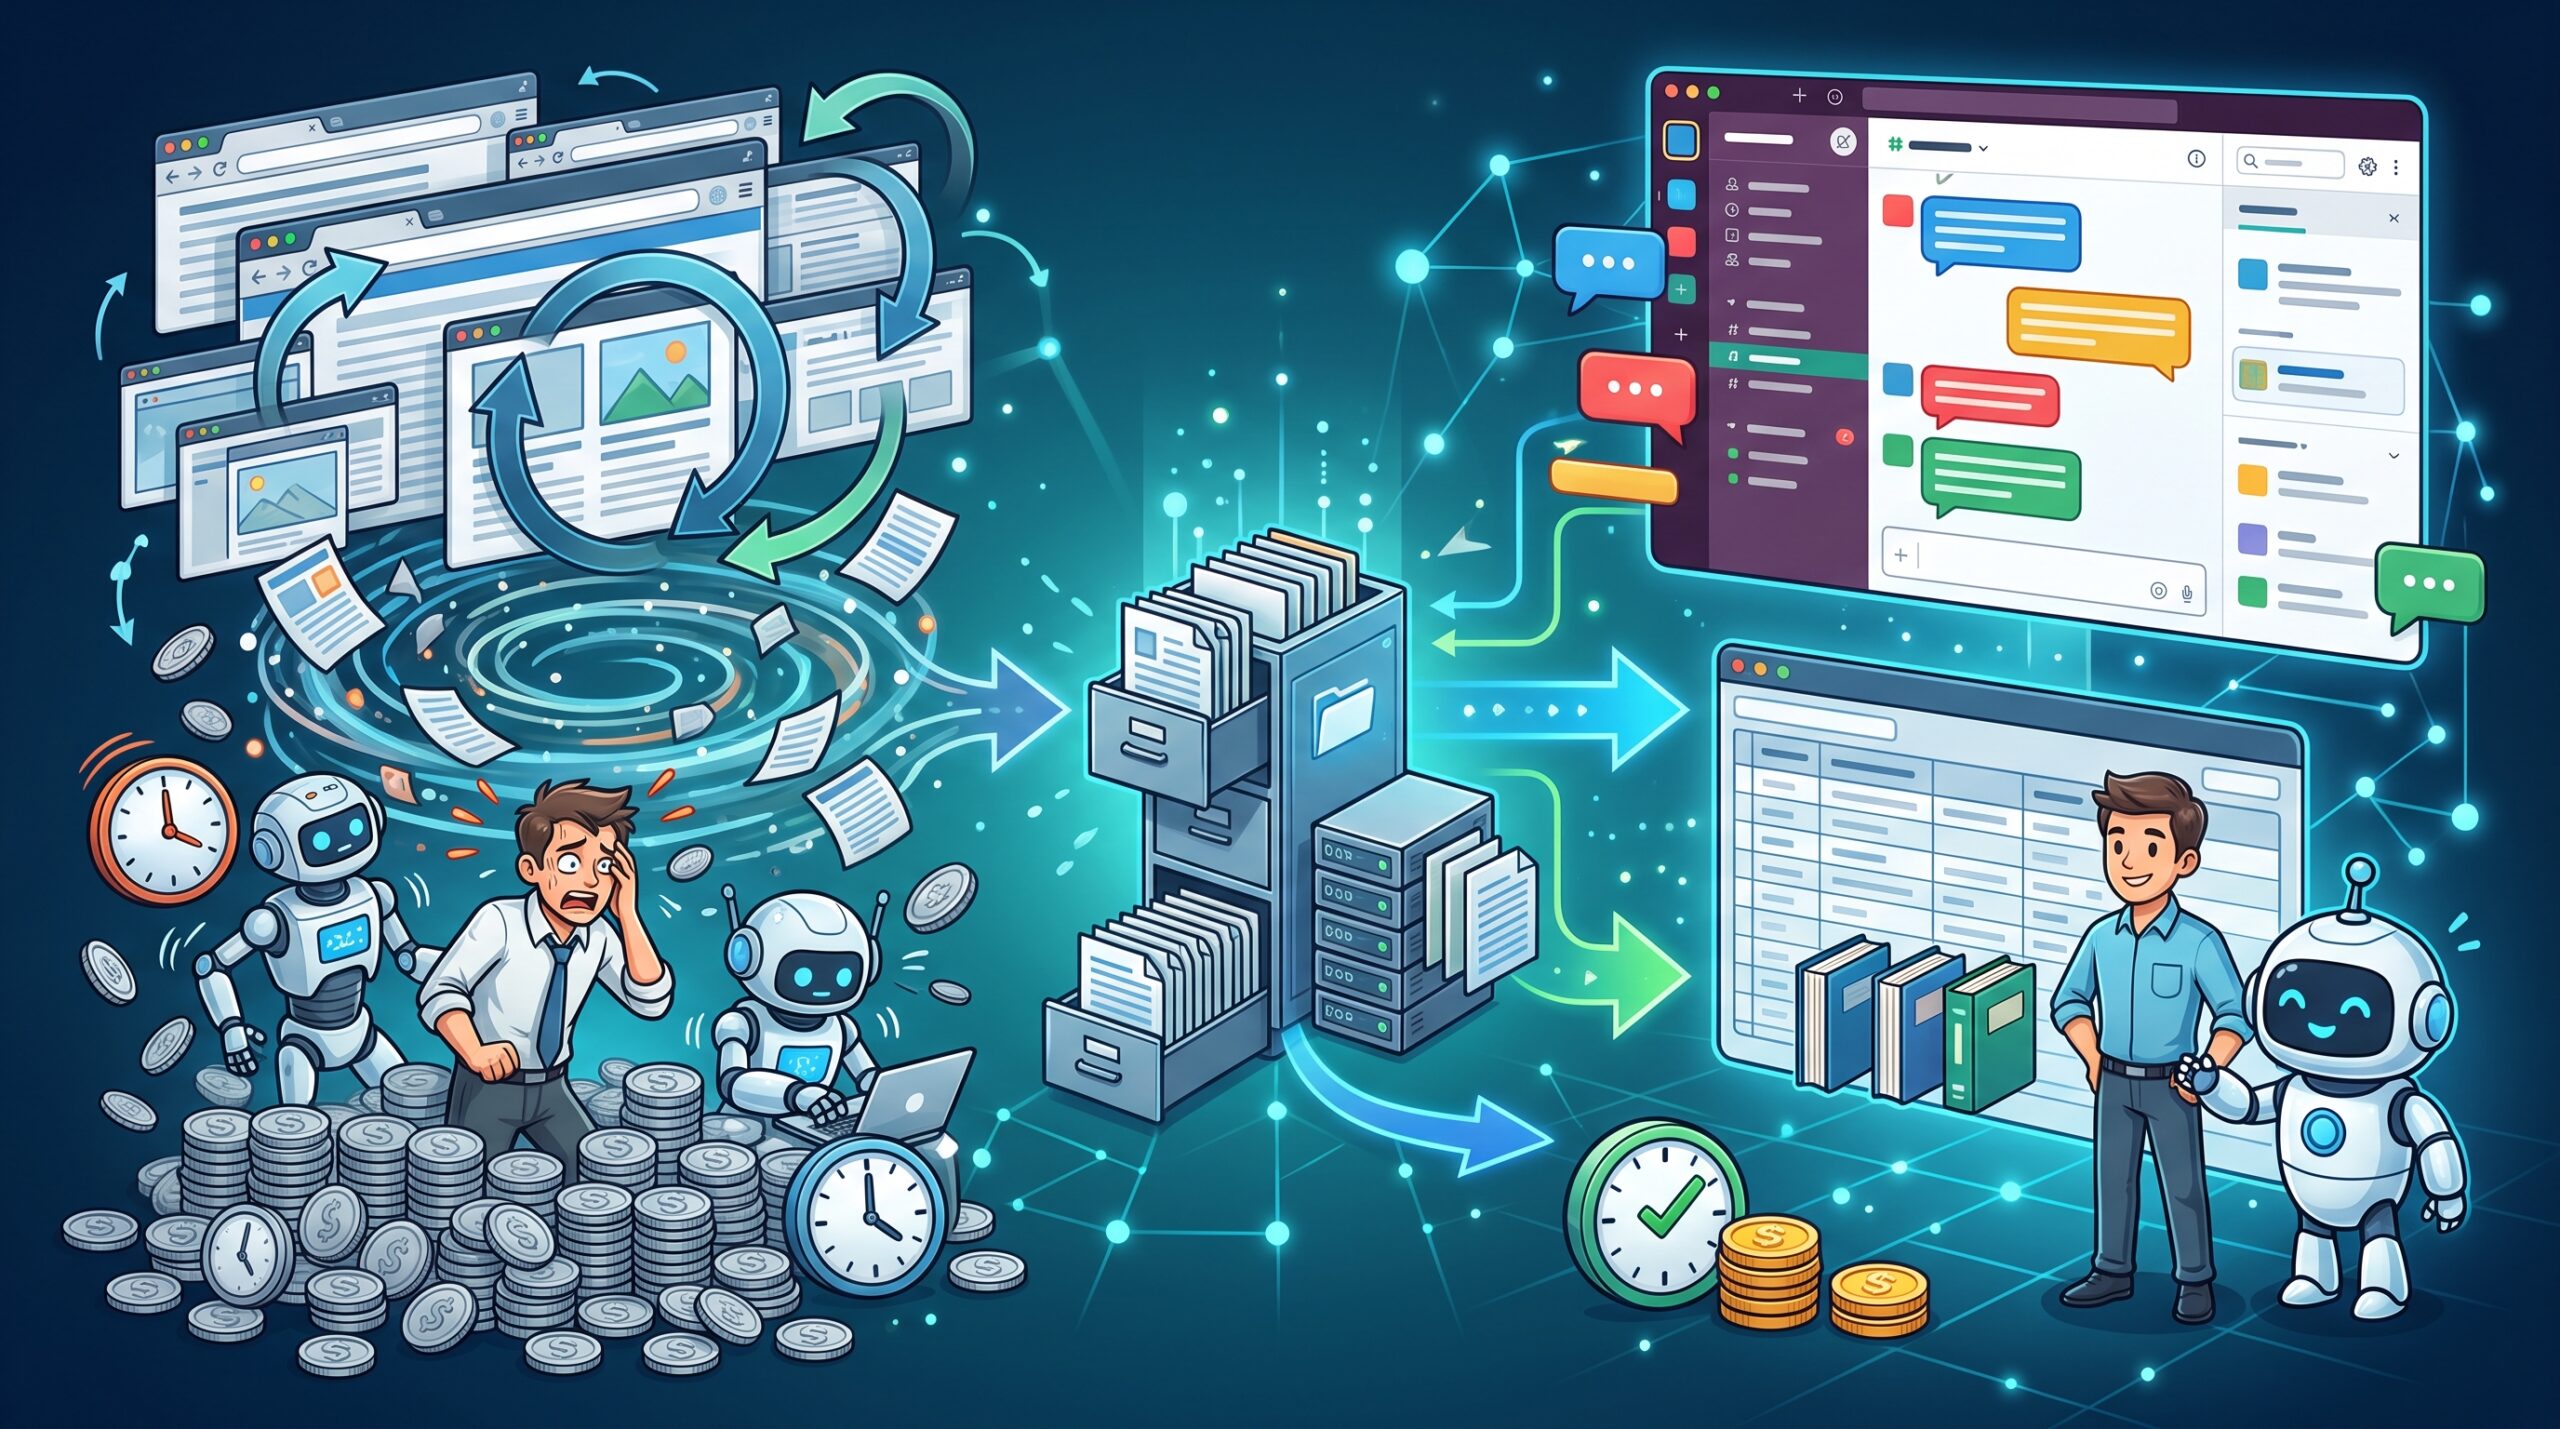
Asana ha annunciato che, in una verifica volta a ottimizzare l’IA di StackAI per il controllo del browser, la configurazione basata su GPT‑6.1 Sol ha registrato un costo medio stimato del modello di 0,47 dollari per esecuzione e un tempo di circa 4 minuti. Rispetto alla configurazione iniziale in produzione, il costo è sceso a circa un settantaseiesimo e la velocità di elaborazione è stata circa cinque volte superiore.
Ridurre i costi a un settantaseiesimo non è merito del solo cambio di modello
Aprire una pagina web, cercare le informazioni necessarie e compilare un modulo. Gli agenti per il browser che svolgono queste operazioni per conto dell’utente, a differenza di un’IA che genera una risposta una sola volta, richiamano il modello ripetutamente nel corso del lavoro. In StackAI, acquisita da Asana, i clienti possono creare senza scrivere codice sequenze di automazione che coinvolgono più applicazioni aziendali.
Il dato da tenere presente è che la riduzione a circa un settantaseiesimo comprende sia il miglioramento delle procedure sia il cambio di modello. Anche mantenendo il modello B usato inizialmente, l’ottimizzazione ha ridotto il costo stimato del modello da oltre 36,21 dollari a 1,24 dollari per esecuzione. Con GPT‑6.1 Sol, il costo è sceso poi a 0,47 dollari. Una parte consistente della riduzione era stata ottenuta prima di cambiare modello.
Inoltre, il costo indicato è una stima del costo di utilizzo del modello. Non significa che il costo totale, comprensivo delle spese per i server e del lavoro necessario allo sviluppo e alla gestione, sia diminuito nella stessa proporzione.
Se si riduce troppo la cronologia, l’IA rilegge le stesse pagine
Frank Hidalgo, CTO di StackAI, ha chiesto a GPT‑6 Astra di Codex di analizzare il codice e verificare proposte di miglioramento. Una delle criticità emerse era che, a ogni richiesta inviata al modello, venivano reinviati il testo delle pagine e la cronologia degli screenshot. Le istruzioni fisse e altri contenuti potevano essere riutilizzati, ma lo stesso meccanismo non era applicato alla cronologia di navigazione, che continuava ad accumularsi.
Inoltre, quasi a ogni passaggio venivano eliminate le immagini più vecchie e tagliato il testo. Modificare spesso la cronologia rende meno efficace la cache, che riduce i costi riutilizzando gli input già elaborati. Se si cancellano troppe informazioni, l’IA può anche tornare su pagine che ha già letto. L’idea di abbreviare gli input rischiava così di aumentare il lavoro.
Le immagini non vengono eliminate a ogni passaggio: si riordinano solo dopo averne accumulate 20
La verifica ha previsto limiti di conservazione della cronologia di 120.000 e 480.000 caratteri e diverse politiche per la cache e la gestione delle immagini. Sono state effettuate 144 esecuzioni in totale con quattro modelli. Il compito era lo stesso in tutti i casi: raccogliere sei informazioni su ciascuno di 32 libri tratti da un catalogo di demo accessibile al pubblico.
Nella configurazione ottimizzata con GPT‑6.1 Sol, gli screenshot venivano accumulati fino a 20, dopodiché si conservava soltanto il più recente. Riordinandoli in blocco invece di eliminarli a ogni passaggio, si è prolungato il periodo in cui la cronologia poteva essere riutilizzata senza modifiche.
Anche confrontando soltanto GPT‑6.1 Sol, rivedere la cache e la gestione delle immagini con un limite di conservazione della cronologia più alto ha ridotto il costo stimato del modello da 1,97 a 0,47 dollari. Dopo l’ottimizzazione, l’89% degli input passava dalla cache e il costo di quella parte era pari al 5% di quello dell’input standard. A fare la differenza è stata una progettazione che rende più facile riutilizzare le informazioni conservate, non semplicemente ridurle.
Non è cambiato solo il costo: anche il tasso di completamento
La gestione della cronologia ha influito anche sulla capacità di portare a termine i compiti. Con GPT‑6.1 Sol, nelle condizioni con un limite di conservazione più basso è stato possibile generare una risposta solo in 3 casi su 18. Con il limite più alto, è stata generata una risposta in tutti e 18 i casi e, secondo quanto riferito, i risultati erano sempre corretti.
Il confronto di circa un settantaseiesimo e circa cinque volte va tuttavia interpretato con cautela. Nella configurazione iniziale erano incluse esecuzioni che avevano raggiunto il limite di passaggi prima di completare il compito: i valori di almeno 36,21 dollari e almeno 22,5 minuti indicano quindi un limite inferiore. Anche i principali valori di confronto sono medie di tre esecuzioni per configurazione e si riferiscono al compito di raccolta di informazioni svolto in questa verifica. Non si può concludere che la stessa riduzione si ottenga anche su altri siti o per altre attività.
I modelli hanno anche punti di forza diversi. Dopo l’ottimizzazione, il modello C ha impiegato 3,5 minuti e ha avuto un costo di 0,66 dollari: è risultato più costoso di GPT‑6.1 Sol, che è costato 0,47 dollari e ha impiegato circa 4 minuti, ma ha completato l’esecuzione più rapidamente. In fase di adozione occorre confrontare separatamente costo e velocità.
L’IA conduce gli esperimenti, le persone verificano le modifiche
GPT‑6 Astra non si è limitato a proporre miglioramenti: ha anche modificato il codice per uniformare le condizioni sperimentali e lanciato le verifiche. Un’altra sessione del modello ha revisionato il lavoro, mentre richieste e risultati sono stati registrati nell’infrastruttura di sviluppo di Asana, Command. Hidalgo afferma che un’indagine stimata in 1-2 mesi di lavoro manuale è stata completata in circa una settimana. Questa differenza di tempi è una stima del responsabile, non il risultato di un esperimento comparativo condotto manualmente.
Da questo caso si evince che, per valutare i costi operativi dell’IA, vale la pena esaminare le modalità di chiamata del modello e la gestione della cronologia tanto quanto il costo unitario del modello. Asana ha integrato questa modifica nella funzionalità di controllo del browser di StackAI. In futuro prevede di integrare test nella funzione di valutazione, così che clienti e team interni possano confrontare costi, tempi di esecuzione e qualità delle risposte per ciascuna configurazione.






コメント