
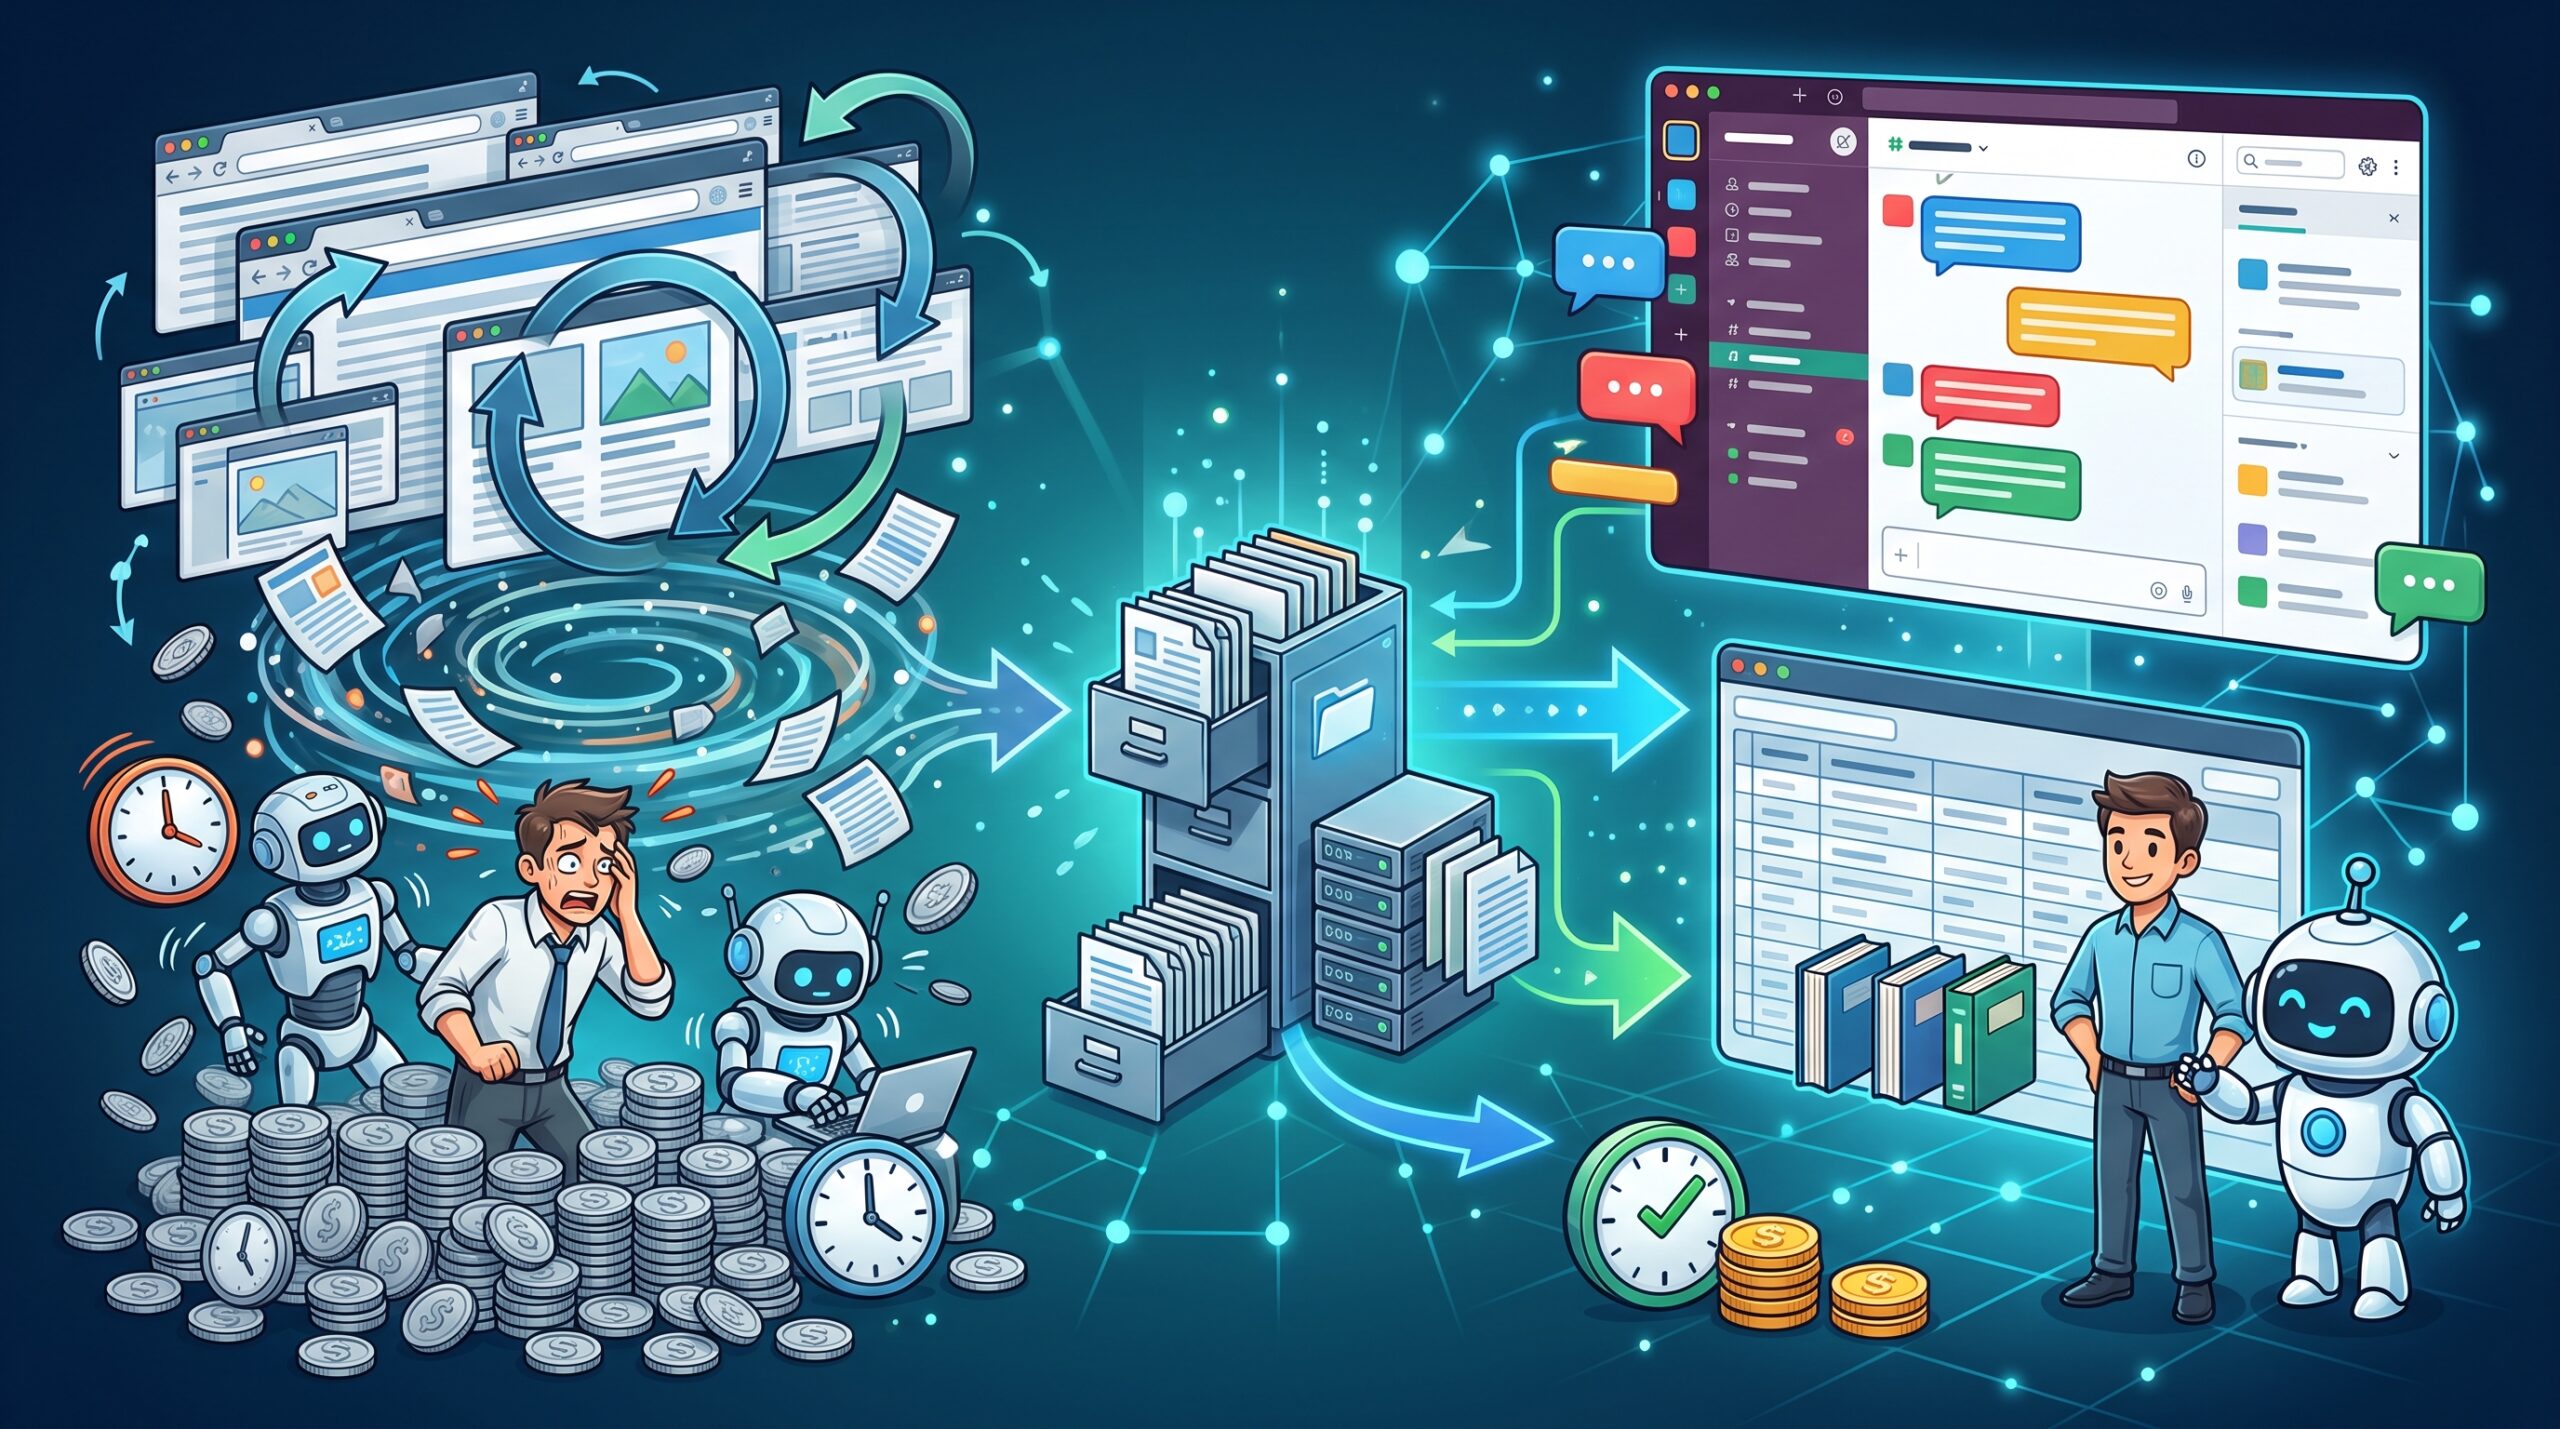
Asana a annoncé qu’un test d’optimisation de l’agent IA de navigation de StackAI avait ramené le coût estimé d’utilisation du modèle à 0,47 dollar en moyenne par exécution et la durée d’exécution à environ 4 minutes dans une configuration utilisant GPT‑6.1 Sol. Par rapport à la configuration initialement déployée en production, le coût a été divisé par environ 76 et la vitesse de traitement multipliée par environ cinq.
La division par 76 ne s’explique pas seulement par le changement de modèle
Ouvrir une page web, chercher les informations nécessaires, remplir un formulaire : les agents de navigation qui réalisent ce type d’opérations font appel au modèle à plusieurs reprises au cours de leur travail, contrairement à une IA qui génère une réponse en une seule fois. Chez StackAI, racheté par Asana, les clients peuvent créer sans écrire de code des séquences d’automatisation faisant intervenir plusieurs applications métier.
Le point à retenir de ces chiffres est que la réduction d’environ 76 fois combine à la fois une amélioration du processus et un changement de modèle. Avec le modèle B utilisé au départ, l’optimisation a déjà fait passer le coût estimé d’utilisation du modèle de plus de 36,21 dollars à 1,24 dollar par exécution. L’utilisation de GPT‑6.1 Sol l’a ensuite ramené à 0,47 dollar. Une grande partie de la réduction a donc été obtenue avant même le changement de modèle.
Le coût évoqué ici est une estimation des frais d’utilisation du modèle. Cela ne signifie pas que le coût total, comprenant les frais de serveur et les coûts de développement et d’exploitation, a diminué dans les mêmes proportions.
Si l’on réduit trop l’historique, l’IA relit les mêmes pages
Frank Hidalgo, directeur technique de StackAI, qui a mené l’étude, a demandé à GPT‑6 Astra de Codex d’analyser le code et de vérifier des pistes d’amélioration. L’un des problèmes relevés était que le contenu des pages et les captures d’écran de l’historique étaient renvoyés au modèle à chaque requête. Certaines données, comme les instructions fixes, pouvaient être réutilisées, mais pas l’historique de navigation, qui ne cessait de s’allonger.
En outre, les anciennes images étaient supprimées et le texte tronqué presque à chaque étape. La réécriture fréquente de l’historique complique l’utilisation du cache, qui permet de réduire les frais en réutilisant les données déjà traitées. Si trop d’informations sont supprimées, l’IA risque aussi de revenir sur des pages qu’elle a déjà lues. Une méthode censée raccourcir les entrées pouvait donc, au contraire, ajouter du travail.
Ne pas supprimer les images à chaque fois : attendre d’en avoir 20 avant de les trier
Lors des tests, les limites de conservation de l’historique ont été fixées à 120 000 et 480 000 caractères, tandis que les paramètres du cache et de la gestion des images ont été modifiés. Au total, 144 exécutions ont été réalisées avec quatre modèles. La tâche était la même pour tous : recueillir six informations sur chacun des 32 livres d’un catalogue de démonstration public.
La configuration optimisée avec GPT‑6.1 Sol accumulait jusqu’à 20 captures d’écran, puis ne conservait que la plus récente. Au lieu de supprimer les images à chaque fois, cette organisation les trie par lots et prolonge ainsi la période pendant laquelle l’historique peut être réutilisé sans modification.
Même en comparant uniquement GPT‑6.1 Sol, la révision du cache et de la gestion des images, avec une limite de conservation de l’historique plus élevée, a fait passer le coût estimé d’utilisation du modèle de 1,97 dollar à 0,47 dollar. Après optimisation, 89 % des entrées ont été traitées par le cache ; leur coût représentait 5 % de celui des entrées ordinaires. L’efficacité vient d’une conception qui facilite la réutilisation des informations conservées, et non du simple fait d’en réduire la quantité.
La baisse des coûts s’est accompagnée d’une amélioration du taux de réussite
La gestion de l’historique a également influé sur la capacité à achever les tâches. Avec GPT‑6.1 Sol, une réponse a pu être générée dans seulement 3 des 18 exécutions lorsque la limite de conservation était basse. Avec une limite plus élevée, une réponse a été générée lors des 18 exécutions, et toutes étaient correctes, selon Asana.
Il convient toutefois de nuancer la comparaison d’une réduction d’environ 76 fois et d’une vitesse multipliée par environ cinq. Dans la configuration initiale, certaines exécutions avaient atteint la limite du nombre d’étapes avant d’être terminées : les chiffres de plus de 36,21 dollars et de plus de 22,5 minutes sont donc des minimums. Les principales valeurs comparées sont par ailleurs des moyennes de trois exécutions par configuration et correspondent aux résultats obtenus pour cette tâche de collecte d’informations. Rien ne permet d’affirmer que la réduction sera identique sur d’autres sites ou pour d’autres activités.
Les modèles ont également des points forts différents. Après optimisation, le modèle C a coûté 0,66 dollar et pris 3,5 minutes : il était plus cher que GPT‑6.1 Sol, à 0,47 dollar et environ 4 minutes, mais plus rapide. Lors du déploiement, il faut donc comparer séparément le coût et la vitesse.
L’IA mène les expériences, les humains vérifient les modifications
GPT‑6 Astra a non seulement proposé des améliorations, mais aussi modifié le code et exécuté les tests nécessaires pour garantir des conditions expérimentales cohérentes. Une autre session de modèle a examiné le travail, tandis que les requêtes et les résultats étaient consignés dans Command, l’environnement de développement d’Asana. Frank Hidalgo estime qu’une étude qui aurait demandé un à deux mois de travail manuel a été menée en environ une semaine. Cette différence de durée repose sur son estimation et non sur les résultats d’une expérience comparative menée manuellement.
Cet exemple montre que, pour évaluer les coûts d’exploitation de l’IA, il peut être aussi utile d’examiner la manière dont les modèles sont sollicités et l’historique qui leur est transmis que le tarif des modèles eux-mêmes. Asana a intégré ces changements à la fonctionnalité de contrôle du navigateur de StackAI. L’entreprise prévoit maintenant d’ajouter des tests à ses outils d’évaluation afin que ses clients et ses équipes internes puissent comparer, selon les paramètres choisis, les coûts, la durée d’exécution et la qualité des réponses.






コメント