
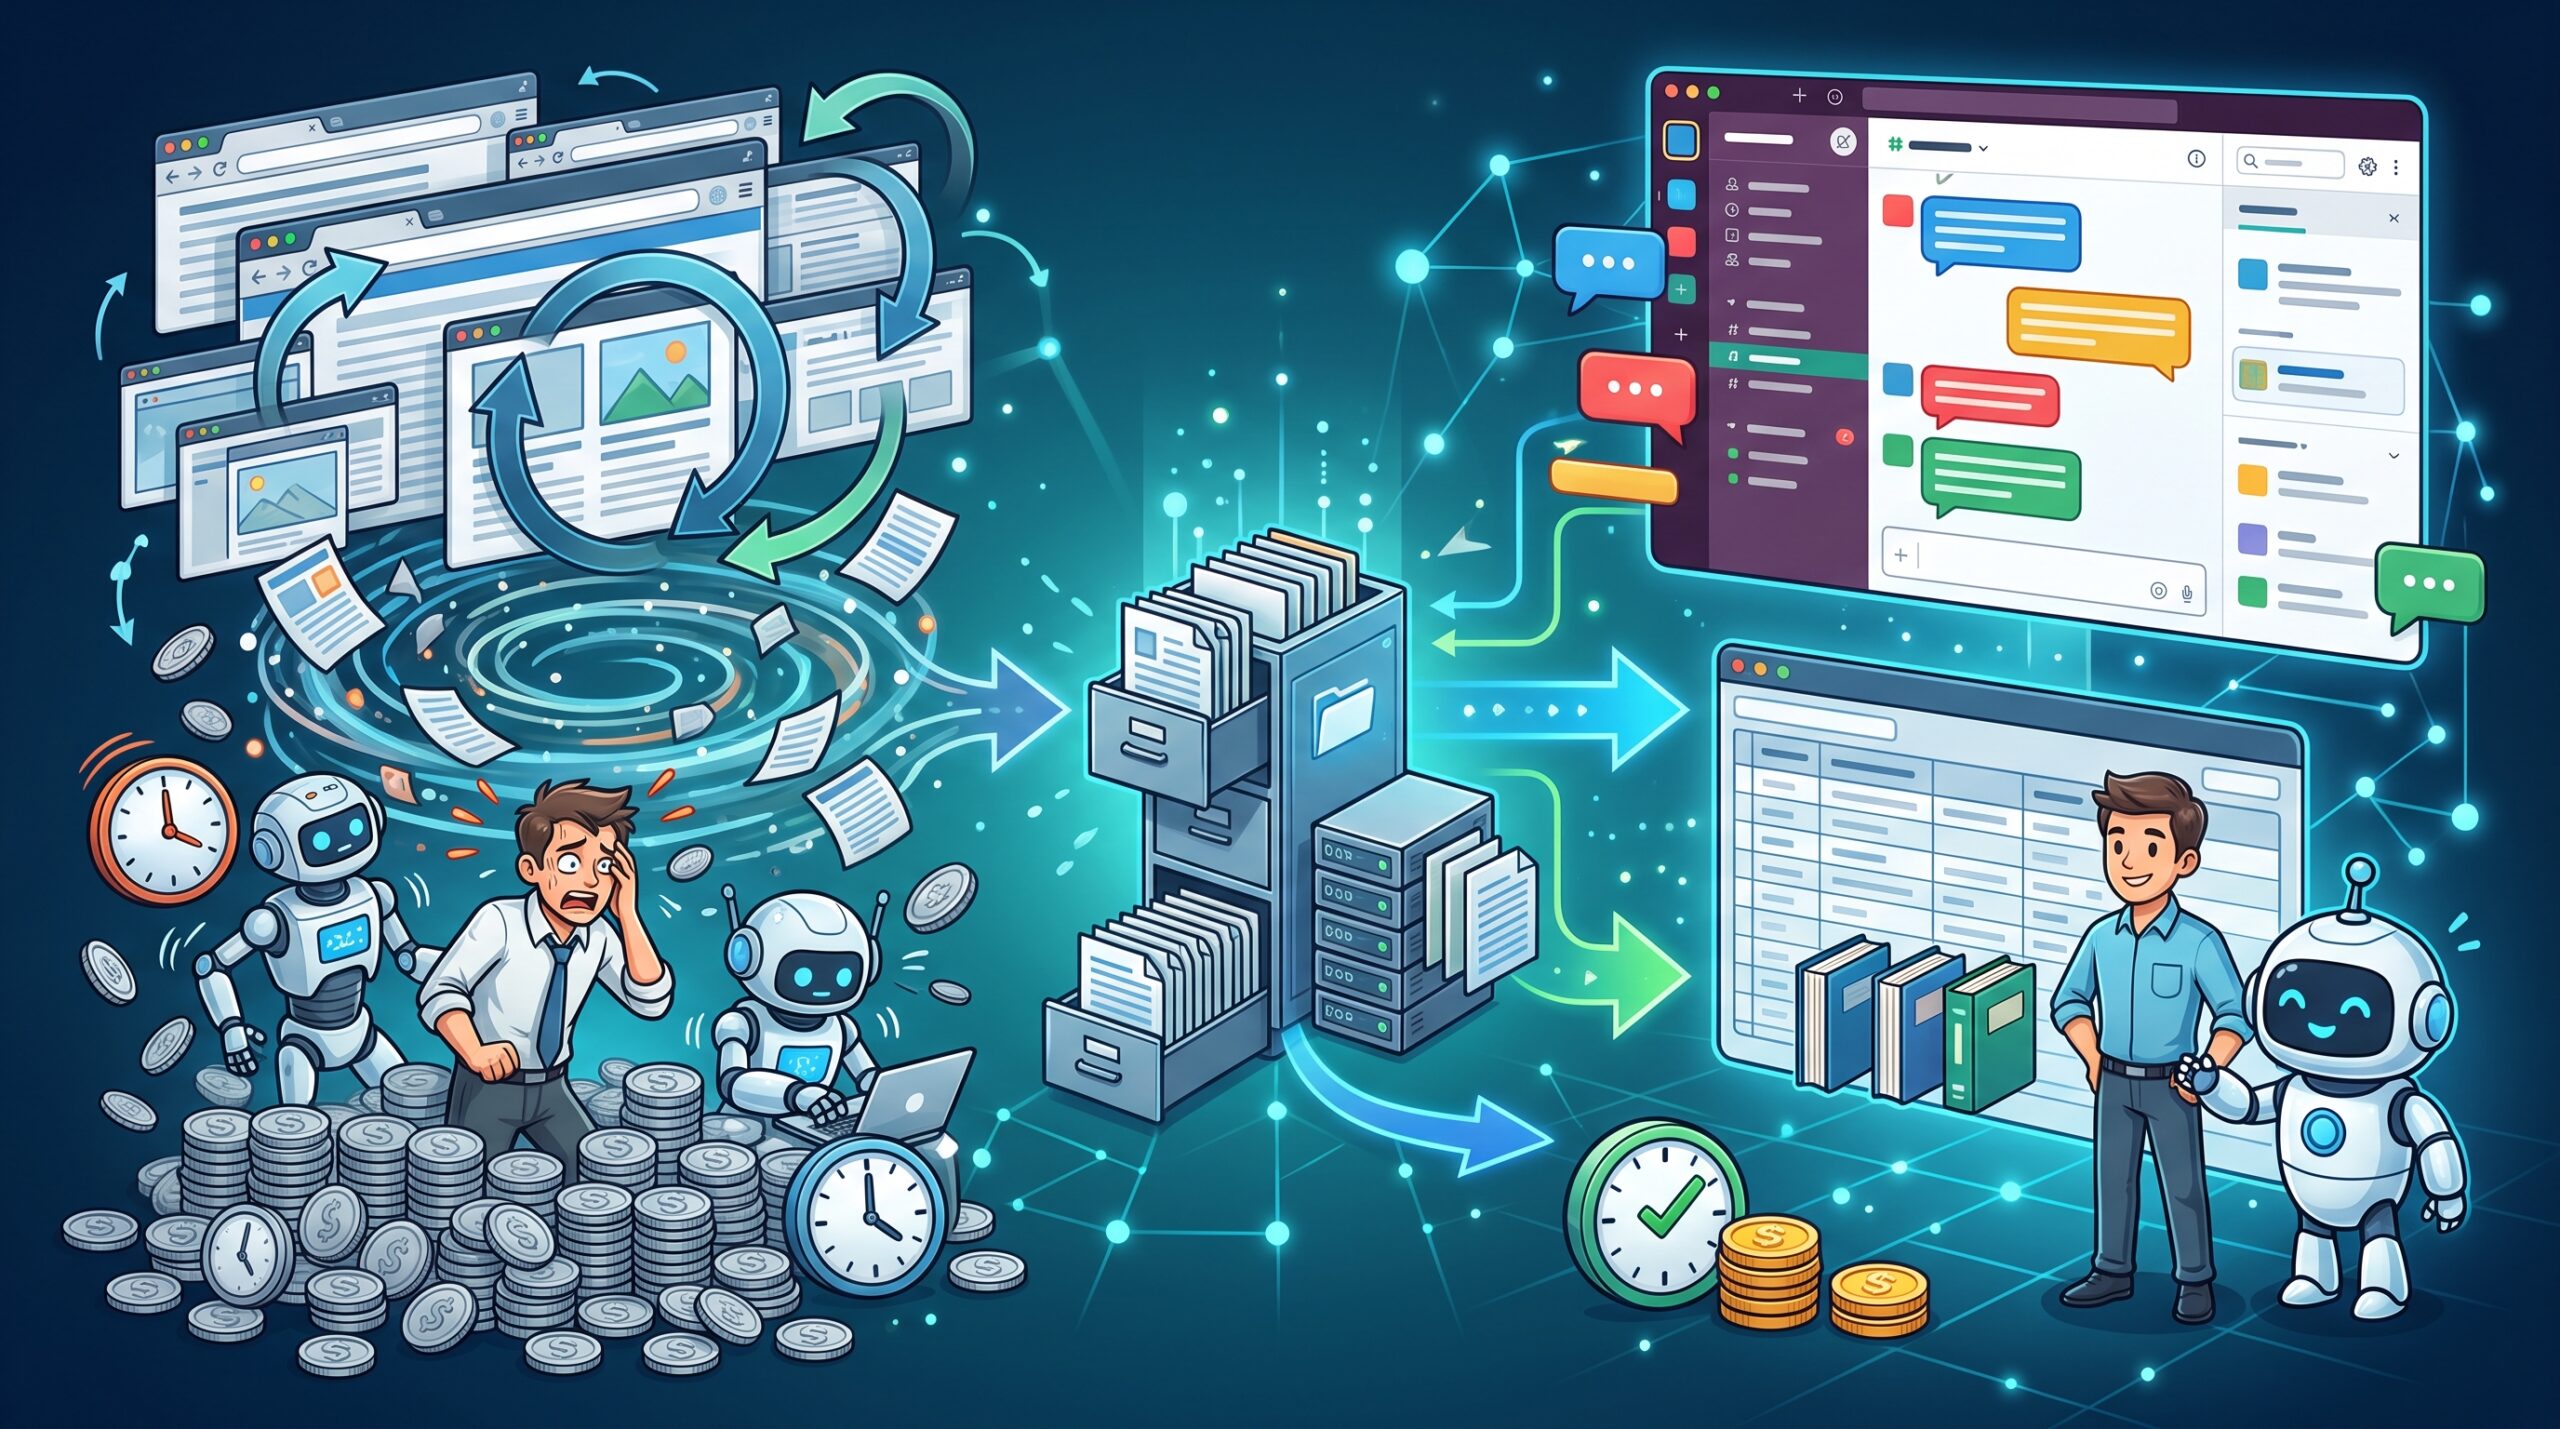
A Asana anunciou que, numa avaliação para otimizar a IA de navegação do StackAI, a configuração com GPT‑6.1 Sol alcançou um custo estimado do modelo médio de 0,47 dólares por execução e um tempo de execução de cerca de 4 minutos. Em comparação com a configuração inicial de produção, o custo passou para cerca de 1/76 e o processamento tornou-se aproximadamente cinco vezes mais rápido.
A redução para 1/76 não se deveu apenas à mudança de modelo
Abrir uma página Web, procurar as informações necessárias e preencher um formulário. Ao contrário de uma IA que gera uma resposta de uma só vez, os agentes de navegação que executam este tipo de tarefas chamam o modelo repetidamente durante o trabalho. No StackAI, adquirido pela Asana, os clientes podem criar fluxos de automatização que abrangem várias aplicações empresariais sem escrever código.
O dado a destacar é que a redução de cerca de 1/76 inclui tanto melhorias nos procedimentos de processamento como a mudança de modelo. Mesmo com o modelo B utilizado inicialmente, a otimização reduziu o custo estimado do modelo por execução de 36,21 dólares ou mais para 1,24 dólares. Depois, com o GPT‑6.1 Sol, o valor baixou para 0,47 dólares. Uma parte significativa da redução foi alcançada antes da mudança de modelo.
Além disso, o custo referido é uma estimativa do custo de utilização do modelo. Não significa que o custo total, incluindo despesas de servidor e custos de pessoal de desenvolvimento e operação, tenha diminuído na mesma proporção.
Se o histórico for reduzido em excesso, a IA volta a ler as mesmas páginas
Frank Hidalgo, CTO do StackAI e responsável pela investigação, pediu ao GPT‑6 Astra do Codex que analisasse o código e testasse propostas de melhoria. Um dos problemas identificados era o reenvio do conteúdo das páginas e do histórico de capturas de ecrã sempre que o modelo era consultado. As instruções fixas, por exemplo, podiam ser reutilizadas, mas o mesmo mecanismo não era aplicado ao histórico de navegação, que continuava a crescer.
Além disso, quase todos os passos incluíam a eliminação de imagens antigas e o truncamento do texto. Quando o histórico é alterado com frequência, a cache — que permite reutilizar entradas já processadas e reduzir os custos — torna-se menos eficaz. Se forem eliminadas demasiadas informações, a IA pode voltar a visitar páginas que já leu. Assim, uma tentativa de encurtar as entradas podia, na verdade, aumentar o trabalho.
Em vez de eliminar as imagens a cada passo, organizá-las quando se acumulam 20
Na avaliação, foram definidos limites de retenção do histórico de 120 mil e 480 mil caracteres, e foram alteradas as políticas de cache e de gestão de imagens. Foram realizadas 144 execuções com quatro modelos. A tarefa era a mesma para todos: recolher seis informações sobre cada um de 32 livros do catálogo de demonstração público.
Na configuração otimizada com GPT‑6.1 Sol, as capturas de ecrã eram acumuladas até 20 e, em seguida, mantinha-se apenas a mais recente. Em vez de as eliminar a cada passo, eram organizadas em conjunto, prolongando o período em que o histórico podia ser reutilizado sem alterações.
Mesmo comparando apenas o GPT‑6.1 Sol, a revisão da cache e da gestão de imagens, com um limite de retenção do histórico mais elevado, reduziu o custo estimado do modelo de 1,97 dólares para 0,47 dólares. Após a otimização, 89% das entradas passaram pela cache, e o custo dessa parte foi 5% do custo normal das entradas. O que fez a diferença foi uma conceção que facilita a reutilização das informações retidas, em vez de simplesmente reduzir a quantidade de informação.
Mudou não só o custo, mas também a taxa de conclusão
A gestão do histórico também influenciou a capacidade de concluir as tarefas. Com o GPT‑6.1 Sol e um limite de retenção menor, só foi possível gerar uma resposta em três das 18 execuções. Com um limite maior, foram geradas respostas nas 18 execuções, todas com resultados corretos, segundo a empresa.
Ainda assim, é preciso ter cautela com a comparação de cerca de 1/76 e cinco vezes mais rápido. A configuração inicial incluía execuções que atingiram o limite de passos antes de concluir a tarefa, pelo que os valores de 36,21 dólares ou mais e 22,5 minutos ou mais indicam limites mínimos. Os principais valores de comparação são também médias de três execuções por configuração e correspondem à tarefa de recolha de informações realizada nesta avaliação. Não é possível concluir que a mesma redução se aplicará a outros sites ou tarefas empresariais.
Os pontos fortes também variam consoante o modelo. Após a otimização, o modelo C custou 0,66 dólares e demorou 3,5 minutos: foi mais caro do que o GPT‑6.1 Sol, que custou 0,47 dólares e demorou cerca de 4 minutos, mas concluiu a execução mais depressa. Na implementação, é necessário comparar separadamente o custo e a velocidade.
A IA executa as experiências e as pessoas confirmam as alterações
Neste caso, o GPT‑6 Astra não se limitou a apresentar propostas de melhoria: também alterou o código para uniformizar as condições das experiências e executou a validação. Outra sessão do modelo reviu o trabalho, e os pedidos e resultados foram registados no Command, a plataforma de desenvolvimento da Asana. Hidalgo afirmou que a investigação, que estimava levar um a dois meses se fosse feita manualmente, ficou concluída em cerca de uma semana. Esta diferença de duração é uma estimativa do responsável, não o resultado de uma experiência comparativa realizada por pessoas.
O que este caso mostra é que, ao analisar os custos de operação da IA, há margem para investigar a forma como o modelo é chamado e como o histórico é mantido, tanto quanto o preço unitário do modelo. A Asana aplicou estas alterações à funcionalidade de navegação do StackAI. No futuro, prevê incorporar testes na funcionalidade de avaliação, para que os clientes e as equipas internas possam comparar o custo, o tempo de execução e a qualidade das respostas em cada configuração.






コメント