
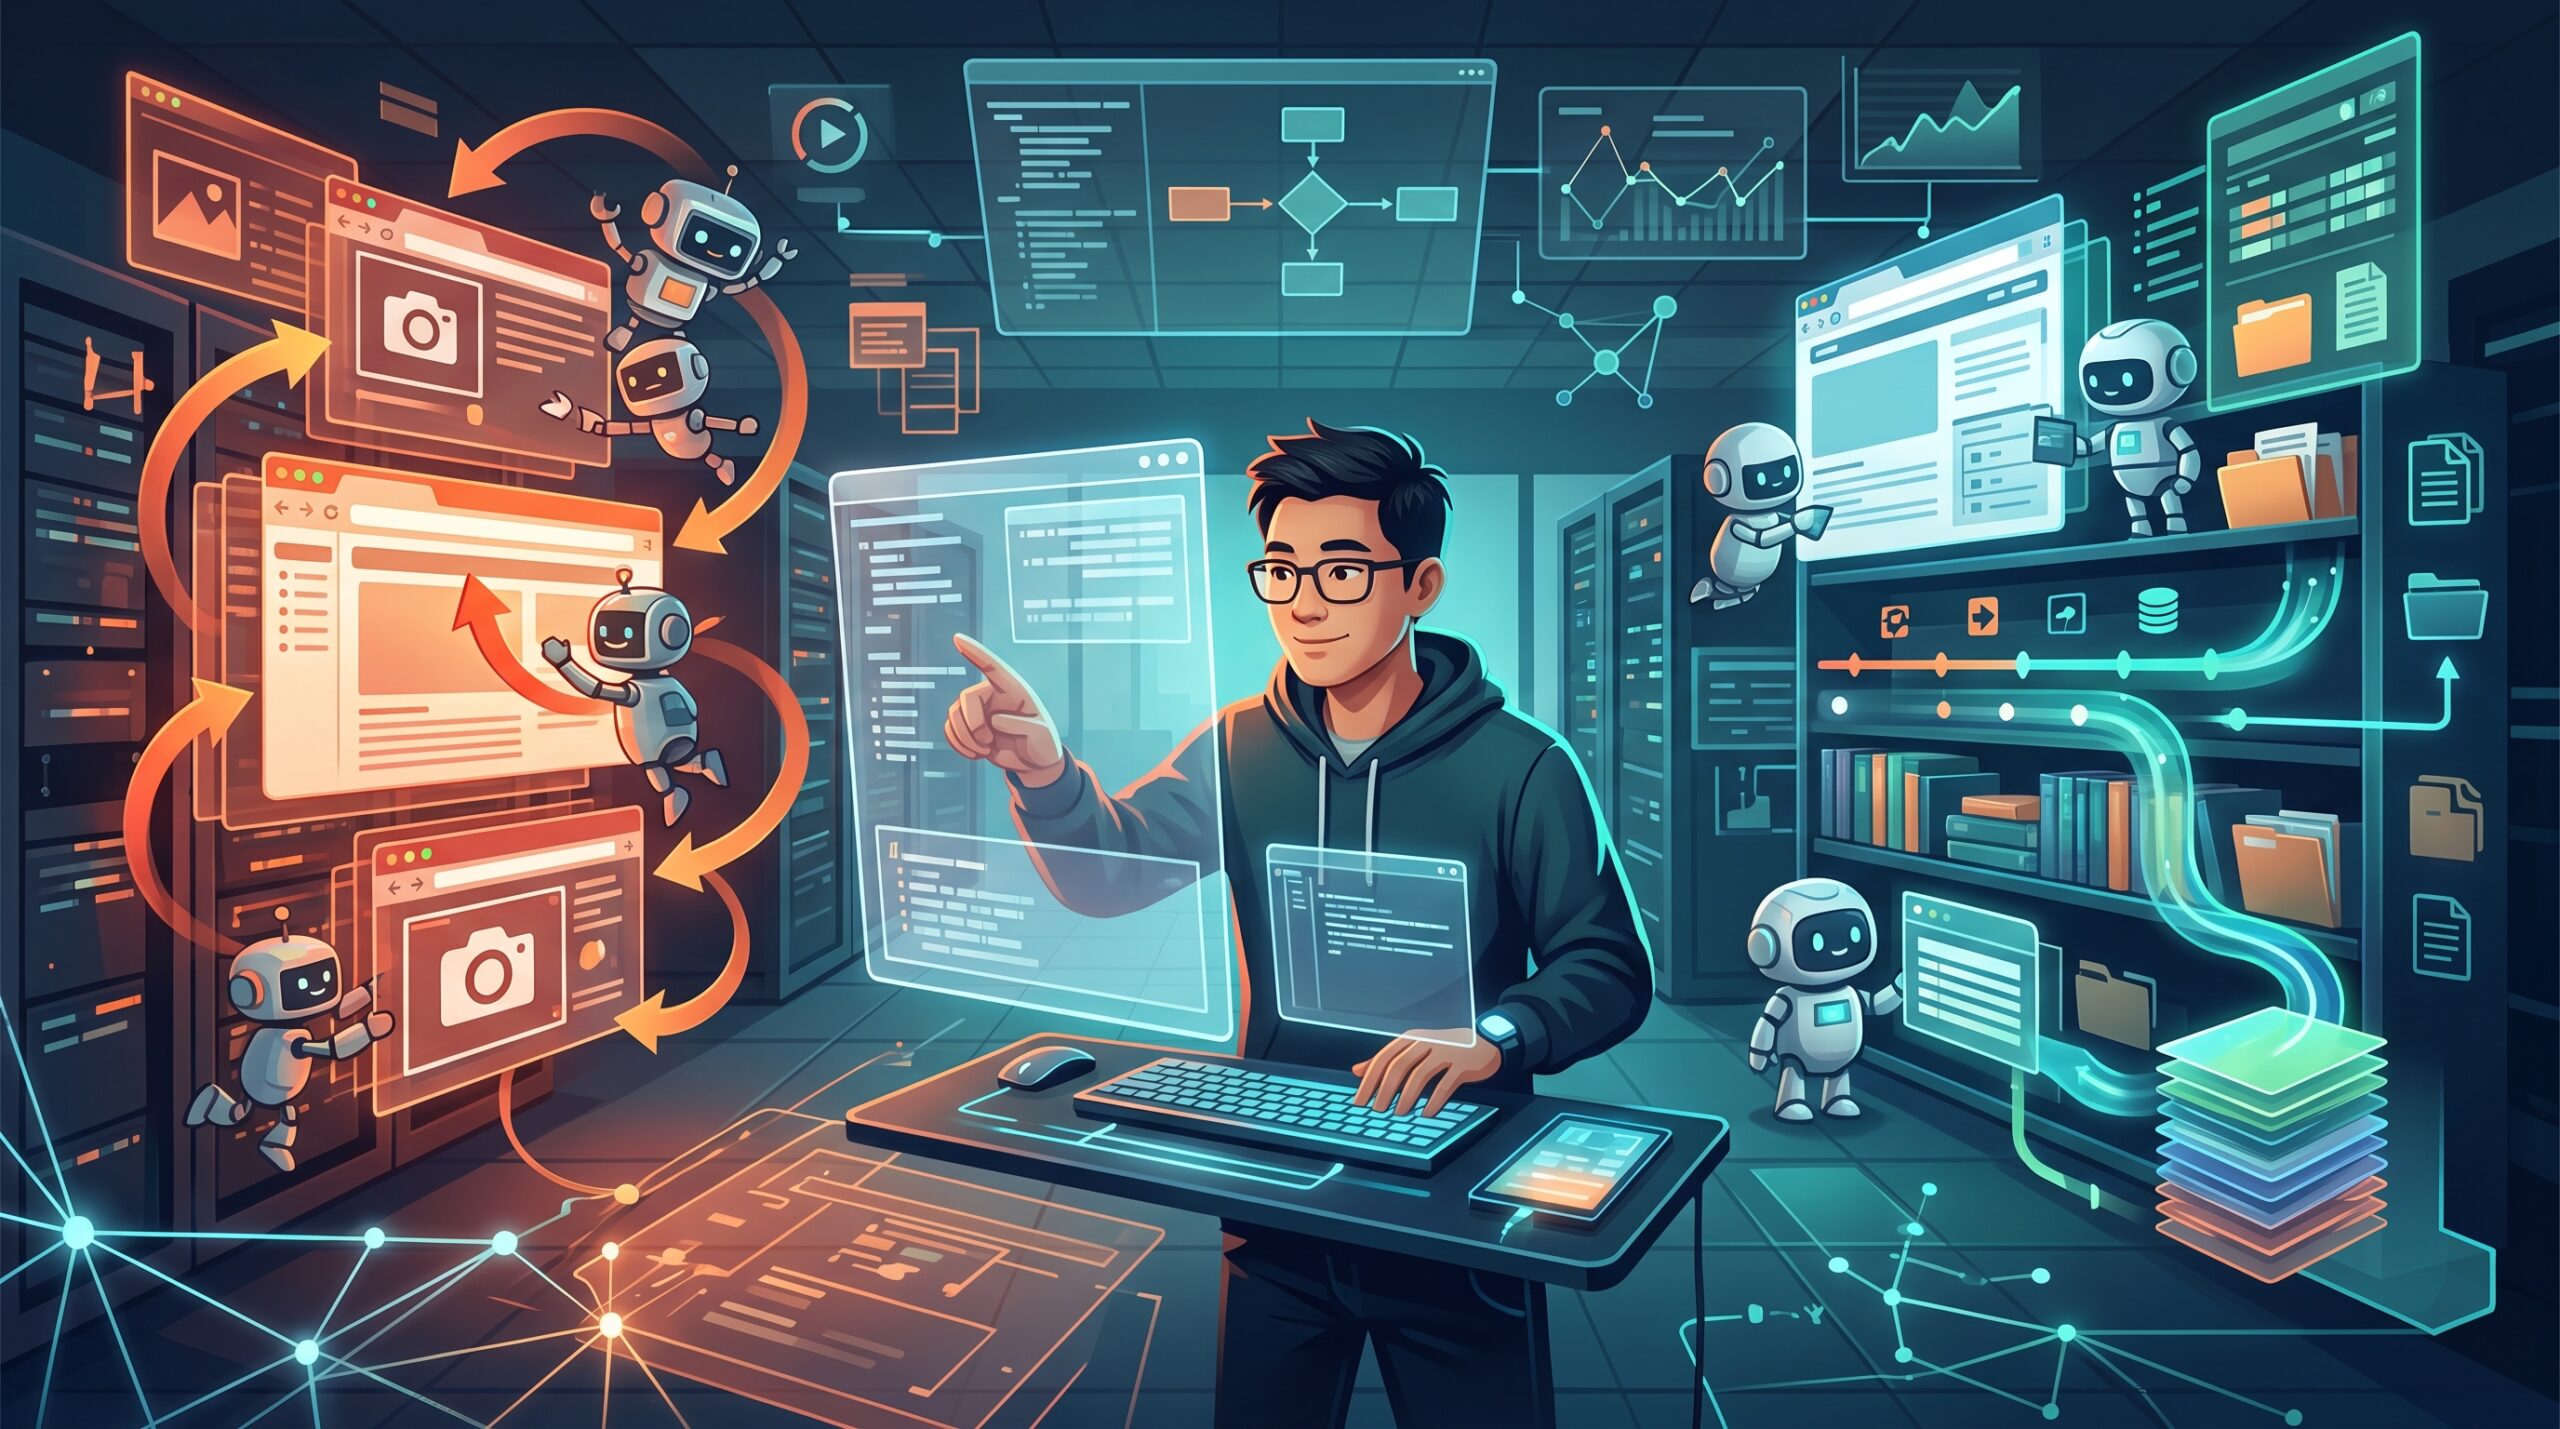
A Asana anunciou que, num teste da IA da StackAI que automatiza operações no navegador, reduziu para 1/76 o custo estimado dos modelos face à configuração de produção anterior e tornou o processamento cinco vezes mais rápido. Com o GPT‑6.1 Sol e uma configuração otimizada para gerir o histórico de navegação, cada execução demorou, em média, cerca de 4 minutos e custou 0,47 dólares.
A redução para 1/76 não se deveu apenas à mudança de modelo
O aspeto a reter destes números é que a comparação não diz respeito ao desempenho dos modelos isoladamente, mas ao resultado da combinação do modelo com a forma como o processamento é organizado. Um agente de navegador é uma IA que lê páginas Web e realiza tarefas como recolher informação e preencher formulários. A Asana disponibiliza este tipo de automatização de tarefas através da StackAI, que adquiriu.
No teste, foram recolhidas seis informações sobre cada um de 32 livros de um catálogo público de demonstração. Foram testados quatro modelos e várias configurações, num total de 144 execuções. Com o modelo B, utilizado inicialmente, o custo estimado por execução era de 36,21 dólares ou mais; bastou rever a forma como o processamento era organizado para o reduzir para 1,24 dólares. Com a configuração otimizada que utiliza o GPT‑6.1 Sol, o custo baixou ainda mais, para 0,47 dólares.
Ou seja, mesmo mantendo o modelo B, foi possível reduzir os custos para cerca de 1/29. Por trás do valor de 1/76 destacado no título, as melhorias na conceção do processamento — anteriores à escolha do modelo — tiveram um papel importante.
O segredo da poupança estava no histórico de navegação fornecido à IA
Na configuração anterior, as instruções fixas já estavam em cache, mas não o histórico acumulado do texto das páginas nem das capturas de ecrã. A cache é um mecanismo que permite reutilizar dados já processados. Se o histórico não puder ser reutilizado, é necessário enviar novamente as informações anteriores sempre que se chama a IA, o que tem um custo.
Além disso, em quase todos os passos eram eliminadas imagens antigas e encurtado o texto. Como o histórico era frequentemente alterado, a simples introdução de uma cache tinha pouco efeito. Apagar demasiada informação também pode levar a IA a voltar a visitar páginas que já tinha lido.
A equipa aumentou o limite de retenção do histórico de 120 mil para 480 mil caracteres e passou a incluir o histórico de navegação na cache. As capturas de ecrã são acumuladas até 20 e, depois, só se conserva a mais recente. Em vez de organizar o histórico a cada passo, a equipa passou a fazê-lo em bloco, prolongando o período em que o histórico anterior pode ser utilizado sem alterações.
Manter mais informação também pode reduzir os custos
Menos informação fornecida à IA significa custos mais baixos. Os resultados deste teste mostram que essa ideia, por si só, não explica os custos dos agentes. Em alguns casos, manter informação para a reutilizar e reduzir verificações desnecessárias pode tornar o processamento total mais barato.
Com o GPT‑6.1 Sol, na configuração com o limite de retenção do histórico alargado, a revisão da cache e da gestão de imagens reduziu o custo estimado por execução de 1,97 para 0,47 dólares. Após a otimização, 89% dos dados de entrada foram fornecidos pela cache, e o custo dessa parte correspondeu a 5% do que seria sem cache.
A quantidade de histórico também influencia a conclusão das tarefas. Com o GPT‑6.1 Sol, foi possível gerar uma resposta em apenas três das 18 execuções quando o limite de retenção era menor; com o limite maior, isso aconteceu nas 18. No teste, todas as 18 respostas estavam corretas.
A IA também foi utilizada para testar propostas de melhoria
Além do GPT‑6.1 Sol, que executava as operações no navegador, foi utilizado o GPT‑6 Astra do Codex para a investigação e as melhorias. O modelo analisou a estrutura do código, identificou problemas na gestão do histórico, reorganizou o código para as experiências e testou várias configurações em paralelo.
Isso não significa que não tenha havido intervenção humana. Frank Hidalgo, CTO da StackAI, analisou as propostas e escolheu as alterações a testar. Os registos das experiências e os resultados também foram revistos noutras sessões com modelos e guardados no Command, a infraestrutura de desenvolvimento da Asana. As alterações chegaram ao ambiente de produção depois de passarem por tickets e pull requests.
Hidalgo afirmou que uma investigação que, se fosse feita manualmente, estima que demoraria um a dois meses foi concluída em cerca de uma semana. Esta diferença de duração baseia-se na estimativa de Hidalgo; não resulta de uma experiência de controlo em que o mesmo trabalho tenha sido realizado apenas por humanos.
Na decisão de implementação, é preciso avaliar em conjunto o custo e a taxa de conclusão
O valor de 0,47 dólares corresponde ao custo estimado dos modelos, não ao custo total, que incluiria despesas com pessoal e operação do sistema. Além disso, algumas das configurações de referência atingiram o limite de execuções sem concluir o processamento; por isso, os valores de 36,21 dólares ou mais e 22,5 minutos ou mais são limites mínimos. Os principais valores de comparação são médias de três execuções por configuração, e a mesma redução não pode ser aplicada a todos os tipos de tarefas na Web.
Entre as configurações otimizadas, o modelo C custou 0,66 dólares e demorou 3,5 minutos, enquanto o GPT‑6.1 Sol custou 0,47 dólares e demorou cerca de 4 minutos. Nesta tarefa, o Sol foi mais barato, mas o modelo C foi mais rápido: a classificação varia consoante se considere o custo ou a velocidade.
A Asana aplicou estas alterações à funcionalidade de controlo do navegador da StackAI. No futuro, planeia integrar os testes nas funcionalidades de avaliação da plataforma, para que os clientes e as equipas internas possam comparar o custo, o tempo de execução e a qualidade das respostas de cada configuração.






コメント