
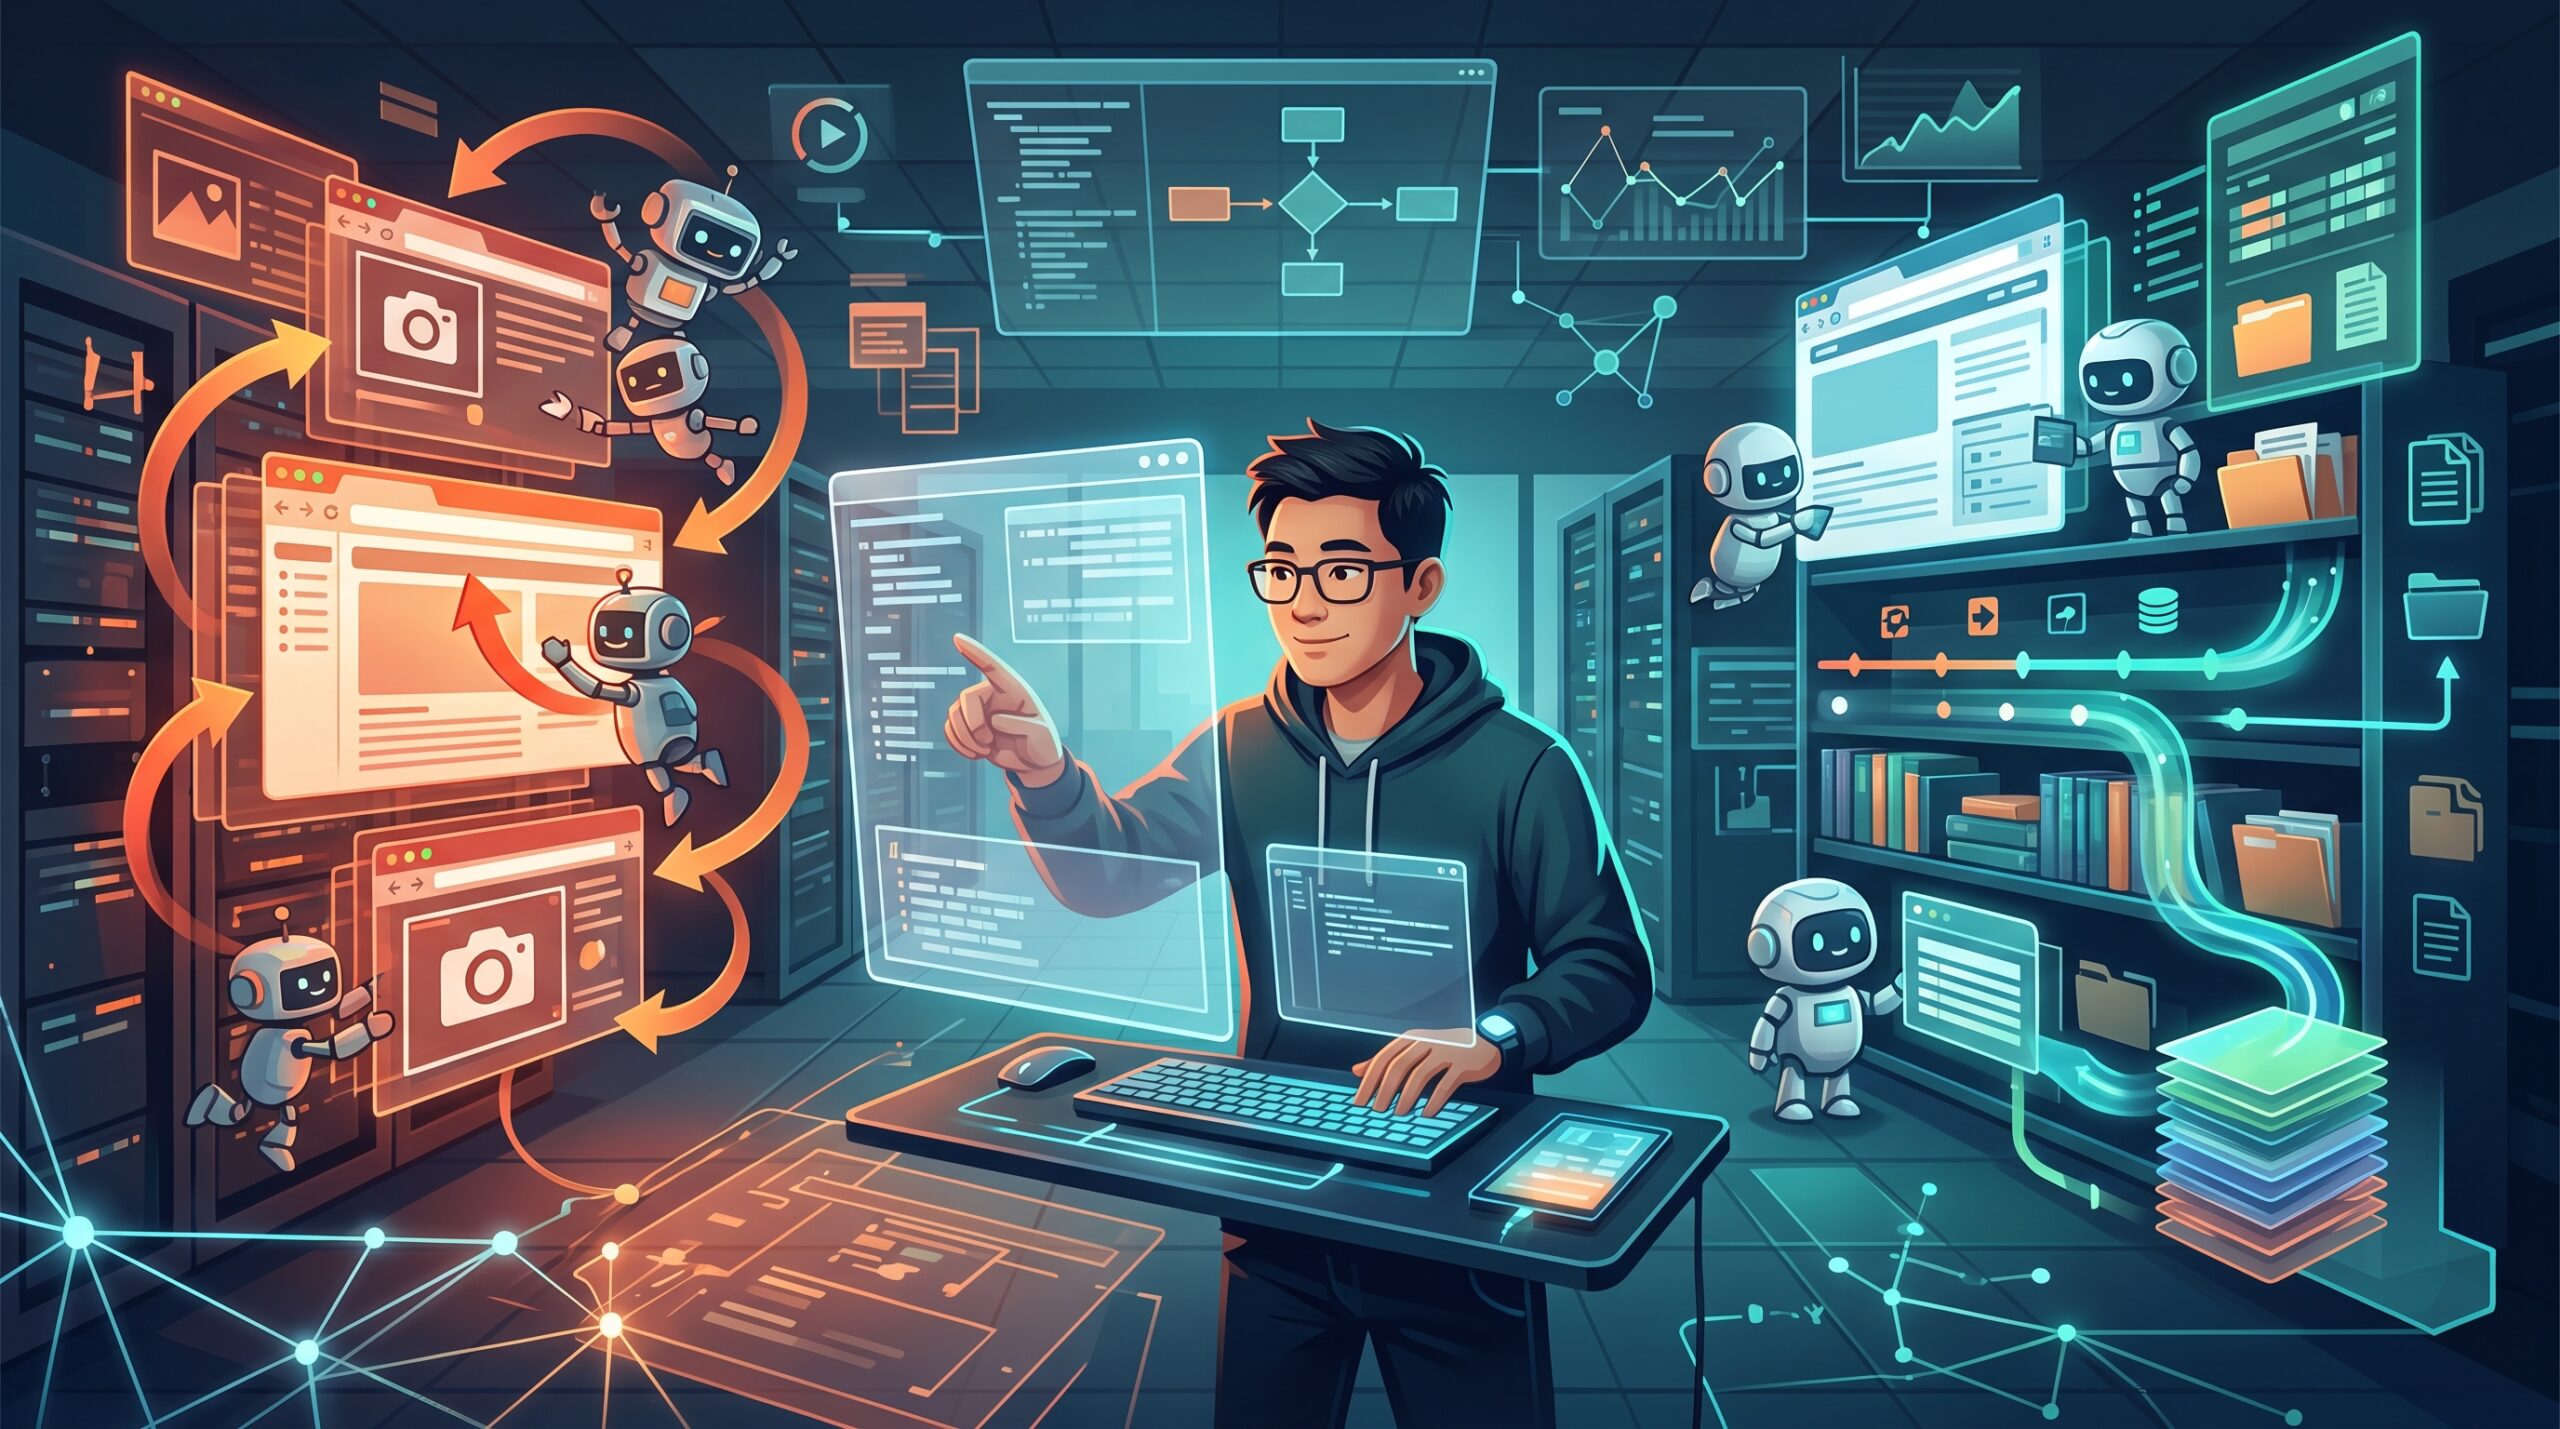
Asana ha annunciato che, in una verifica dell’IA di StackAI per automatizzare le operazioni nel browser, ha ridotto a 1/76 i costi stimati dei modelli e quintuplicato la velocità di elaborazione rispetto alla precedente configurazione di produzione. Con una configurazione ottimizzata di GPT‑6.1 Sol e della gestione della cronologia di navigazione, ogni esecuzione è costata in media 0,47 dollari e ha richiesto circa 4 minuti.
La riduzione a 1/76 non è dovuta soltanto al cambio di modello
Il punto da tenere a mente è che i dati non riguardano le prestazioni del solo modello, ma il risultato ottenuto combinando il modello con il processo di elaborazione. Un agente browser è un’IA che legge le pagine web e svolge attività come raccogliere informazioni o compilare moduli. Asana offre l’automazione di questo tipo di attività tramite StackAI, società che ha acquisito.
Nella verifica sono state raccolte sei informazioni per ciascuno di 32 libri selezionati da un catalogo pubblico di demo. Sono stati effettuati 144 test, usando quattro modelli e diverse configurazioni. Con il modello B utilizzato inizialmente, il costo stimato per esecuzione era di almeno 36,21 dollari, ma è sceso a 1,24 dollari semplicemente rivedendo il processo di elaborazione. Con la configurazione ottimizzata basata su GPT‑6.1 Sol è poi arrivato a 0,47 dollari.
In altre parole, mantenendo il modello B si è riusciti comunque a ridurre i costi a circa un ventinovesimo. Dietro al dato di 1/76, quindi, c’è soprattutto il miglioramento della progettazione del processo, prima ancora della scelta del modello.
La chiave del risparmio era la cronologia di navigazione fornita all’IA
Nella configurazione precedente venivano memorizzate nella cache le istruzioni fisse e altri elementi, ma non la cronologia accumulata con il testo delle pagine e gli screenshot. La cache è un sistema che consente di riutilizzare input già elaborati. Se non si può riutilizzare la cronologia, a ogni chiamata dell’IA occorre inviare di nuovo le informazioni precedenti, con i relativi costi.
Inoltre, quasi a ogni passaggio venivano eliminate le immagini meno recenti e accorciati i testi. Poiché la cronologia veniva modificata di frequente, introdurre una cache da solo difficilmente avrebbe prodotto risultati. Cancellare troppe informazioni può anche indurre l’IA a visitare di nuovo pagine già lette.
Il limite alla cronologia conservata è stato quindi aumentato da 120.000 a 480.000 caratteri, includendo anche la cronologia di navigazione nella cache. Gli screenshot vengono accumulati fino a 20, dopodiché si conserva soltanto il più recente. Invece di riordinare tutto a ogni passaggio, farlo in blocco ha prolungato il periodo in cui la cronologia precedente può essere riutilizzata senza modifiche.
Conservare più informazioni può ridurre i costi
Ridurre le informazioni fornite all’IA fa risparmiare. I risultati di questa verifica mostrano che questa sola idea non basta a spiegare i costi degli agenti. In alcuni casi, conservare e riutilizzare le informazioni, riducendo le verifiche inutili, può rendere meno costoso l’intero processo.
Con GPT‑6.1 Sol, nella configurazione con il limite di conservazione della cronologia ampliato, rivedere la cache e la gestione delle immagini ha ridotto il costo stimato per esecuzione da 1,97 a 0,47 dollari. Dopo l’ottimizzazione, l’89% degli input proveniva dalla cache e il costo di quella parte era pari al 5% di quello che si sarebbe sostenuto senza cache.
La quantità di cronologia conservata incide anche sul completamento delle attività. Con GPT‑6.1 Sol, le esecuzioni che hanno generato una risposta sono state 3 su 18 con il limite più basso, contro 18 su 18 con quello più alto. Nella verifica tutte e 18 le risposte erano corrette.
L’IA è stata usata anche per provare le proposte di miglioramento
Oltre a GPT‑6.1 Sol, che eseguiva le operazioni nel browser, per le attività di ricerca e miglioramento è stato usato GPT‑6 Astra di Codex. Il modello ha esaminato la struttura del codice, individuato i problemi nella gestione della cronologia, riorganizzato il codice per gli esperimenti e testato in parallelo diverse configurazioni.
Questo non significa che non siano intervenute persone. Frank Hidalgo, CTO di StackAI, ha esaminato le proposte e scelto quali modifiche testare. I registri e i risultati degli esperimenti sono stati inoltre revisionati in un’altra sessione del modello e conservati in Command, la piattaforma di sviluppo di Asana. Le modifiche sono state infine portate in produzione tramite ticket e pull request.
Hidalgo ha spiegato che una ricerca che, secondo la sua stima, avrebbe richiesto da 1 a 2 mesi di lavoro manuale è stata completata in circa una settimana. Il confronto sui tempi si basa sulla sua stima e non su un esperimento di controllo in cui lo stesso lavoro è stato svolto soltanto da persone.
Per decidere se adottare la soluzione, vanno considerati insieme costi e tasso di completamento
I 0,47 dollari sono il costo stimato del modello, non il costo totale comprensivo del lavoro umano e della gestione dei sistemi. Inoltre, alcune configurazioni di riferimento non hanno completato il lavoro perché avevano raggiunto il limite al numero di elaborazioni; i valori di almeno 36,21 dollari e almeno 22,5 minuti sono quindi limiti inferiori. I principali valori di confronto sono medie di tre esecuzioni per configurazione e la stessa riduzione non è applicabile a ogni tipo di attività sul web.
Tra le configurazioni ottimizzate, il modello C ha registrato un costo di 0,66 dollari e un tempo di 3,5 minuti, mentre GPT‑6.1 Sol è arrivato a 0,47 dollari e circa 4 minuti. In questa attività Sol costa meno, ma il modello C è più veloce: la classifica cambia a seconda che si guardi al costo o alla velocità.
Asana ha integrato le modifiche nella funzionalità di StackAI per le operazioni nel browser. In futuro prevede di incorporare le verifiche nelle funzionalità di valutazione della piattaforma, così che clienti e team interni possano confrontare, per ciascuna configurazione, costi, tempi di esecuzione e qualità delle risposte.






コメント