
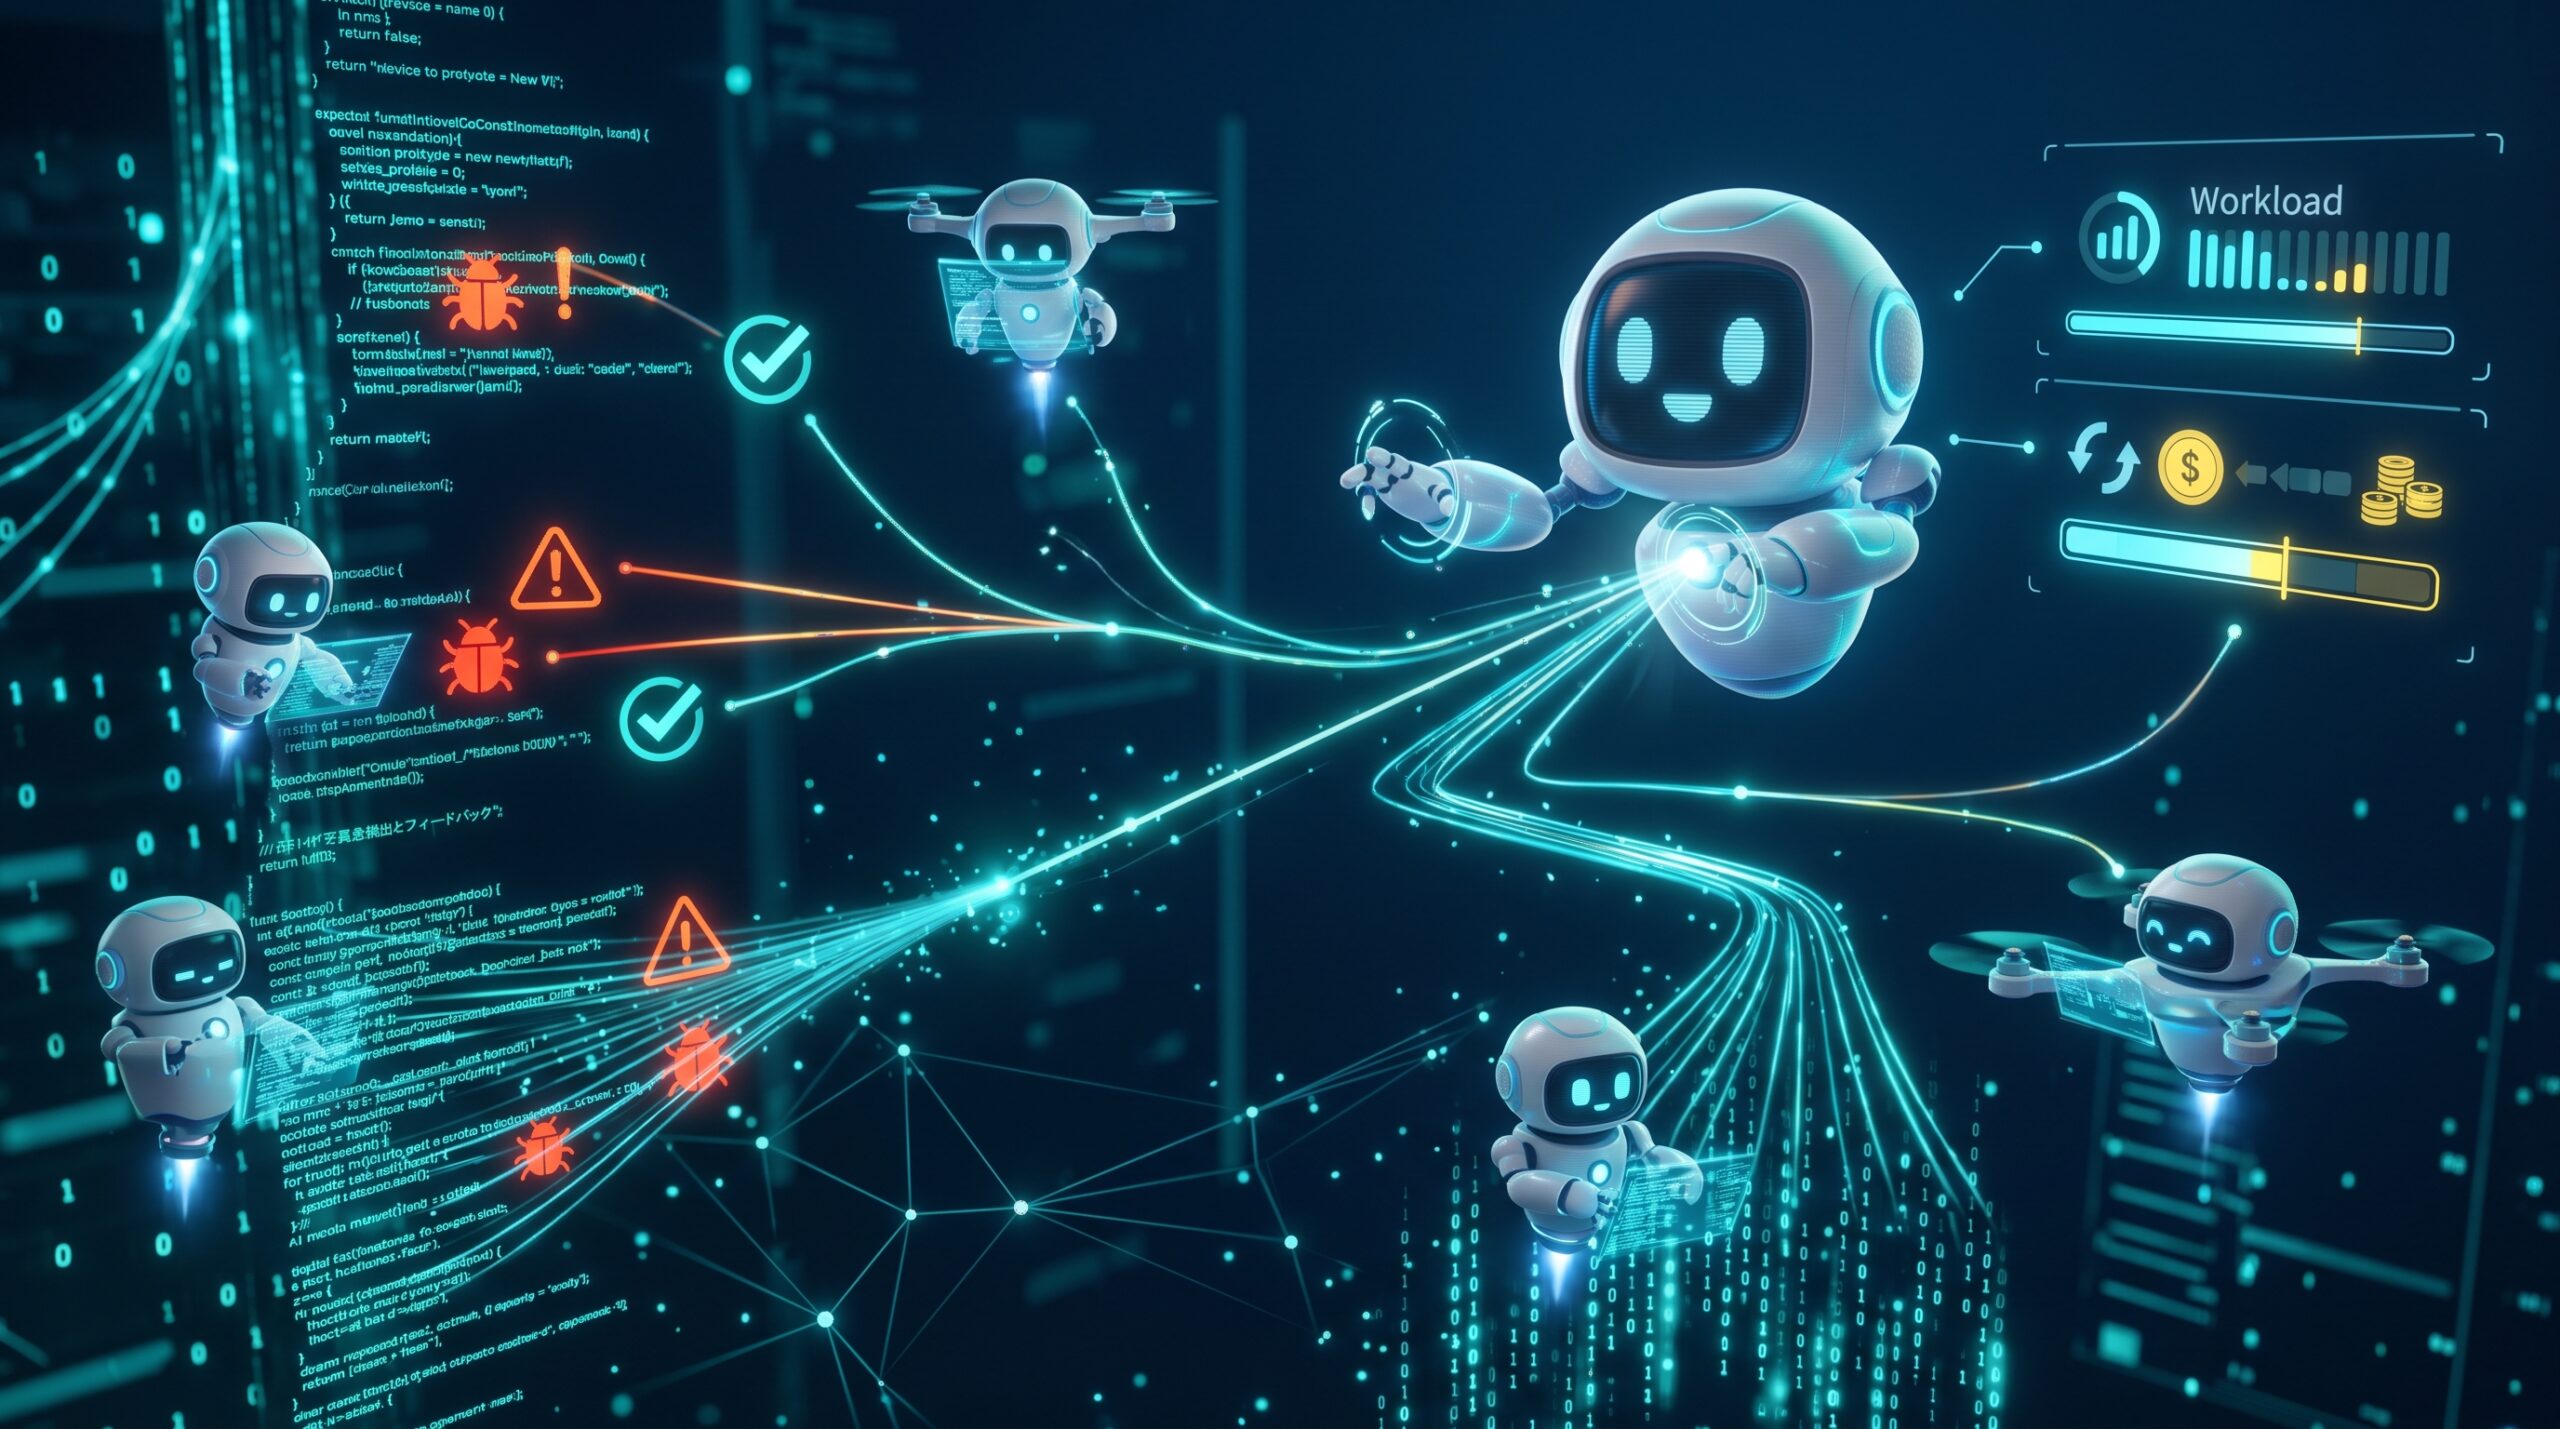
योजना बनाने से लेकर काम बाँटने तक, सब AI के जिम्मे
Anthropic ने AI एजेंट चलाने वाले प्लेटफ़ॉर्म “Claude Managed Agents” में डायनेमिक वर्कफ़्लो जोड़ा है, जिसमें कई एजेंटों के बीच काम बाँटा जाता है। नेतृत्व करने वाला एजेंट योजना बनाता है, चाइल्ड एजेंटों को काम सौंपता है और नतीजों को समेकित करता है। एक बार के रन में अधिकतम 1000 एजेंट समानांतर रूप से चलाए जा सकते हैं।
AI एजेंट वह AI है जो दिए गए लक्ष्य की दिशा में काम करता है। इस नई सुविधा में सब कुछ एक ही एजेंट को सौंपने के बजाय, भूमिकाएँ नेतृत्व करने वाले और काम करने वाले एजेंटों के बीच बाँटी जाती हैं। यानी मौजूदा निष्पादन ढाँचे में कई AI को एक साथ चलाने की व्यवस्था जोड़ी गई है।
ध्यान देने वाली बात सिर्फ 1000 की सीमा नहीं है। काम को बाँटना और नतीजों को समेटना AI की जिम्मेदारी है। हालांकि, समानांतर रूप से चलाए जा सकने वाले एजेंटों की संख्या अपने आप में प्रोसेसिंग की गति या नतीजों में उसी अनुपात में बढ़ोतरी का संकेत नहीं देती।
70 में से 66 बग का पता चला
Anthropic द्वारा बताए गए परीक्षण में 116,000 पंक्तियों के कोड में जानबूझकर 70 बग डाले गए और उनका पता लगाने के नतीजों की तुलना की गई। एक अकेले एजेंट ने एक रन में 14–27 बग खोजे, जबकि डायनेमिक वर्कफ़्लो में हर बार 66 बग मिलने की बात कही गई।
पता लगाने की दर के रूप में देखें तो अकेले एजेंट की दर लगभग 20–39% और डायनेमिक वर्कफ़्लो की लगभग 94% रही। इस परीक्षण में कई एजेंटों के बीच काम बाँटने से मिले बग की संख्या बढ़ी। हालांकि, 66 बग मिलने का मतलब यह नहीं कि तैयार किए गए सभी बग खोज लिए गए।
इसके अलावा, ये नतीजे कोड में बग खोजने के एक खास काम से जुड़े हैं। यह पुष्टि नहीं की जा सकती कि रिसर्च या दस्तावेज़ लिखने जैसे दूसरे कामों में भी ऐसा ही अंतर दिखेगा। उपलब्ध सामग्री में यह भी नहीं बताया गया है कि परीक्षण में वास्तव में कितने एजेंटों का इस्तेमाल हुआ था। इसलिए इसे 1000 एजेंट चलाने का नतीजा मानना जल्दबाज़ी होगी।
अपनाने का फैसला एजेंटों की संख्या से नहीं, प्रति नतीजे की लागत से
काम बाँटने से AI की प्रोसेसिंग मात्रा बढ़ने का बोझ भी पड़ सकता है। Anthropic ने बड़ी मात्रा में टोकन खर्च होने की संभावना जताते हुए छोटे स्तर की व्यवस्था से शुरुआत करने की सलाह दी है। टोकन AI द्वारा संसाधित पाठ या कोड की इकाई है और उपयोग की लागत का आकलन करने में इसका इस्तेमाल होता है।
कंपनियों के लिए अहम सवाल यह है कि कितने AI एजेंट चलाए जा सकते हैं, इससे अधिक यह कि अपेक्षित गुणवत्ता का नतीजा कितनी लागत पर हासिल होगा। ज्यादा बग मिलें भी, तो लागत और जाँच के काम में कितनी बढ़ोतरी होती है—इससे अपनाने का फैसला बदल सकता है। व्यावहारिक तरीका यह है कि एक ही काम पर अकेले एजेंट और कम एजेंटों वाली साझा-कार्य व्यवस्था की तुलना की जाए और मिले बगों की संख्या, लगने वाला समय तथा लागत मापी जाए।
उपलब्ध सामग्री में इस तुलनात्मक परीक्षण की कुल लागत, प्रोसेसिंग समय और टोकन की खपत नहीं बताई गई है। केवल बग खोजने की संख्या में अंतर की पुष्टि होती है; लागत-प्रभावशीलता साबित नहीं हुई है।








コメント