
从制定计划到分配工作,均由AI负责
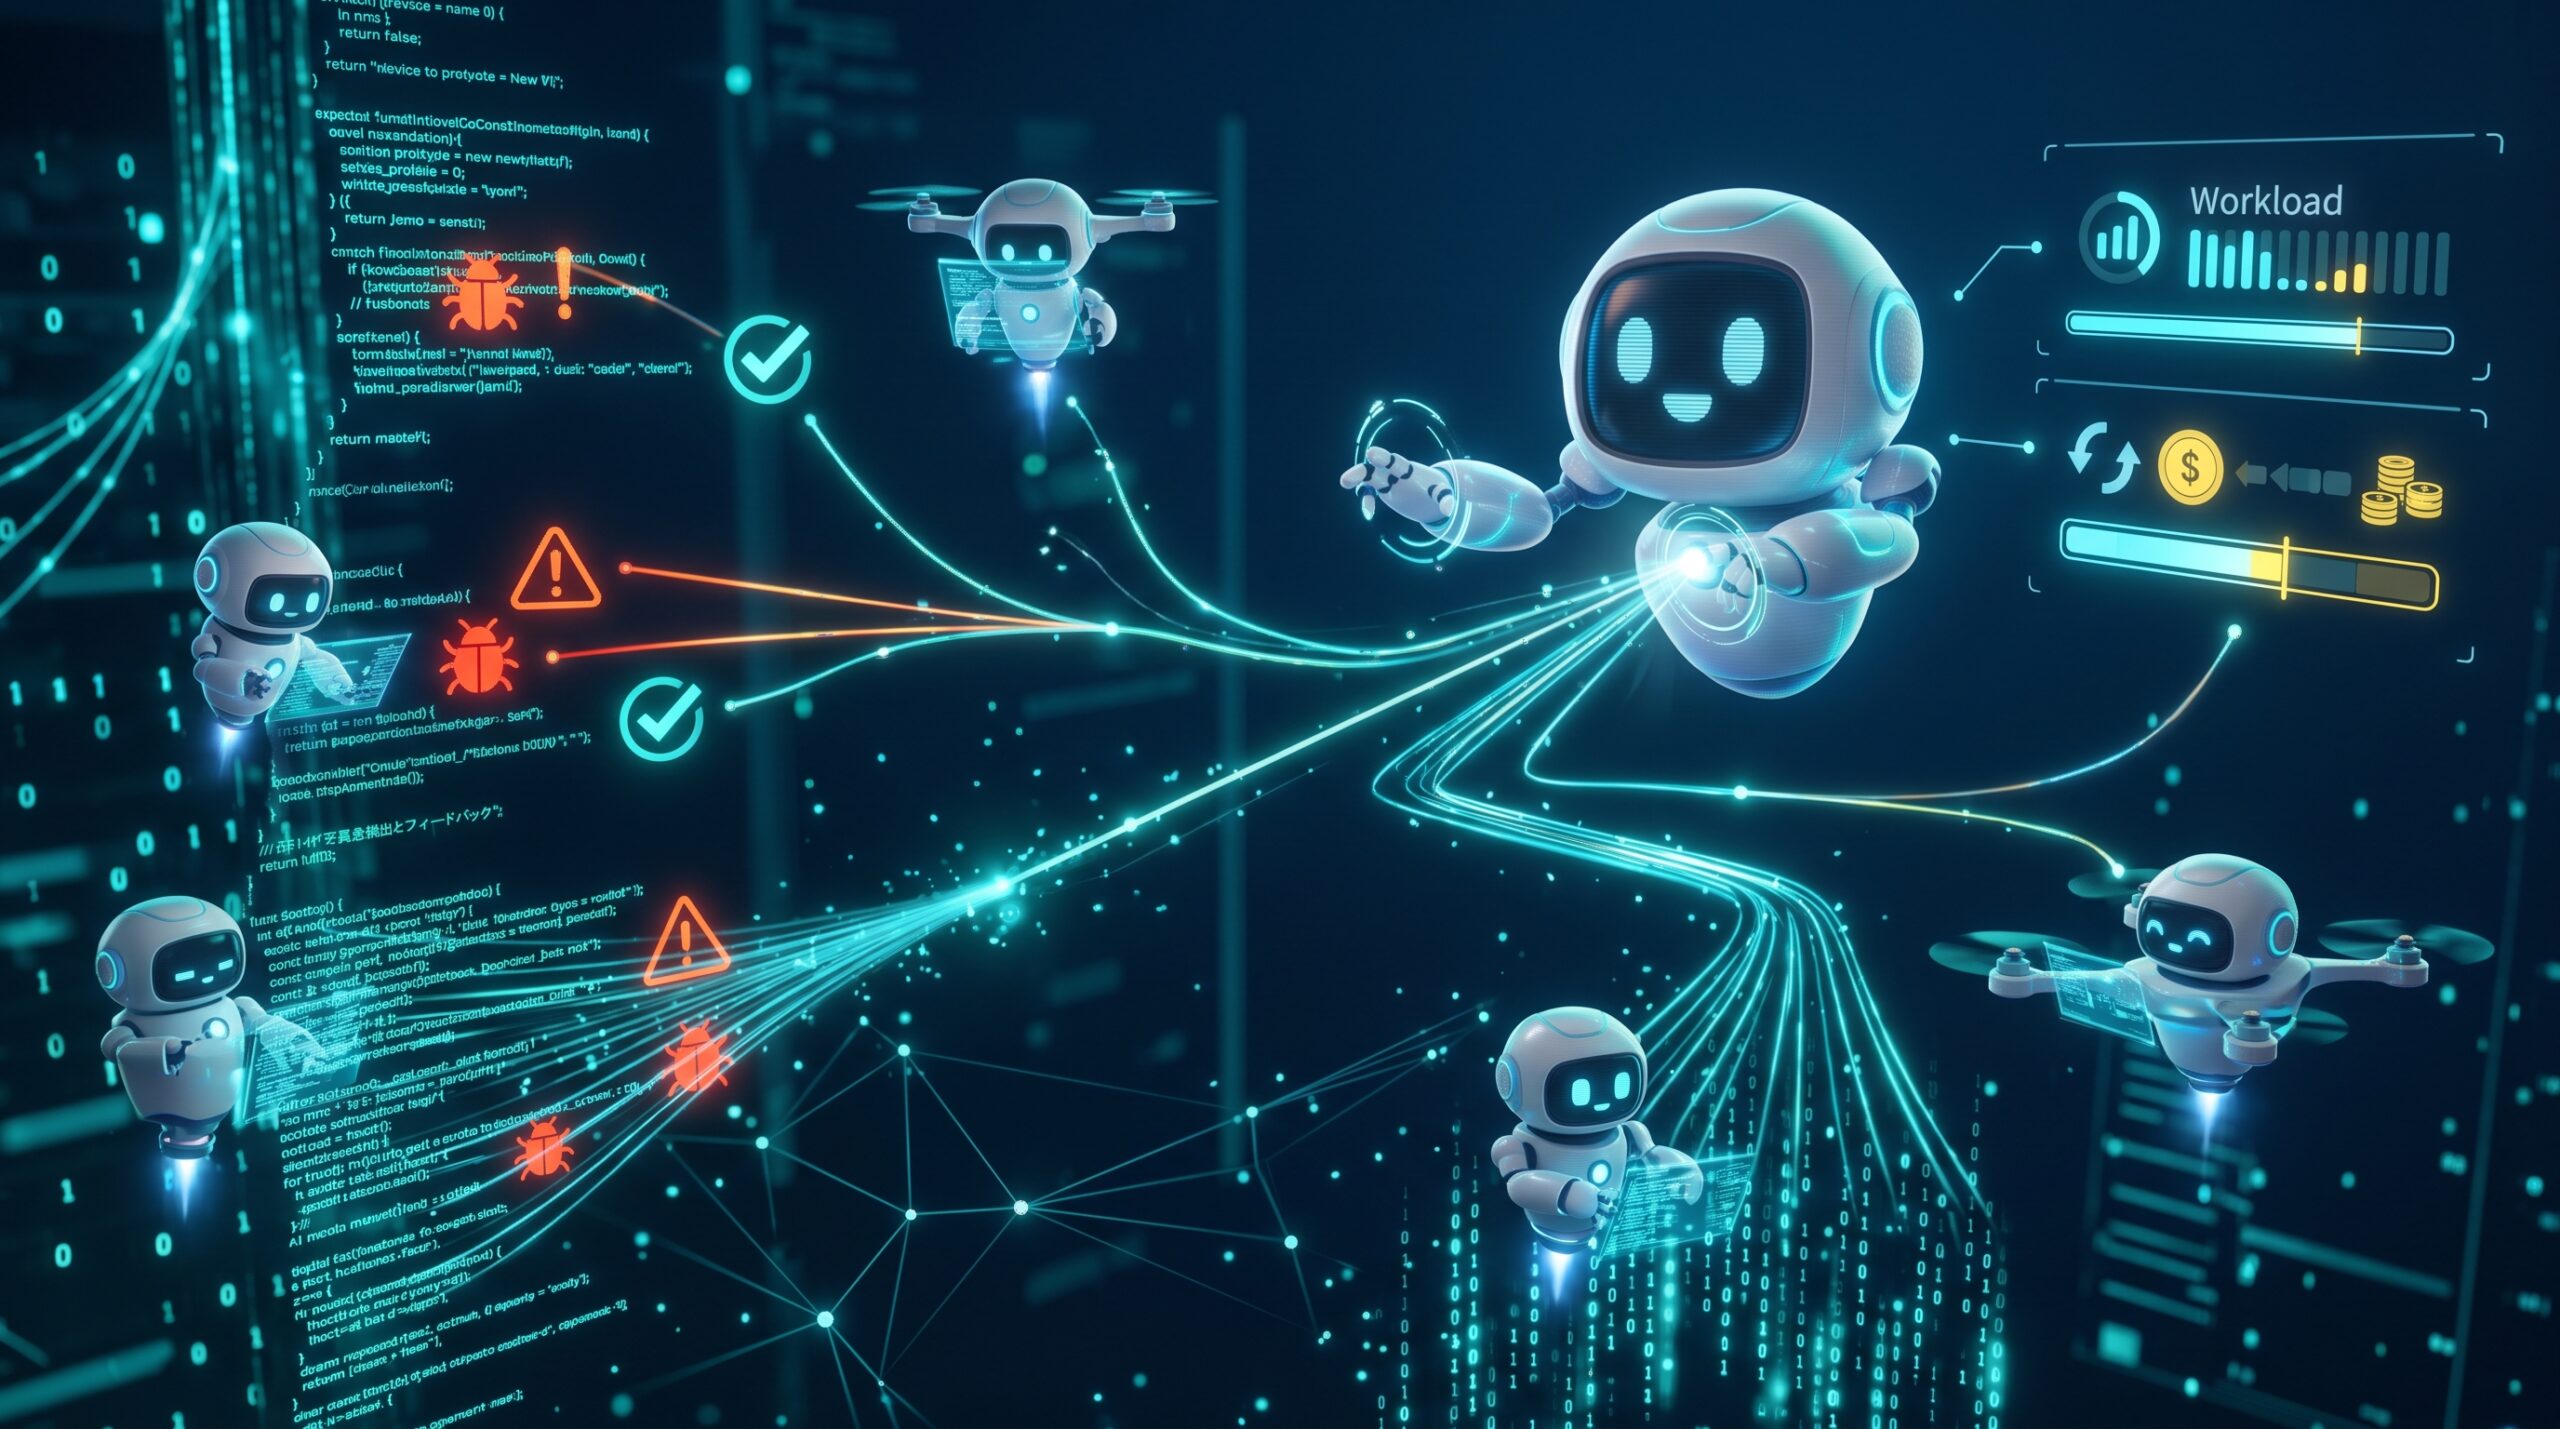
Anthropic为AI智能体执行平台“Claude Managed Agents”新增了动态工作流,让多个智能体分工协作。负责指挥的智能体制定计划、向子智能体分配工作,并整合结果。一次运行最多可并行运行1000个智能体。
AI智能体是能够朝着给定目标开展工作的AI。此次新增的功能不再把所有任务都交给一个智能体,而是将其分为负责指挥和负责执行的角色。这相当于在现有执行平台上,增加了统一调度多个AI的机制。
值得关注的不只是1000这个上限。任务拆分和结果汇总都由AI负责。不过,并行运行的数量并不直接意味着处理速度或成果会成倍提升。
70个漏洞中检出66个
Anthropic公布的测试在11.6万行代码中故意植入了70个漏洞,并对检测结果进行了比较。单个智能体单次运行时发现了14至27个漏洞,而动态工作流据称始终能检出66个。
换算成检出率,单个智能体约为20%至39%,动态工作流约为94%。在这项测试中,多个智能体分工协作带来了检出数量的增加。不过,即便检出66个,也并未找到所有预设漏洞。
此外,这一结果来自代码漏洞检测这一特定任务。尚无法确认在调查、文档撰写等其他工作中是否也会出现类似差距。公布的资料也没有说明测试实际使用了多少个智能体,因此不宜将结果理解为运行1000个智能体所取得的成果。
衡量是否采用,应看每项成果的成本,而非智能体数量
分工协作也会增加AI的处理量,带来额外负担。Anthropic指出,这种方式可能消耗大量token,并建议从小规模配置开始。Token是AI处理文本和代码的单位,也是评估使用成本时的参考指标。
企业真正需要判断的,不是能运行多少个AI,而是以多少成本获得符合要求的成果。即使能发现更多漏洞,如果费用或核查工作量也随之大幅增加,是否采用就会有不同考量。更实际的做法是针对同一任务,对比单个智能体与少量智能体分工协作的配置,并测量检出数量、耗时和费用。
公布的资料没有列出此次对比测试的总费用、处理时间和token消耗量。目前能确认的只有漏洞检出数量的差异,这还不足以证明其具备成本效益。








コメント