
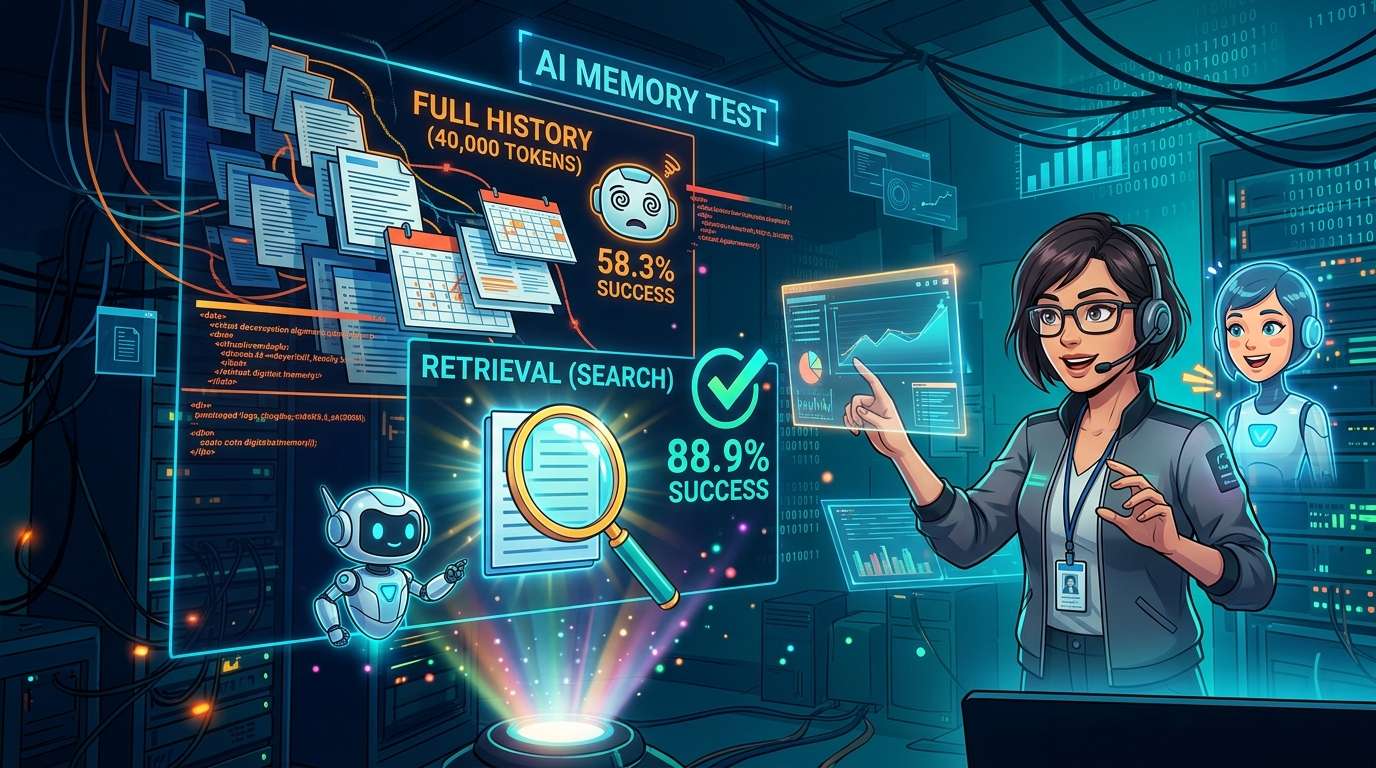
Un confronto tra quattro metodi per dotare gli assistenti IA di una «memoria» è stato pubblicato su Towards Data Science, testata specializzata in data science. In una prova basata sulla cronologia di circa 40.000 token di un project manager immaginario e su 30 richieste, GPT-4o mini ha portato a termine con successo il 58,3% dei compiti quando gli veniva fornita l’intera cronologia, contro l’88,9% con il metodo di ricerca, che recupera e fornisce solo le parti necessarie.
«Ricordare» e «saper usare» sono due cose diverse
Il punto di partenza della verifica è il nuovo test «DolphinBench», che misura le capacità di memoria dell’IA. La verifica completa è descrittain questo articolo di approfondimentoche potete leggere.
Molti test tradizionali sulla memoria chiedono direttamente informazioni passate, per esempio: «Qual è il bar preferito di Sam?». Gli autori di DolphinBench, però, ritengono problematico che la domanda stessa suggerisca che «la risposta è registrata da qualche parte». Perciò il test affida un compito, come «ordina un caffè», e verifica se è stato usato il fatto corretto.
Il test prevede tre personaggi immaginari, ciascuno con una cronologia di conversazioni di circa 500.000 token, e 200 richieste per persona. I risultati devono riportare non solo la precisione, ma anche i costi e i tempi.
DolphinBench è stato creato da un’azienda che vende il sistema di memoria Mem0 e, nei risultati pubblicati, la configurazione dell’azienda si è classificata al primo posto, portando a termine con successo il 70,67% delle richieste. L’autore dell’analisi non ha replicato DolphinBench né testato prodotti di un’azienda specifica: ha preso in prestito soltanto l’idea e ha realizzato un piccolo esperimento autonomo.
Quattro strategie di memoria messe alla prova con Dana, una project manager immaginaria
La protagonista dell’esperimento è Dana Whitfield, una project manager immaginaria. È stata preparata una cronologia di 80 conversazioni distribuite nell’arco di un anno, con alcuni elementi inseriti appositamente.
Una cronologia di un anno e 30 richieste
La cronologia conta circa 40.000 token. In 30 conversazioni viene riportato ogni volta un fatto (il locale dove pranza di solito, l’orario di una riunione, la data di pubblicazione di un progetto, la persona responsabile e così via). In 11 conversazioni quei fatti vengono modificati in seguito, mentre le restanti 39 sono chiacchiere su stampanti, treni, meteo e argomenti simili. Per non far risaltare i fatti, sono state mescolate di proposito conversazioni quotidiane.
Le richieste sono 30. Consistono nel richiamare uno strumento per fissare una riunione, ordinare da mangiare, inviare un messaggio o assegnare un compito; 9 richiedono due fatti, come la persona responsabile e una data. La valutazione non si basa sul testo della risposta, ma soltanto sulla correttezza dei valori passati allo strumento. Per ciascun fatto è stata inoltre preparata una domanda diretta, per verificare se il modello sapesse rispondere con il valore più recente.
I quattro metodi a confronto
I metodi sono quattro. «Nessuna memoria»: non viene fornita alcuna informazione. «Cronologia completa»: vengono passati ogni volta tutti i 40.000 token della cronologia. «Riepilogo»: la cronologia viene letta gradualmente e un riassunto di circa 1.000 parole viene aggiornato di volta in volta. «Ricerca»: vengono recuperati e forniti cinque frammenti della cronologia pertinenti alla richiesta.
È come consegnare ogni mattina l’intero diario di un anno, dare un foglio di appunti preparato da qualcuno oppure estrarre le sole pagine pertinenti ogni volta che arriva una richiesta.
I modelli utilizzati sono GPT-4o mini di OpenAI e Claude Haiku 4.5 di Anthropic; le esecuzioni sono state 1.260 in totale. Il registro di tutti gli esperimenti è conservato su Weights & Biases, uno strumento per la gestione degli esperimenti.
コメント