
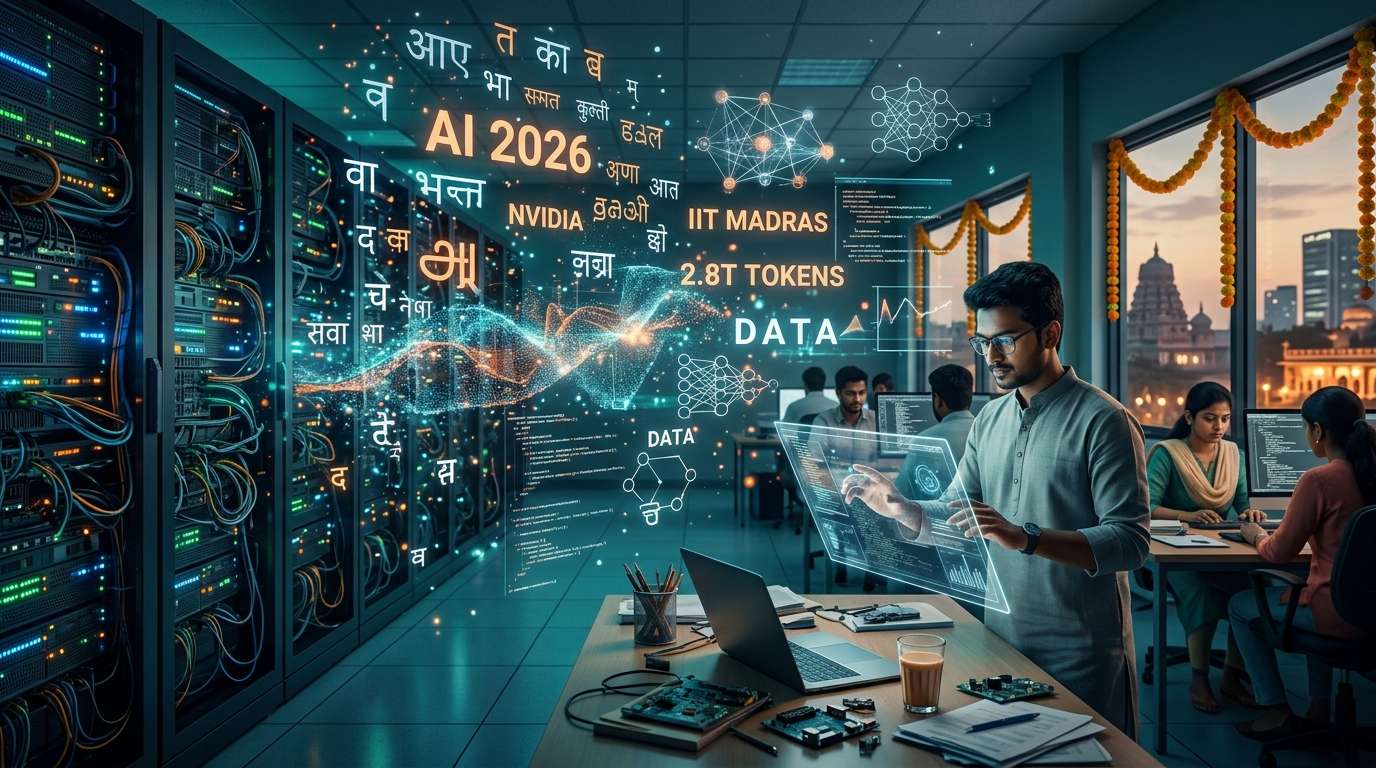
NVIDIA ha annunciato che pubblicherà a breve «Nemotron-pretraining-Indic-v1», un dataset di circa 2.800 miliardi di token per il preaddestramento dell’IA, sviluppato in collaborazione con l’Indian Institute of Technology Madras (IIT Madras) e AI4Bharat, il gruppo dell’ateneo. Il dataset copre le 22 lingue previste dalla Costituzione indiana. NVIDIA prevede di rendere disponibile anche la pipeline compatibile con GPU usata per generarlo. L’idea è combinare dati sintetici basati su materiali in inglese con testi naturali scritti sul posto.
Un enorme corpus per 22 lingue indiane, in 34 combinazioni
Il dataset copre le 22 lingue ufficiali indicate nella Costituzione indiana, tra cui hindi, bengalese, tamil, telugu e urdu. Sono le lingue madri di circa il 97% della popolazione indiana. Secondo il censimento del 2011, si tratta di circa 1,2 miliardi di persone.
Rispetto all’inglese, le lingue indiane dispongono di pochi dati per l’IA. È un problema denunciato da tempo da Mitesh Khapra, responsabile di AI4Bharat, e questo dataset rappresenta un passo per colmare la lacuna.
Vediamo cosa contiene. Per tutte e 22 le lingue sono disponibili dati scritti nella grafia standard di ciascuna. Per 12 lingue si aggiungono anche trascrizioni in caratteri latini, cioè nell’alfabeto latino: le combinazioni di lingua e sistema di scrittura sono quindi 34. Il numero di token è di circa 2.601 miliardi nella grafia standard e di 224,6 miliardi nelle trascrizioni in caratteri latini. Entrambi i valori sono stati calcolati con il tokenizer di Gemma-4.
Va tenuto presente che queste cifre non indicano il numero di «documenti unici in inglese». Vengono conteggiati più volte anche dati tradotti o trascritti in grafie diverse a partire dalla stessa fonte. Le trascrizioni in caratteri latini non sono traduzioni in inglese: sono lingue indiane scritte in forma romanizzata. Permettono inoltre di addestrare il modello sullo stesso contenuto in un sistema di scrittura diverso.
Considerato che molte persone scrivono in hindi con caratteri latini nelle email e sui social network, si tratta di una scelta pratica. Per fare un paragone con il giapponese, è come addestrare un modello sia su testi in hiragana e kanji, sia su testi inseriti con la traslitterazione in caratteri latini.
Un processo di generazione in quattro fasi, non una semplice traduzione
I materiali di partenza provengono da 15 sottoinsiemi di Nemotron-CC-v2 e comprendono testi web, domande e risposte, matematica e codice. Vengono elaborati con NeMo Data Designer, lo strumento open source di NVIDIA per la generazione di dati sintetici, che gestisce l’intero processo, dalla traduzione alla valutazione della qualità e alla correzione.
L’output conserva gli identificativi dei documenti originali, rendendo possibile risalire alla fonte di ciascun dato. La facilità di controllo a posteriori è uno dei punti di forza dei dati aperti.
Per le 12 lingue, il processo prevede quattro fasi: traduzione dei documenti in inglese, valutazione della qualità, correzione dei risultati con punteggi bassi e conversione in caratteri latini. Per la traduzione viene usato Gemma-4-31B-it, che traduce i documenti per intero, in un’unica operazione. L’obiettivo è preservare il contesto tra paragrafi, tabelle e formule. È importante anche che il prompt chieda di mantenere invariati codice, formule e URL.
La valutazione viene effettuata dallo stesso modello, confrontando la traduzione con il testo originale. I criteri riguardano significato, scorrevolezza, terminologia, stile e formattazione e si ispirano a MQM, un quadro di riferimento per la classificazione degli errori di traduzione. Si accettano i risultati con almeno 75 punti su 100; quelli al di sotto della soglia vengono corretti sulla base dei feedback della valutazione e poi valutati di nuovo. Grazie a queste correzioni sono stati recuperati 438,4 miliardi di token, tra grafia standard e caratteri latini, già inclusi nel totale.
Anche il metodo per creare le trascrizioni in caratteri latini presenta alcune particolarità. Invece di romanizzare direttamente dall’inglese, si parte dalla traduzione approvata nella grafia standard e la si converte; il risultato viene poi confrontato con la traduzione originale. Secondo i primi confronti effettuati da persone, questo metodo in due fasi riduceva le allucinazioni e le tracce residue di inglese.
Le altre 10 lingue saranno coperte con un modello di traduzione dedicato
Le 10 lingue prive di una trascrizione in caratteri latini sono assamese, bodo, dogri, kashmiro, konkani, maithili, manipuri, sanscrito, santali e sindhi. Per tradurle viene usato «Indic Translate», un modello sviluppato da Bodhan AI, un’organizzazione senza scopo di lucro nata all’IIT Madras.
La valutazione è affidata a Gemma-4-31B-it, con la stessa soglia di 75 punti. In questo caso, però, non si effettuano riscritture sulla base dei feedback e vengono creati dati soltanto nella grafia standard.
Sono previste anche soluzioni specifiche per ciascuna lingua. I lunghi documenti in santali vengono suddivisi in finestre sovrapposte per la traduzione e poi ricomposti. Per il manipuri si traduce prima in caratteri bengalesi e poi si converte il testo nella scrittura Meitei, propria della lingua. Sono accorgimenti resi necessari dalle grandi differenze tra i sistemi di scrittura delle lingue indiane.
Quanto si può dedurre sui miglioramenti delle prestazioni?
Un indizio sull’efficacia è offerto dal preaddestramento continuo di Nemotron 3.5 Super VL. In questa fase, 10 miliardi di token — il 10% del budget di addestramento, pari a 100 miliardi di token — sono stati destinati a una parte delle 12 lingue del corpus e a una combinazione di testi naturali nelle lingue indiane. Il restante 90% ha mantenuto le proporzioni della precedente miscela di addestramento.
Di conseguenza, tutti e cinque gli indicatori — MILU, Indic MMLU-Pro, Indic ARC-Challenge, Indic ARC-Easy e Indic GSM8K — hanno registrato un aumento, compreso tra 4,98 e 9,82 punti. Va però precisato che il confronto riguarda i checkpoint prima e dopo il preaddestramento continuo: non isola il contributo dei soli dati sintetici. Ciò che si può affermare con certezza è che ha funzionato la combinazione di dati sintetici e testi naturali.
Considerando il modello completo, i punteggi sono migliorati in cinque delle sei valutazioni dei compiti che misurano conoscenze, ragionamento, matematica, programmazione e traduzione, rispetto al modello della generazione precedente, Nemotron 3 Super. L’IFEval 1.5, che misura la capacità di seguire le istruzioni, ha invece perso 2,04 punti.
Nella valutazione «IndiVibe» di Sarvam AI, che misura la qualità delle conversazioni nelle lingue indiane, sono migliorati tutti e quattro gli aspetti considerati: utilità, fluidità, fedeltà alla lingua e alla scrittura e adeguatezza della lunghezza delle risposte.
Pubblicare i dati non basta: conta anche saperli sfruttare
A colpire in questa pubblicazione non è solo l’apertura dei dati, ma anche quella del processo con cui vengono creati. Il plugin di traduzione «Nemotron Bharat» per NeMo Data Designer include prompt per la traduzione e la valutazione, funzioni di riscrittura, suddivisione dei documenti in finestre e supporto alla conversione dei sistemi di scrittura. Aziende e istituti di ricerca che dispongono di documenti propri possono così creare dati per altri ambiti seguendo la stessa procedura.
Le indicazioni per l’uso sono concrete. Si consiglia di iniziare con un piccolo numero di documenti aziendali e verificare che codice, formule e formattazione siano conservati, per poi ampliare il progetto dopo una revisione da parte di parlanti della lingua locale. Il plugin restituisce proposte e punteggi: spetta quindi a ciascun team decidere, in base ai propri criteri di selezione, quali record includere nell’addestramento. Per esaminare i dati si può usare la funzione di streaming di Hugging Face, senza doverli scaricare tutti.
I dati tradotti non possono sostituire i testi scritti localmente. Le conoscenze regionali e il contesto culturale sono veicolati dai testi prodotti in modo naturale. Questo corpus è stato progettato per essere usato insieme a testi di questo tipo.
La valutazione della qualità è perlopiù automatizzata e i controlli umani si concentrano sui campioni. Nel processo per 12 lingue, il modello usato per la traduzione svolge anche il ruolo di valutatore; per le 10 lingue restanti è quindi necessaria una verifica più ampia da parte di parlanti madrelingua. La deduplicazione basata sugli ID delle fonti elimina i duplicati introdotti durante l’elaborazione, ma non organizza i contenuti simili sul piano semantico.
Con il sostegno di NVIDIA, AI4Bharat sta inoltre preparando «Indic-LLM-Eval-Suite», una raccolta di benchmark per la valutazione. L’espansione dei dati procede quindi di pari passo con la messa a punto degli strumenti per misurarli. Riuscirà a rafforzare le fondamenta dell’IA, finora incentrate sull’inglese, attraverso valutazioni specifiche per lingua e una combinazione con testi naturali? Questo corpus per 22 lingue indiane potrebbe diventare un banco di prova.








コメント