
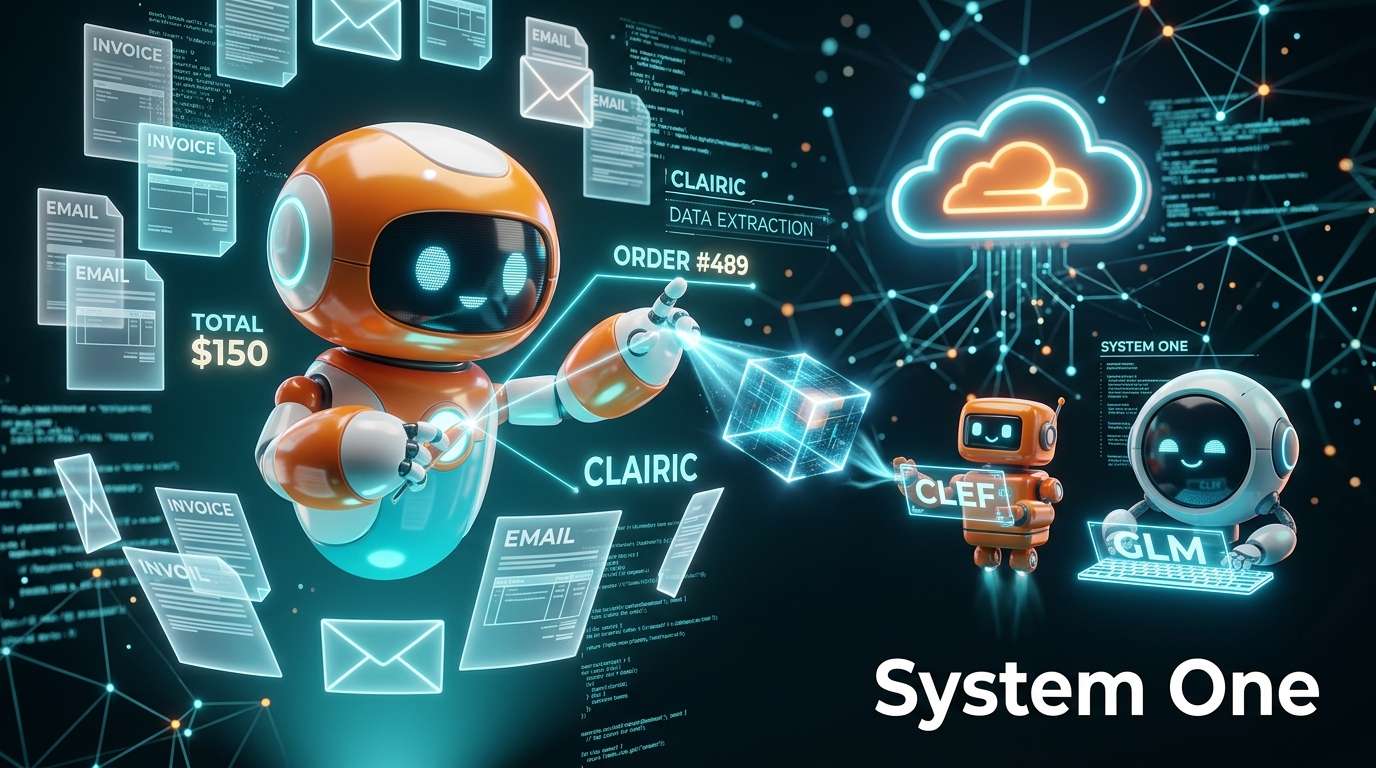
Cloudflare在其AI运行平台Workers AI上预览发布了AI模型“Clairic”,该模型可从文档中提取指定字段的值。用户指定订单编号、账单金额等字段名后,模型会按照规定格式返回相应数值及置信度。开放权重(模型的权重数据)也计划于近期发布,Cloudflare还展示了将其与LLM结合使用的处理示例。
不是写文章的AI,而是提取字段的AI
说到生成式AI,很多人想到的应该是能流畅写文章的工具。但Clairic的特点几乎恰恰相反。它的工作范围仅限于提取指定字段,例如“从发票中提取总金额”“从邮件中找出订单编号”。
它的工作机制也有特点。一般的LLM会逐词(按token单位)生成文本,而Clairic不采用这种生成方式,而是一次处理就返回所有指定字段的答案。如果文档中没有相应数值,它会返回“null”(无匹配项),不会勉强编造答案,这一点也很适合实际工作场景。
据称,它不仅能提取信息,还能进行简单的计算、估算和预测。也就是说,把Clairic理解为不负责写文章,而是将零散信息整理成易用格式的“前期处理人员”,会更容易理解。
由不同模型分工处理客户咨询
Cloudflare展示的应用示例颇有启发性,场景是一封客户投诉邮件。首先,Clairic从邮件中提取订单编号、金额和损坏情况,并估算维修费用。
接下来登场的是用于判断的模型“Clef”。它会根据公司内部规则,决定退款还是维修。最后,由LLM GLM-5.3撰写面向客户的回复。
有意思的是,这里并没有把所有工作都交给一个庞大的模型。如果换作人类职场中的分工,就类似于由接待人员整理信息、决策人员确定处理方针,再由擅长写作的人负责回复。Cloudflare将这类负责快速处理的小型模型称为“System One”模型,并设想将它们与LLM串联起来使用。
在我看来,这种思路才是此次发布的核心。引入AI时,人们往往会不由自主地把目光放在“挑选一个最聪明的模型”上。但把业务内容拆解开来,就会发现并非每个环节都需要充分发挥模型的智能。按照不同职责使用不同工具的设计,未来可能会成为业务AI的常规做法。
速度数据体现了分工的效果
不妨也来看看大家关心的数据。根据Cloudflare的比较,前面提到的三阶段协同处理耗时19.3秒。若仅用GLM-5.3完成相同的三个步骤,则需要61.7秒,费用也几乎翻倍。
不过,这些数据来自特定处理示例。并非所有业务都能达到同样的差异,更恰当的理解是:它体现了“分工处理可能带来多大变化”。即便如此,耗时相差三倍以上这一事实,也能让人思考拆分处理流程的意义。
其局限性也得到了明确说明。Clairic目前还无法稳定处理连续多步的计算。据称,至少在现阶段,这类处理仍需要开发者通过自己的代码来执行。
尽管如此,由一群各自擅长特定工作的专业模型组成的世界,对实际业务场景来说颇具吸引力。像发票处理和客户咨询这样每天都会大量涌入的标准化业务,理应更能受益于这种分工。让LLM专注于只有LLM才能完成的工作。Clairic让我们看到了这样一个未来的开端。






コメント