
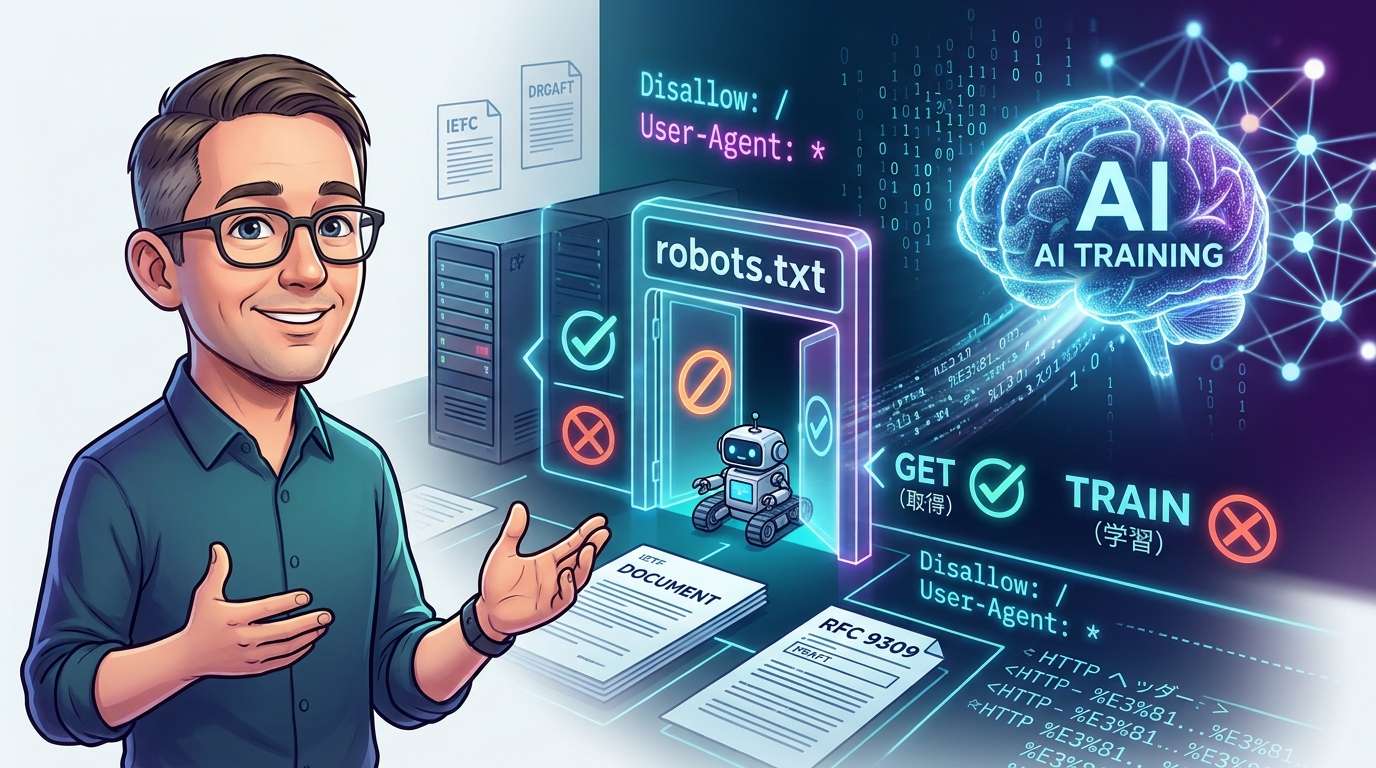
Gary Illyes, de Google, explicó en el segundo episodio de la serie de vídeos de Search Central «The Non-Canonical Cabinet» que, según el estándar RFC 9309, robots.txt indica qué URL pueden solicitar los rastreadores, pero no determina qué se hace con los datos una vez obtenidos. Añadió que, para bloquear un rastreador de IA concreto, hay que especificar su user agent por nombre.
«Denegar el acceso» y «no usar para entrenar» son cosas distintas
«Si escribo en robots.txt que prohíbo el entrenamiento de IA, puedo estar tranquilo». Parece que esta idea se está extendiendo poco a poco. Pero, según la explicación de Illyes, no es tan sencillo. robots.txt es como un cartel en la entrada de un sitio web que indica: «Puede entrar por esta puerta». El cartel no regula cómo usar la información que alguien se lleva después de entrar.
Illyes describió el robots.txt definido en el RFC 9309 como «un protocolo para comunicar preferencias de acceso» y señaló que no permite dar instrucciones sobre cómo deben tratar los sistemas los datos rastreados. La pregunta planteada en el vídeo era si se puede permitir el rastreo mediante IA y, a la vez, impedir que esa misma información se use para entrenar modelos de IA generativa. La respuesta es que robots.txt, por sí solo, no permite hacer esa distinción.
robots.txt solo determina el acceso
La página de especificaciones de Google enumera cuatro directivas compatibles: User-Agent, Allow, Disallow y Sitemap. Las demás líneas se consideran no válidas y se ignoran. En el vídeo apareció una directiva ficticia, «No-AI-Chicken-Training», pero el parser de Google no lee este tipo de líneas personalizadas.
La sección 2.2.4 del RFC 9309 deja a criterio de cada rastreador cómo procesar los registros que quedan fuera del ámbito de la especificación. Es decir, aunque se añadan líneas personalizadas, depende del rastreador si las respeta o no. Puede que funcionen o puede que no. En cualquier caso, no son «una garantía respaldada por el estándar».
La opción más fiable en la práctica es especificar por separado el user agent del rastreador de IA que se quiera bloquear y denegarle el acceso con Disallow. Illyes señaló que, si se quiere impedir el acceso a todo el sitio, hay que indicar explícitamente el token correspondiente.
Google-Extended es un control de uso propio de Google
¿Qué papel desempeña entonces Google-Extended, el token que Google utiliza para controlar el uso de datos con fines relacionados con la IA? Es un token de robots.txt que no tiene un user agent independiente: Google rastrea la web con sus rastreadores existentes. La lista de rastreadores de la empresa indica que este token cumple una «función de control».
El control se aplica a si Google puede usar el contenido que obtiene para entrenar futuros modelos Gemini, para Gemini Apps o para fundamentar respuestas mediante Grounding with Google Search en Vertex AI. No afecta a la inclusión en los resultados de Google Search ni se utiliza como señal de posicionamiento.
Lo importante es que este significado de «control de uso» no procede del RFC 9309, sino de la documentación de los productos de Google. No es una regla común de robots.txt que también sea aplicable a la IA de otras empresas. Lo más adecuado es considerarlo un interruptor específico para Google.
La propuesta de estandarizar la indicación del uso previsto sigue siendo un borrador
¿Se puede indicar por separado si se permite el rastreo y qué uso se desea que se dé a los datos una vez obtenidos? Ya hay iniciativas para abordar esta cuestión. Illyes está redactando un borrador de Internet del IETF junto con Martin Thomson, de Mozilla. La versión actual, fechada el 19 de agosto, propone actualizar el RFC 9309 para añadir a robots.txt una directiva «Content-Usage» y la correspondiente cabecera HTTP.
La división de funciones es clara. Allow y Disallow siguen determinando qué URL se pueden rastrear, mientras que Content-Usage expresa cómo se desea que se utilice el contenido obtenido. Esta preferencia solo se aplica a las rutas cuyo rastreo está permitido. En el ejemplo del borrador, a un robots.txt que permite el rastreo se añade una indicación Content-Usage con «train-ai=n».
Sin embargo, por ahora se trata de un documento de un grupo de trabajo. Según los registros del IETF Datatracker, todavía no se ha presentado para su revisión al IESG (el grupo directivo encargado de la normalización técnica de Internet), y el grupo de trabajo prevé enviarlo en agosto de 2026. La etiqueta «train-ai» aparece en otro borrador de vocabulario, fechado el 14 de septiembre, pero en él se aclara que no refleja el consenso del grupo de trabajo. La versión actual del borrador caduca el 20 de febrero de 2027 y quedará sustituida si antes se publica una versión revisada.
En otras palabras, la forma estandarizada de expresar una preferencia sobre el uso de los datos para entrenamiento, separada de la autorización de rastreo, sigue siendo por ahora un borrador. Es demasiado pronto para tratarla como una regla común que ya se pueda aplicar.
Codificar en porcentaje las URL en japonés es más seguro
En este episodio también se abordaron cuestiones prácticas ajenas a la IA. Cherry Prommawin, de Google, recomendó que, al incluir en robots.txt rutas con caracteres de otros idiomas o emojis, «se utilice la forma codificada». El analizador de Google puede convertir los caracteres sin codificar y procesarlos, pero otros rastreadores, sobre todo los más antiguos, podrían confundirse.
En el vídeo, un ejemplo con emojis escritos tal cual llevaba la etiqueta «funciona en Google, pero podría fallar en otros sitios», mientras que otro con codificación porcentual aparecía como «método seguro y estándar». Según la página de especificaciones de Google, su analizador trata del mismo modo el UTF-8 sin codificar y la codificación porcentual. La gramática de RFC 9309 también permite caracteres UTF-8 en las rutas, pero no hay garantía de que los rastreadores de otras empresas los interpreten igual.
No son pocos los sitios que utilizan nombres de directorios o páginas en japonés en sus URL. Si se pretende controlar por separado a los rastreadores de IA, conviene prestar atención también a cómo se escriben las rutas.
Qué pueden hacer ahora los administradores de sitios web
En resumen, las medidas para limitar el uso por parte de la IA sin perder visibilidad en la Búsqueda de Google varían según el bot o el producto al que se dirijan. Para impedir que un rastreador de IA concreto acceda a las páginas, se puede usar una directiva Disallow dirigida a su agente de usuario. En el caso de Gemini, el mecanismo de control que Google señala oficialmente es Google-Extended, que se aplica tanto al entrenamiento como a la fundamentación.
En cambio, aún no existe más que en forma de borrador una sintaxis común que permita el rastreo, pero rechace el uso de los contenidos para el entrenamiento. Ya no basta con una sola línea de robots.txt para decidirlo todo: por ahora, es imprescindible consultar la documentación oficial de cada rastreador. Si avanza la estandarización, quizá algún día sea posible especificar por separado el control del acceso y las preferencias sobre el uso de los contenidos.
La descripción del vídeo anuncia que el próximo episodio de la serie tratará el código de estado 404.






コメント