
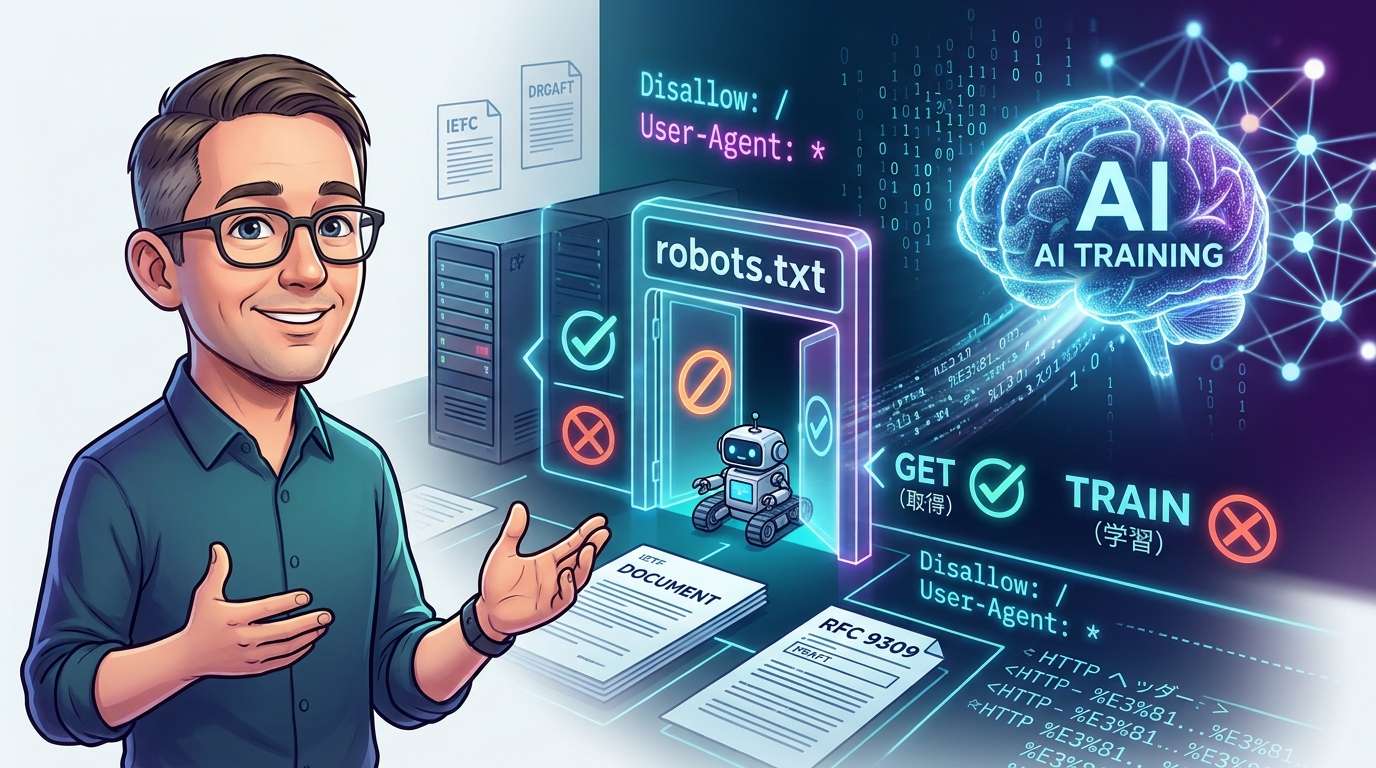
Google的Gary Illyes在Search Central视频系列《The Non-Canonical Cabinet》第2集中解释说,根据robots.txt标准规范RFC 9309,robots.txt用于规定爬虫可以抓取哪些URL,但不决定数据被抓取后的用途。他表示,如果想屏蔽特定的AI爬虫,就需要明确写出该爬虫的用户代理名称。
“拒绝抓取”和“禁止用于训练”是两回事
“只要在robots.txt里写上禁止用于AI训练,就可以放心了。”这种理解似乎正逐渐流传开来。但按照Illyes的解释,事情并没那么简单。robots.txt就像网站门口的一块指示牌,告诉来访者“可以从这扇门进来”。但进入网站的人如何使用带走的信息,并不在这块指示牌的管辖范围内。
Illyes将RFC 9309定义的robots.txt称为“表达访问意愿的协议”,并表示它无法指示系统如何处理已经抓取的数据。视频中有人提问:能否允许AI抓取内容,却禁止将同一信息用于生成式AI模型训练?答案是,单靠robots.txt无法区分这两种用途。
robots.txt只能决定是否允许访问
Google的规范页面列出了其支持的4项指令:User-Agent、Allow、Disallow和Sitemap。其他行均属无效内容,会被忽略。视频画面中出现了一条虚构指令“No-AI-Chicken-Training”,但Google的解析器不会读取这类自定义行。
RFC 9309第2.2.4节将如何处理超出规范范围的记录交由爬虫自行决定。也就是说,即使添加自定义行,对方是否遵循也取决于自己。它可能有效,也可能无效。至少,这并不是“标准保障的承诺”。
在实际操作中,最可靠的做法是单独指定想要屏蔽的AI爬虫的用户代理,并通过Disallow拒绝其访问。Illyes表示,如果想禁止其访问整个网站,就需要明确写出相应的令牌。
Google-Extended是Google专有的用途控制机制
那么,用于Google AI的Google-Extended又是什么?它是robots.txt中的一个令牌,本身没有独立的用户代理;Google仍使用现有爬虫进行抓取。Google的爬虫列表说明,该令牌用于“控制用途”。
它控制的是Google抓取的内容是否可用于训练未来的Gemini模型,或用于Gemini Apps以及Vertex AI上的Grounding with Google Search进行内容落地(参考信息,为回答提供依据)。据称,这不会影响内容在Google搜索中的收录,也不会成为搜索排名信号。
需要注意的是,这里的“用途控制”并非来自RFC 9309,而是Google在自家产品文档中定义的含义。它不是适用于其他公司AI的robots.txt通用规则。将其视为专供Google使用的开关更为恰当。
用于声明内容用途的标准提案仍处于草案阶段
能否将是否允许抓取与抓取后的用途意愿分开声明?围绕这一问题,目前也有相关进展。Illyes正与Mozilla的Martin Thomson共同撰写一份IETF互联网草案。当前版本日期为8月19日,内容是为robots.txt增加“Content-Usage”指令及相应的HTTP头,对RFC 9309进行更新。
两者的分工很明确:Allow和Disallow仍用于决定哪些URL可以被抓取;Content-Usage则用于表达希望如何使用抓取到的内容。这项用途声明仅适用于允许爬虫抓取的路径。草案中的示例是在允许抓取的robots.txt中加入“train-ai=n”这一Content-Usage声明。
不过,目前这仍处于工作组文档阶段。IETF Datatracker的记录显示,该草案尚未提交给IESG(负责互联网技术标准化的管理组)审查,工作组计划于2026年8月提交。“train-ai”这一标签出现在另一份词汇草案中(日期为9月14日),但该草案明确说明,它并不代表工作组内部已达成共识。当前草案将于2027年2月20日到期,届时如有修订版发布,将取代现行版本。
也就是说,目前用于声明内容是否希望被用于训练、并将其与是否允许爬虫抓取相区分的标准写法,仍停留在草案阶段。现在就把它当作已可使用的通用规则还为时过早。
日文URL使用百分号编码更安全
本期节目还讨论了AI以外的实用话题。Google的切丽·普罗马温建议,如果要在robots.txt中写入包含非英语字符或表情符号的路径,「应使用编码后的形式」。这是因为Google的解析器可以对原始字符进行编码处理,但其他爬虫或旧版爬虫可能会因此产生混淆。
视频中,直接写入表情符号的示例被标注为「在Google上可用,但在其他地方可能会出问题」;百分号编码的示例则被标注为「安全且符合标准的做法」。根据Google的规范页面,该公司的解析器会将原始UTF-8与百分号编码视为相同内容。RFC 9309的语法也允许路径中包含UTF-8字符,但其他公司的爬虫未必会作出相同解释。
不少网站会在URL中使用日语目录名或页面名。如果想分别控制AI爬虫,也需要留意路径的写法。
网站运营者现在可以采取的措施
总的来说,如果想限制AI使用内容,同时保持其在Google搜索中的呈现效果,应根据目标机器人或产品采取不同措施。对于特定AI爬虫,可以通过指定用户代理的Disallow规则,阻止其访问页面。对于Gemini,Google官方公布的控制方式是Google-Extended,适用于训练和接地两种用途。
另一方面,目前仍只有草案提出了在允许爬取的同时拒绝训练的通用写法。仅靠robots.txt中的一行就能决定一切的时代尚未到来,眼下仍离不开查阅各爬虫官方文档的工作。如果标准化取得进展,或许未来可以分别声明访问入口的管理方式和内容使用意愿。
另外,视频简介中介绍,系列下一期将讨论404状态码。






コメント