
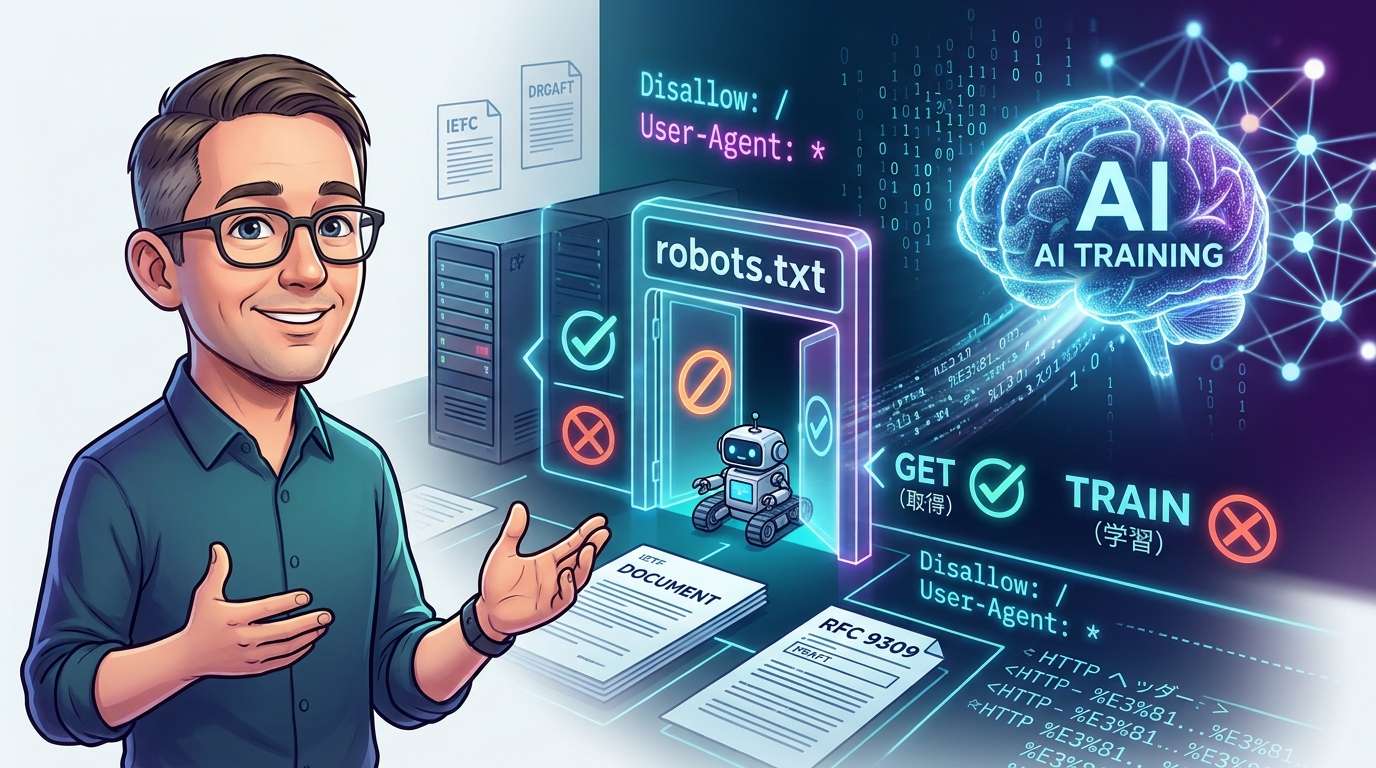
Google 的 Gary Illyes 在 Search Central 影片系列《The Non-Canonical Cabinet》第 2 集中說明,依照標準規格 RFC 9309,robots.txt 用來規定爬蟲可以抓取哪些 URL,但不會決定資料抓取後如何處理。他表示,若想封鎖特定 AI 爬蟲,就必須明確寫出該爬蟲的使用者代理程式(User-Agent)。
「拒絕抓取」和「不讓內容用於訓練」是兩回事
「只要在 robots.txt 寫上禁止 AI 訓練就能放心。」這種理解似乎正逐漸流傳開來。然而,依照 Illyes 的說明,事情並沒有這麼簡單。robots.txt 就像網站門口的告示牌,告訴訪客「可以從這扇門進入」。至於進入者帶走資訊後會如何使用,並不在這塊告示牌的管轄範圍內。
Illyes 將 RFC 9309 定義的 robots.txt 定位為「表達存取偏好的協定」,並表示它無法指示系統如何處理已抓取的資料。影片中的提問是:能否設定為允許 AI 抓取,但不讓相同資訊用於生成式 AI 模型訓練?答案是,只靠 robots.txt 無法區分這兩種用途。
robots.txt 只能決定是否允許存取
Google 規格說明頁列出該公司支援的 4 個項目:User-Agent、Allow、Disallow 和 Sitemap。除此之外的行都無效,會被忽略。影片中畫面出現了虛構指令「No-AI-Chicken-Training」,但 Google 的剖析器不會讀取這類自訂行。
RFC 9309 第 2.2.4 節將如何處理規格範圍外的記錄,交由爬蟲自行決定。換句話說,即使加上自訂行,是否遵循仍取決於對方。可能有效,也可能無效;至少它並不是「標準所保障的承諾」。
實務上要確實封鎖的方法,是個別指定想要阻止的 AI 爬蟲之使用者代理程式,並透過 Disallow 拒絕其存取。Illyes 表示,若要拒絕整個網站的存取,就必須明確寫出目標 token。
Google-Extended 是 Google 專屬的使用控制方式
那麼,供 Google AI 使用的 Google-Extended 又是什麼?它是 robots.txt 中的一個 token,本身沒有獨立的使用者代理程式;Google 會使用既有爬蟲進行巡覽。該公司在爬蟲清單中說明,這個 token 用於「控制用途」。
它控制的是 Google 抓取的內容是否會用於訓練未來的 Gemini 模型,以及是否會用於 Gemini Apps,或 Vertex AI 上的 Grounding with Google Search 進行 grounding(參照可佐證答案的資訊)。據稱,這不會影響內容是否列入 Google 搜尋,也不是搜尋排名訊號。
這裡值得注意的是,「控制用途」的含義並非來自 RFC 9309,而是 Google 在自家產品文件中定義的。因此,它並不是適用於其他公司 AI 的 robots.txt 通用規則。將它視為 Google 專用的開關,較為恰當。
表明內容用途的標準化提案仍處於草案階段
能不能將是否允許抓取,與取得內容後的使用偏好分開表明?針對這項課題,目前也有相關進展。Illyes 正與 Mozilla 的 Martin Thomson 共同撰寫 IETF 網際網路草案。8 月 19 日的現行版本,旨在更新 RFC 9309,於 robots.txt 中加入「Content-Usage」規則,以及相應的 HTTP 標頭。
兩者的分工很明確:Allow 和 Disallow 維持原有功能,用來決定哪些 URL 可以抓取;Content-Usage 則表明希望如何使用取得的內容。這項偏好只適用於允許爬蟲抓取的路徑。草案中的範例是在允許抓取的 robots.txt 中,加入「train-ai=n」這項 Content-Usage 設定。
不過,目前這仍處於工作小組文件階段。IETF Datatracker 的紀錄顯示,文件尚未提交給 IESG(負責網際網路技術標準化的管理小組)審查,工作小組預定於 2026 年 8 月送交。「train-ai」標籤出現在另一份詞彙草案中(日期為 9 月 14 日),但該草案明確指出,內容並未反映工作小組的共識。現行草案將於 2027 年 2 月 20 日失效;若在此之前發布修訂版,修訂版就會取代它。
也就是說,目前仍只有草案提出了將訓練用途偏好與爬蟲許可分開表明的標準寫法。現在就把它當成已可使用的通用規則,還言之過早。
日文 URL 使用百分比編碼較安全
本集也談到 AI 以外的實務議題。Google 的 Cherry Prommawin 建議,若要在 robots.txt 中寫入包含非英文字元或表情符號的路徑,「應使用編碼格式」。這是因為 Google 的解析器能將原始字元編碼後處理,但其他爬蟲或較舊的爬蟲可能會因此混淆。
影片中,直接寫入表情符號的範例標示為「在 Google 可運作,但其他地方可能會出錯」;百分比編碼的範例則標示為「安全且符合標準的方法」。根據 Google 的規格頁面,該公司的解析器會將原始 UTF-8 和百分比編碼視為相同格式。RFC 9309 的文法也允許路徑使用 UTF-8 字元,但其他公司的爬蟲未必會採取相同解讀。
不少網站會在 URL 中使用日文目錄名稱或頁面名稱。若要分別控制 AI 爬蟲,也應留意路徑的寫法。
網站經營者現在可以採取的做法
簡單來說,若要限制 AI 使用,同時維持網站在 Google 搜尋中的呈現,應採取的做法會因目標機器人或產品而異。對特定 AI 爬蟲,可以透過指定使用者代理程式的 Disallow 指令,禁止其存取頁面。至於 Gemini,Google 官方指出可透過 Google-Extended 控制,涵蓋訓練與 grounding。
另一方面,允許爬取、但拒絕內容用於訓練的通用寫法,目前仍只存在於草案中。如今已不是只靠 robots.txt 一行就能決定一切的時代,短期內仍不可或缺的是查閱各爬蟲的官方文件。若標準化有所進展,未來或許能分別管理爬取權限與表達對內容用途的意願。
影片說明欄指出,系列下一集將探討 404 狀態碼。






コメント