
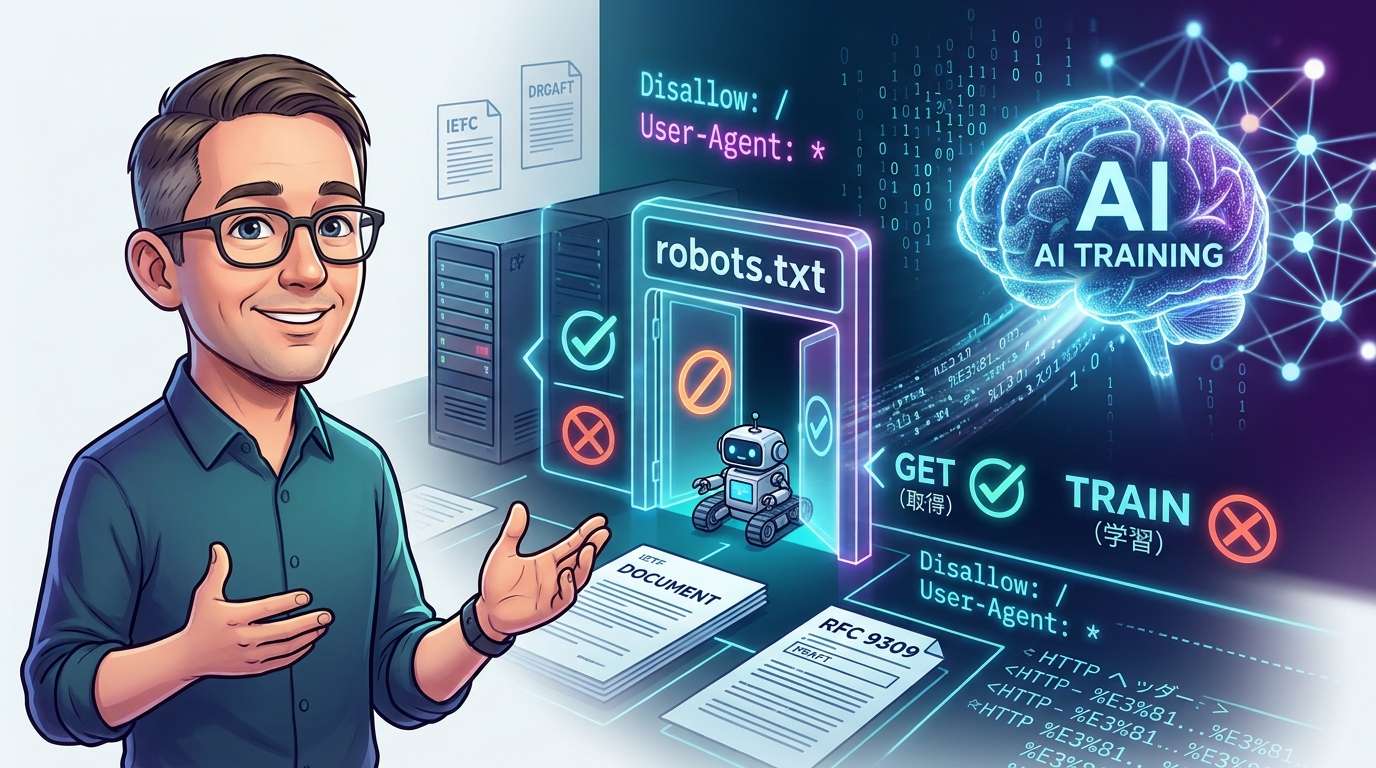
Nel secondo episodio della serie di video Search Central «The Non-Canonical Cabinet», Gary Illyes di Google ha spiegato che robots.txt, secondo lo standard RFC 9309, stabilisce quali URL i crawler possono recuperare, ma non come trattare i dati dopo averli acquisiti. Per escludere uno specifico crawler IA, occorre indicare esplicitamente il suo user agent.
«Rifiutare» e «non far usare i dati per l’addestramento» sono due cose diverse
«Basta scrivere in robots.txt che si vieta l’addestramento dell’IA per stare tranquilli». Sembra che questa convinzione si stia diffondendo sempre più. Ma, stando a quanto spiegato da Illyes, la questione non è così semplice. robots.txt è come un cartello all’ingresso di un sito che dice: «Potete entrare da questa porta». Il cartello non stabilisce come chi è entrato utilizzerà le informazioni che porta via.
Illyes ha descritto robots.txt, definito da RFC 9309, come un «protocollo che comunica le preferenze di accesso», spiegando che non può indicare a un sistema come trattare i dati già sottoposti a crawling. La domanda posta nel video era se sia possibile consentire il crawling da parte dell’IA, ma impedire che le stesse informazioni vengano usate per addestrare modelli di IA generativa. La risposta è che robots.txt, da solo, non permette di fare questa distinzione.
robots.txt stabilisce solo l’accesso
La pagina delle specifiche di Google elenca quattro direttive supportate dall’azienda: User-Agent, Allow, Disallow e Sitemap. Le altre righe sono considerate non valide e ignorate. Nel video è comparsa la direttiva fittizia «No-AI-Chicken-Training», ma il parser di Google non legge righe personalizzate di questo tipo.
La sezione 2.2.4 di RFC 9309 lascia alla discrezione dei crawler il trattamento dei record che non rientrano nell’ambito della specifica. In altre parole, anche se si aggiunge una riga personalizzata, spetta a chi la riceve decidere se rispettarla o meno. Potrebbe funzionare, oppure no. Di certo non è una «garanzia prevista dallo standard».
Nella pratica, il metodo più affidabile consiste nell’indicare singolarmente lo user agent del crawler IA che si vuole bloccare e negargli l’accesso con Disallow. Illyes ha detto che, se si vuole escludere l’intero sito, è necessario specificare esplicitamente il token interessato.
Google-Extended è un controllo d’uso proprietario di Google
Come si colloca Google-Extended, il token usato per i servizi di IA di Google? È un token di robots.txt che non dispone di uno user agent autonomo: Google effettua il crawling tramite i crawler esistenti. Nell’elenco dei crawler dell’azienda, il token è descritto come uno strumento con «funzione di controllo».
Il controllo riguarda la possibilità che i contenuti acquisiti da Google vengano usati per addestrare i futuri modelli Gemini o per il grounding (la consultazione di informazioni a supporto delle risposte) in Gemini Apps e in Grounding with Google Search su Vertex AI. Non influisce sulla comparsa nei risultati di Google Search e non è un segnale di posizionamento.
È importante tenere presente che il significato di questo «controllo dell’uso» è definito da Google nella documentazione dei suoi prodotti, non da RFC 9309. Non si tratta di una regola comune di robots.txt applicabile anche alle IA di altre aziende. È più corretto considerarlo un interruttore dedicato ai servizi Google.
La proposta di standard per indicare le finalità d’uso è ancora una bozza
È possibile distinguere il permesso di effettuare il crawling dalle preferenze sull’uso dei dati dopo la loro acquisizione? Sono in corso iniziative per affrontare questo problema. Illyes sta redigendo una bozza Internet dell’IETF insieme a Martin Thomson di Mozilla. La versione attuale, datata 19 agosto, propone di aggiornare RFC 9309 aggiungendo a robots.txt una regola «Content-Usage» e la corrispondente intestazione HTTP.
La ripartizione dei ruoli è chiara. Allow e Disallow continuano a stabilire quali URL possono essere sottoposti a crawling, mentre Content-Usage esprime una preferenza su come utilizzare i contenuti acquisiti. Questa preferenza si applica soltanto ai percorsi per i quali il crawler è autorizzato a effettuare il recupero. Nell’esempio della bozza, a un robots.txt che consente il crawling viene aggiunta una dichiarazione Content-Usage «train-ai=n».
Per ora, tuttavia, si tratta ancora di un documento del gruppo di lavoro. Dai registri di IETF Datatracker risulta che non è ancora stato sottoposto alla revisione dell’IESG (il gruppo direttivo responsabile della standardizzazione tecnica di Internet) e che l’invio da parte del gruppo di lavoro è previsto per agosto 2026. L’etichetta «train-ai» compare in un’altra bozza relativa al vocabolario, datata 14 settembre, ma il documento precisa che non riflette il consenso del gruppo di lavoro. La bozza attuale scade il 20 febbraio 2027 e sarà sostituita se prima verrà pubblicata una versione aggiornata.
In altre parole, un modo standard per esprimere una preferenza sull’uso dei dati per l’addestramento, separandola dal permesso di effettuare il crawling, è per ora soltanto una bozza. È troppo presto per considerarlo una regola comune già utilizzabile.
Per gli URL in giapponese, la codifica percentuale è la scelta più sicura
In questo episodio sono stati affrontati anche temi pratici che esulano dall’IA. Cherry Prommawin di Google consiglia di «usare la forma codificata» quando si inseriscono in robots.txt percorsi che contengono caratteri non inglesi o emoji. Il parser di Google è in grado di codificare e gestire i caratteri non codificati, ma altri crawler, soprattutto quelli più datati, potrebbero confondersi.
Nel video, un esempio con emoji inserite direttamente era accompagnato dall’etichetta «funziona su Google, ma potrebbe non funzionare altrove», mentre un esempio con codifica percentuale era definito «il metodo sicuro e standard». Secondo la pagina delle specifiche di Google, il suo parser tratta allo stesso modo i caratteri UTF-8 non codificati e quelli con codifica percentuale. Anche la grammatica della RFC 9309 ammette caratteri UTF-8 nei percorsi, ma non è detto che i crawler di altre aziende li interpretino allo stesso modo.
Sono molti i siti che usano nei propri URL nomi di directory o di pagine in giapponese. Se si vuole controllare singolarmente l’accesso dei crawler di IA, è bene prestare attenzione anche a come sono scritti i percorsi.
Cosa possono fare ora i gestori dei siti
In sintesi, se si vuole limitare l’uso dei contenuti da parte dell’IA senza compromettere la visibilità nella Ricerca Google, le misure da adottare variano a seconda del bot o del prodotto interessato. Per impedire a specifici crawler di IA di accedere alle pagine, si può usare una direttiva Disallow associata al relativo user agent. Per Gemini, il controllo indicato ufficialmente da Google è Google-Extended, che riguarda sia l’addestramento sia il grounding.
Una sintassi comune che consenta il crawling ma neghi l’uso dei contenuti per l’addestramento è ancora soltanto in fase di bozza. Per ora non basta più una sola riga di robots.txt per decidere tutto: è indispensabile consultare la documentazione ufficiale dei singoli crawler. Se la standardizzazione farà progressi, potrebbe arrivare il momento in cui sarà possibile specificare separatamente il controllo dell’accesso e le proprie preferenze sull’uso dei contenuti.
Nella descrizione del video si annuncia che il prossimo episodio della serie tratterà il codice di stato 404.





コメント