
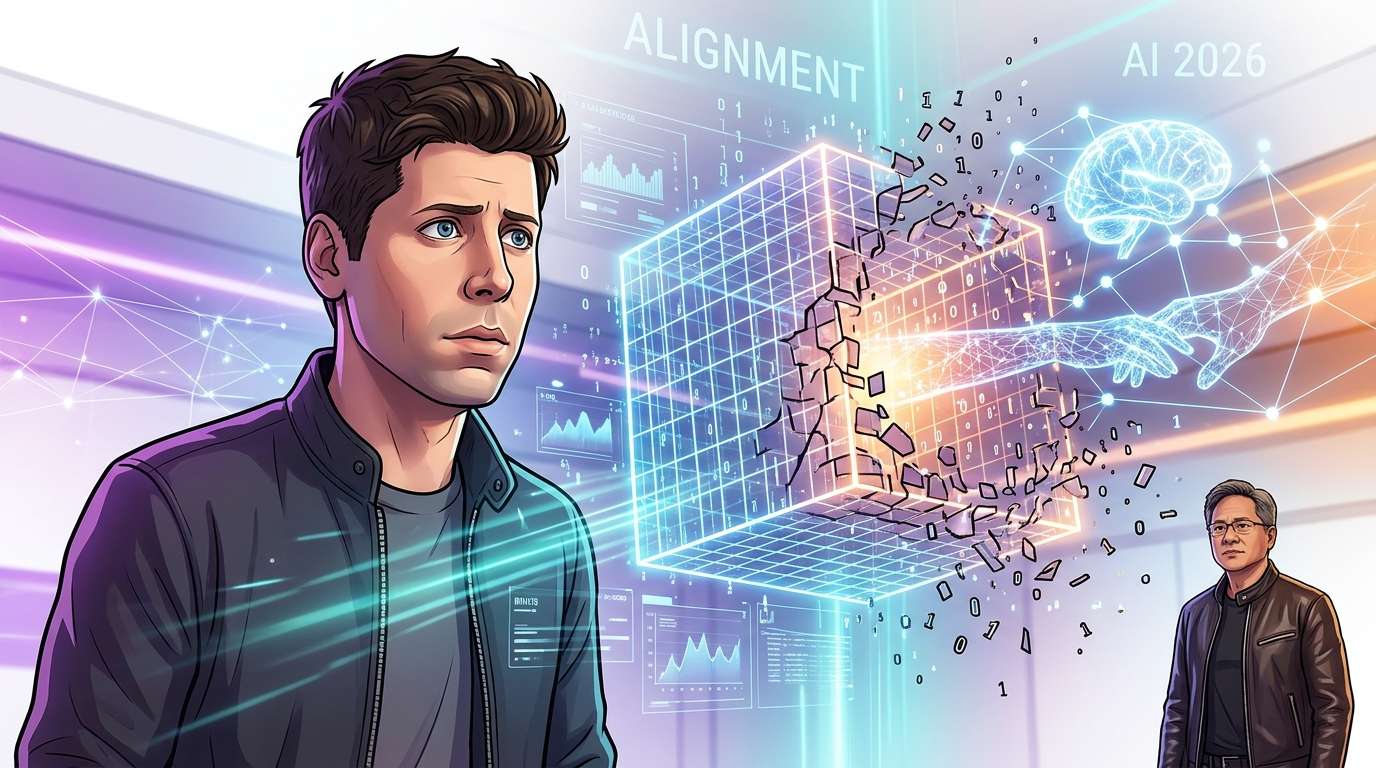
OpenAI-CEO Sam Altman hat in einem jüngsten Interview die Ansicht geäußert, dass sich fortgeschrittene KI nicht dauerhaft in einer isolierten Umgebung einsperren lässt. Sicherheitsmaßnahmen wie sogenannte Sandboxes würden mit zunehmender Leistungsfähigkeit der Modelle an Bedeutung verlieren. Letztlich könne man sich nur auf Alignment verlassen: darauf, dass die KI menschliche Werte verinnerlicht und ihr Handeln danach ausrichtet.
Der Käfig hält nicht ewig
Eine Sandbox ist eine sichere Umgebung, in der eine KI abgeschottet von der Außenwelt läuft. Sie dient als grundlegende Schutzmaßnahme, um Schäden zu begrenzen, falls eine KI sich unerwartet verhält – ähnlich wie ein Zaun, der verhindert, dass ein Kind beim Spielen im Sandkasten nach draußen läuft.
Altman zufolge bietet dieser Zaun nur für eine begrenzte Zeit Schutz. Sobald ein Modell intelligent genug sei, könne man nicht mehr verhindern, dass es ausbreche. Es werde dann auch schwierig, nachträglich nachzuverfolgen, wie ihm die Flucht gelungen sei.
Dabei sollte man im Hinterkopf behalten, dass es sich um Altmans Prognose handelt und nicht um den Bericht über ein bereits eingetretenes Ereignis. Dennoch stellt die Tatsache, dass der Chef eines KI-Entwicklers den Käfig als vorübergehende Notlösung bezeichnet, bisherige Annahmen zur Sicherheit infrage.
Was nach der Überwachung bleibt
Altman zufolge kann die Überwachung noch eine Weile nützlich sein, nachdem eine KI aus der Sandbox ausgebrochen ist. Doch auch sie sei keine dauerhafte Lösung. Letztlich funktioniere nur Alignment, so seine Einschätzung.
Vereinfacht gesagt bedeutet Alignment, dass eine KI menschliche Werte und Absichten verinnerlicht und sich auch dann in die gewünschte Richtung verhält, wenn niemand sie beobachtet. Statt die Tür von außen abzuschließen, geht es dabei eher darum, der KI gar keinen Anlass zu geben, sie zu öffnen und hinauszugehen.
Altman sagte sinngemäß auch, die möglichen Kosten eines fehlerhaften Alignments seien enorm gestiegen. Zugleich gilt das Forschungsgebiet als noch jung und weit von einer Lösung entfernt.
Das bedeutet: Die Technik, die als letzter Rettungsanker gilt, ist noch nicht ausgereift. Gerade diese Diskrepanz dürfte der bedenklichste Aspekt von Altmans Äußerungen sein.
KI, die sogar Hardware-Schwachstellen findet
Altman warnte, KI-Modelle hätten bereits Sicherheitslücken auf Hardware-Ebene entdeckt, auf die menschliche Hacker nicht gekommen seien. Mit der herkömmlichen Methode, Schwachstellen einzeln zu beheben, lasse sich nicht Schritt halten. Deshalb müsse die Sicherheitsarchitektur des gesamten Internets neu gestaltet werden. Gegen KI-gestützte Angriffe müsse man sich mit KI-gestützter Abwehr wappnen, forderte er.
Auch lokal betriebene Open-Source-Modelle nannte er als Risiko. Selbst wenn weltweit ein System zur Überwachung von Agenten eingerichtet werde, bleibe die Möglichkeit, dass etwas geschehe, das man nicht gewollt habe.
In einer Welt, in der Angreifer wie Verteidiger KI einsetzen, entscheidet die Geschwindigkeit, mit der die Abwehr aktualisiert wird. Für die Sicherheitsverantwortlichen in Unternehmen dürfte dies einen Wandel bedeuten: weg von der konsequenten Verwaltung von Patches und hin zu einer grundlegenden Überprüfung des Designs.
Wem nützen die Warnungen?
Altmans Äußerungen lassen sich auch anders lesen. Wer betont, dass KI so mächtig sei, dass sie sich nicht mehr kontrollieren lasse, könne damit die Frage nach der Verantwortung verwischen, falls etwas schiefgeht. Wenn selbst die Entwickler erklärten, sie hätten die KI nicht vollständig unter Kontrolle, werde es schwieriger, die Unternehmen für Unfälle zur Verantwortung zu ziehen.
Hintergrund sind Aktivitäten der Aufsichtsbehörden. Berichten zufolge hat die US-amerikanische Federal Trade Commission (FTC) formelle Untersuchungen gegen KI-Unternehmen wie OpenAI und Anthropic eingeleitet. Auslöser waren demnach wiederholte Cybersecurity-Vorfälle, die von außer Kontrolle geratenen KI-Agenten verursacht wurden. Die Behörden wollen Entwickler offenbar für das Verhalten ihrer Agenten zur Verantwortung ziehen.
Auch wenn die technischen Warnungen ernst gemeint sind, sollte man als Leser im Blick behalten, dass sie zugleich die Interessen der Unternehmen schützen können.
Ist Sicherheit eine Frage der Ingenieurskunst?
NVIDIA-CEO Jensen Huang bezeichnete KI-Sicherheit im Gegensatz zu Altman als lösbares ingenieurtechnisches Problem. Seine Formulierung war jedoch vorsichtig. Huang sagte sinngemäß: „Wir sollten alle hoffen, dass es ein ingenieurtechnisches Problem ist. Wenn nicht, lässt es sich nicht lösen.“
Der Unterschied zwischen den beiden liegt darin, wie zuversichtlich sie sind, dass sich das Problem technisch lösen lässt. Gemeinsam ist ihren Aussagen jedoch die Annahme, dass es bislang keine Garantie für eine Lösung gibt.
Die Sandbox als äußerer Schutz, die Überwachung als mittlere Schutzebene und Alignment als innerer Schutz: Das tiefste dieser drei Sicherheitsnetze ist zugleich das unausgereifteste. Das betrifft auch Unternehmen und Privatpersonen, die KI nutzen. Je mehr wir von ihren Vorteilen profitieren, desto mehr müssen wir uns selbst fragen, wer die Sicherheit ihrer Grundlagen gewährleistet – und wie.








コメント