
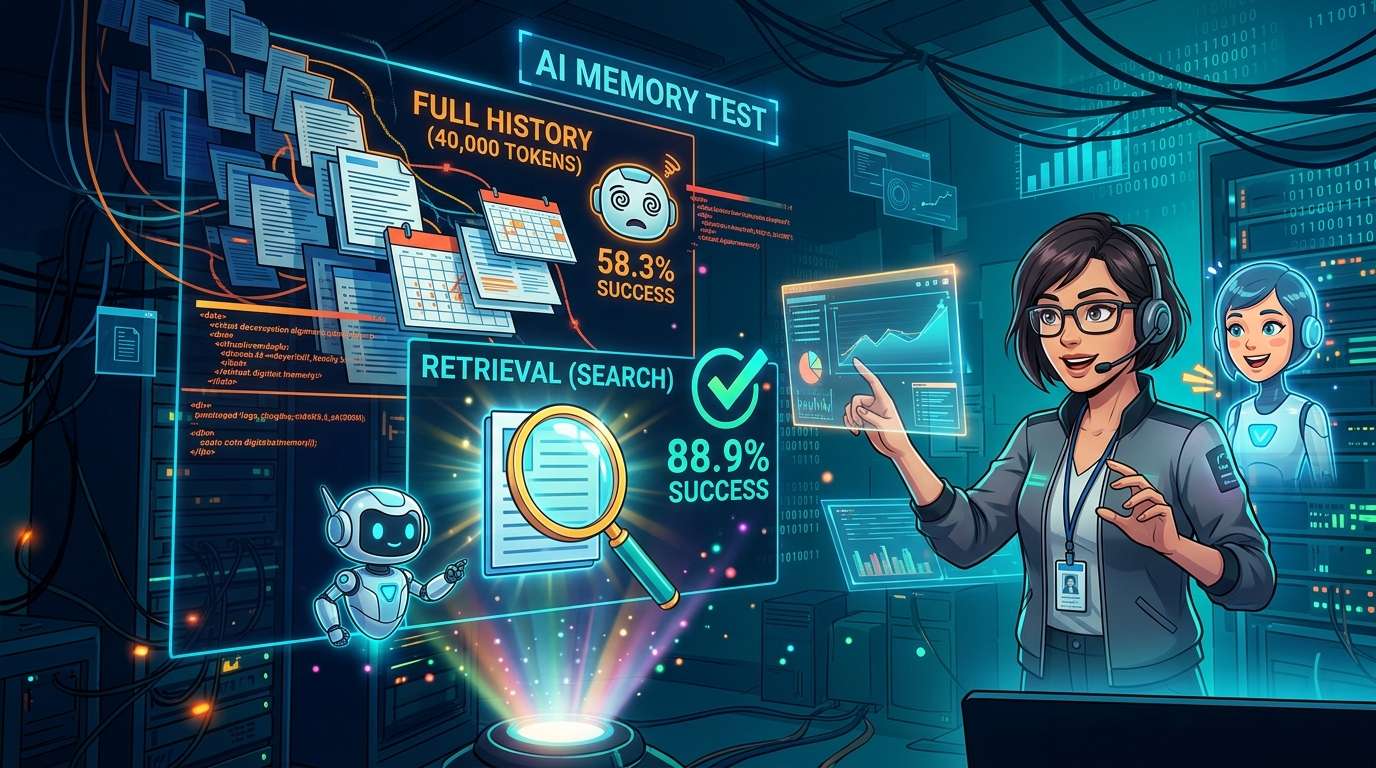
Eine Untersuchung, die vier Methoden vergleicht, KI-Assistenten ein „Gedächtnis“ zu geben, ist beim Data-Science-Medium Towards Data Science erschienen. In einem Test mit dem rund 40.000 Token umfassenden Verlauf eines fiktiven Projektmanagers und 30 Aufgaben lag die Erfolgsquote von GPT-4o mini bei 58,3 Prozent, wenn der gesamte Verlauf übergeben wurde. Wurden dagegen nur die benötigten Stellen gesucht und weitergegeben, waren es 88,9 Prozent.
„Sich erinnern“ und „etwas anwenden können“ sind zwei verschiedene Dinge
Ausgangspunkt der Untersuchung ist DolphinBench, ein neuer Test zur Messung der Gedächtnisleistung von KI. Der vollständige Text istin diesem Prüfberichtzu lesen.
Bei vielen herkömmlichen Gedächtnistests werden frühere Fakten direkt abgefragt, etwa: „In welchem Café trinkt Sam am liebsten Kaffee?“ Die Autoren von DolphinBench sehen jedoch ein Problem darin, dass die Frage selbst bereits den Hinweis gibt, dass die Antwort irgendwo festgehalten wurde. Deshalb wird bei diesem Test eine Aufgabe gestellt – etwa „Bestell Kaffee“ –, um zu prüfen, ob die KI den richtigen Fakt tatsächlich verwendet.
Das Testdesign sieht vor, drei fiktiven Personen jeweils einen Gesprächsverlauf von rund 500.000 Token zuzuordnen und jeder Person 200 Aufgaben zu stellen. Die Ergebnisse müssen neben der Genauigkeit auch Kosten und Zeit ausweisen.
Entwickelt wurde der Test von einem Unternehmen, das das Gedächtnissystem Mem0 vertreibt. In der Veröffentlichung erreicht die Konfiguration des Unternehmens mit 70,67 Prozent erfolgreich erledigten Aufgaben den Spitzenplatz. Der Autor der Untersuchung hat weder DolphinBench nachgebildet noch das Produkt eines bestimmten Unternehmens getestet. Er übernahm lediglich die Grundidee und entwickelte ein eigenes, kleineres Experiment.
Vier Gedächtnismethoden im Test mit Dana, einer fiktiven Projektmanagerin
Im Mittelpunkt des Experiments steht Dana Whitfield, eine fiktive Projektmanagerin. Dafür wurde ein einjähriger Gesprächsverlauf mit 80 Einträgen erstellt, in den gezielt einige Stolperfallen eingebaut wurden.
Ein Jahr Verlauf und 30 Aufgaben
Der Verlauf umfasst rund 40.000 Token. In 30 Einträgen wird jeweils ein Fakt genannt, etwa Danas bevorzugtes Mittagslokal, eine Besprechungszeit, das Veröffentlichungsdatum eines Projekts oder die zuständige Person. In 11 weiteren Einträgen werden diese Fakten später geändert. Die übrigen 39 Einträge enthalten belanglosen Gesprächsstoff über Drucker, Züge oder das Wetter. Damit die Fakten nicht hervorstechen, wurden bewusst Alltagsgespräche eingestreut.
Es gab 30 Aufgaben. Sie bestanden jeweils aus einem Tool-Aufruf zum Ansetzen eines Meetings, Bestellen einer Mahlzeit, Senden einer Nachricht oder Zuweisen einer Aufgabe. Neun davon erforderten zwei Fakten, etwa eine zuständige Person und ein Datum. Bewertet wurde nicht der Wortlaut der Antwort, sondern ausschließlich, ob die an das Tool übergebenen Werte korrekt waren. Zu jedem Fakt gab es außerdem eine gewöhnliche Frage, mit der geprüft wurde, ob das Modell mit dem neuesten Stand antworten konnte.
Die vier verglichenen Methoden
Verglichen wurden vier Methoden: „Kein Gedächtnis“, bei der nichts übergeben wird; „Gesamter Verlauf“, bei der jedes Mal der komplette Verlauf mit 40.000 Token übergeben wird; „Zusammenfassung“, bei der der Verlauf schrittweise gelesen und eine rund 1.000 Wörter lange Zusammenfassung fortlaufend überarbeitet wird; und „Abruf“, bei der fünf zum Auftrag passende Ausschnitte aus dem Verlauf herausgesucht und übergeben werden.
Man kann es sich so vorstellen: Entweder bekommt man jeden Morgen das Tagebuch eines ganzen Jahres in die Hand gedrückt, einen von jemandem erstellten Spickzettel oder bei jeder Aufgabe nur die passenden Seiten.
Als Modelle kamen GPT-4o mini von OpenAI und Claude Haiku 4.5 von Anthropic zum Einsatz, insgesamt gab es 1.260 Durchläufe. Die Aufzeichnungen zu allen Experimenten sind im Experiment-Management-Tool Weights & Biases hinterlegt.
コメント