
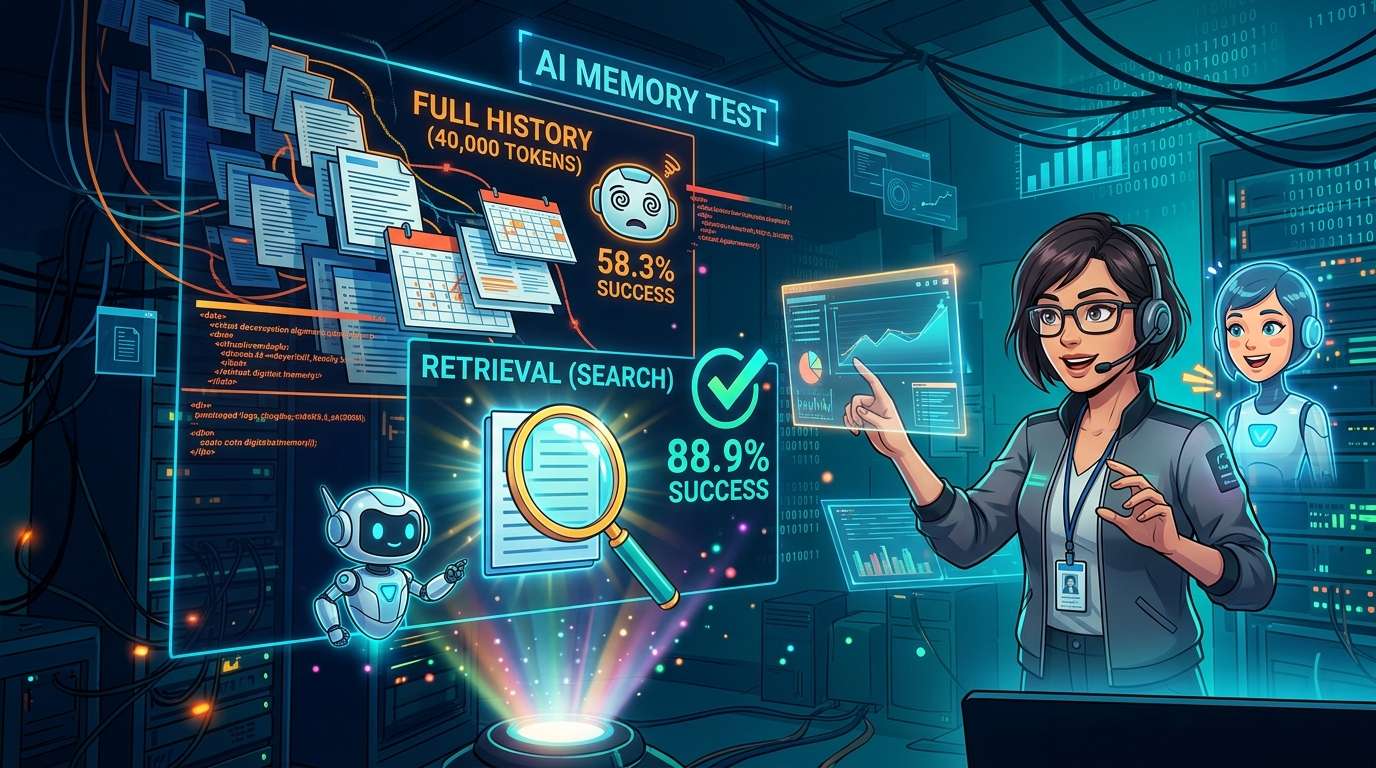
Uma avaliação que compara quatro métodos para dotar assistentes de IA de «memória» foi publicada no Towards Data Science, uma publicação especializada em ciência de dados. Num teste com o histórico de cerca de 40 mil tokens de um gestor de projetos fictício e 30 pedidos, a taxa de sucesso do GPT-4o mini foi de 58,3% quando lhe foi fornecido todo o histórico e de 88,9% com o método de pesquisa, que procura e fornece apenas os excertos necessários.
«Lembrar-se» e «saber usar» são coisas diferentes
A análise parte do DolphinBench, um novo teste para medir a capacidade de memória da IA. O artigo completo pode ser lidoneste artigo de análise.
Muitos dos testes de memória tradicionais fazem perguntas diretas sobre factos do passado, como «Qual é o café de que o Sam gosta?». No entanto, os criadores do DolphinBench apontam como problema o facto de a própria pergunta dar a pista de que «a resposta está registada algures». Por isso, neste teste pede-se à IA que execute uma tarefa — «Encomenda café» — para verificar se consegue usar o facto correto.
O teste foi concebido para três pessoas fictícias, cada uma com um histórico de conversas de cerca de 500 mil tokens, e 200 pedidos por pessoa. Os resultados têm de incluir não só a precisão, mas também os custos e o tempo.
O teste foi criado pela empresa que comercializa o Mem0, um sistema de memória. Na apresentação dos resultados, a configuração da empresa ficou em primeiro lugar, tendo concluído com sucesso 70,67% dos pedidos. O autor da análise não reproduziu o DolphinBench nem testou o produto de uma empresa específica. Inspirou-se apenas na ideia e criou uma pequena experiência própria.
Quatro técnicas de memória testadas com Dana, uma gestora de projetos fictícia
A protagonista da experiência é Dana Whitfield, uma gestora de projetos fictícia. Foi preparado um histórico de conversas de um ano, com 80 entradas, incluindo algumas situações deliberadamente criadas para o teste.
Um ano de histórico e 30 pedidos
O histórico tem cerca de 40 mil tokens. Destas entradas, 30 apresentam cada uma um facto — o restaurante onde Dana costuma almoçar, a hora de uma reunião, a data de lançamento de um projeto, quem é o responsável, entre outros. Em 11 entradas, esses factos são alterados posteriormente; as 39 restantes são conversas banais sobre impressoras, comboios ou o tempo. Foram incluídas propositadamente conversas do dia a dia para que os factos não se destacassem.
Há 30 pedidos. Cada um implica utilizar uma ferramenta para marcar uma reunião, encomendar uma refeição, enviar uma mensagem ou atribuir uma tarefa. Nove dos pedidos exigem dois factos, como o responsável e a data. A avaliação não teve em conta o texto da resposta: verificou apenas se os valores transmitidos à ferramenta estavam corretos. Também foi preparada uma pergunta convencional para cada facto, para verificar se a resposta indicava o valor mais recente.
As quatro abordagens comparadas
Foram comparadas quatro abordagens: «sem memória», sem fornecer qualquer informação; «histórico completo», fornecendo os 40 mil tokens do histórico em cada pedido; «resumo», lendo o histórico gradualmente e reescrevendo um resumo de cerca de mil palavras; e «pesquisa», que seleciona cinco excertos do histórico relacionados com o pedido e fornece-os ao modelo.
A diferença é semelhante a receber todas as manhãs o diário de um ano inteiro, uma folha de consulta de uma página preparada por alguém ou apenas as páginas relevantes, selecionadas de cada vez que surge um pedido.
Os modelos utilizados foram o GPT-4o mini, da OpenAI, e o Claude Haiku 4.5, da Anthropic, num total de 1 260 execuções. Os registos de todas as experiências estão disponíveis no Weights & Biases, uma ferramenta de gestão de experiências.
コメント