
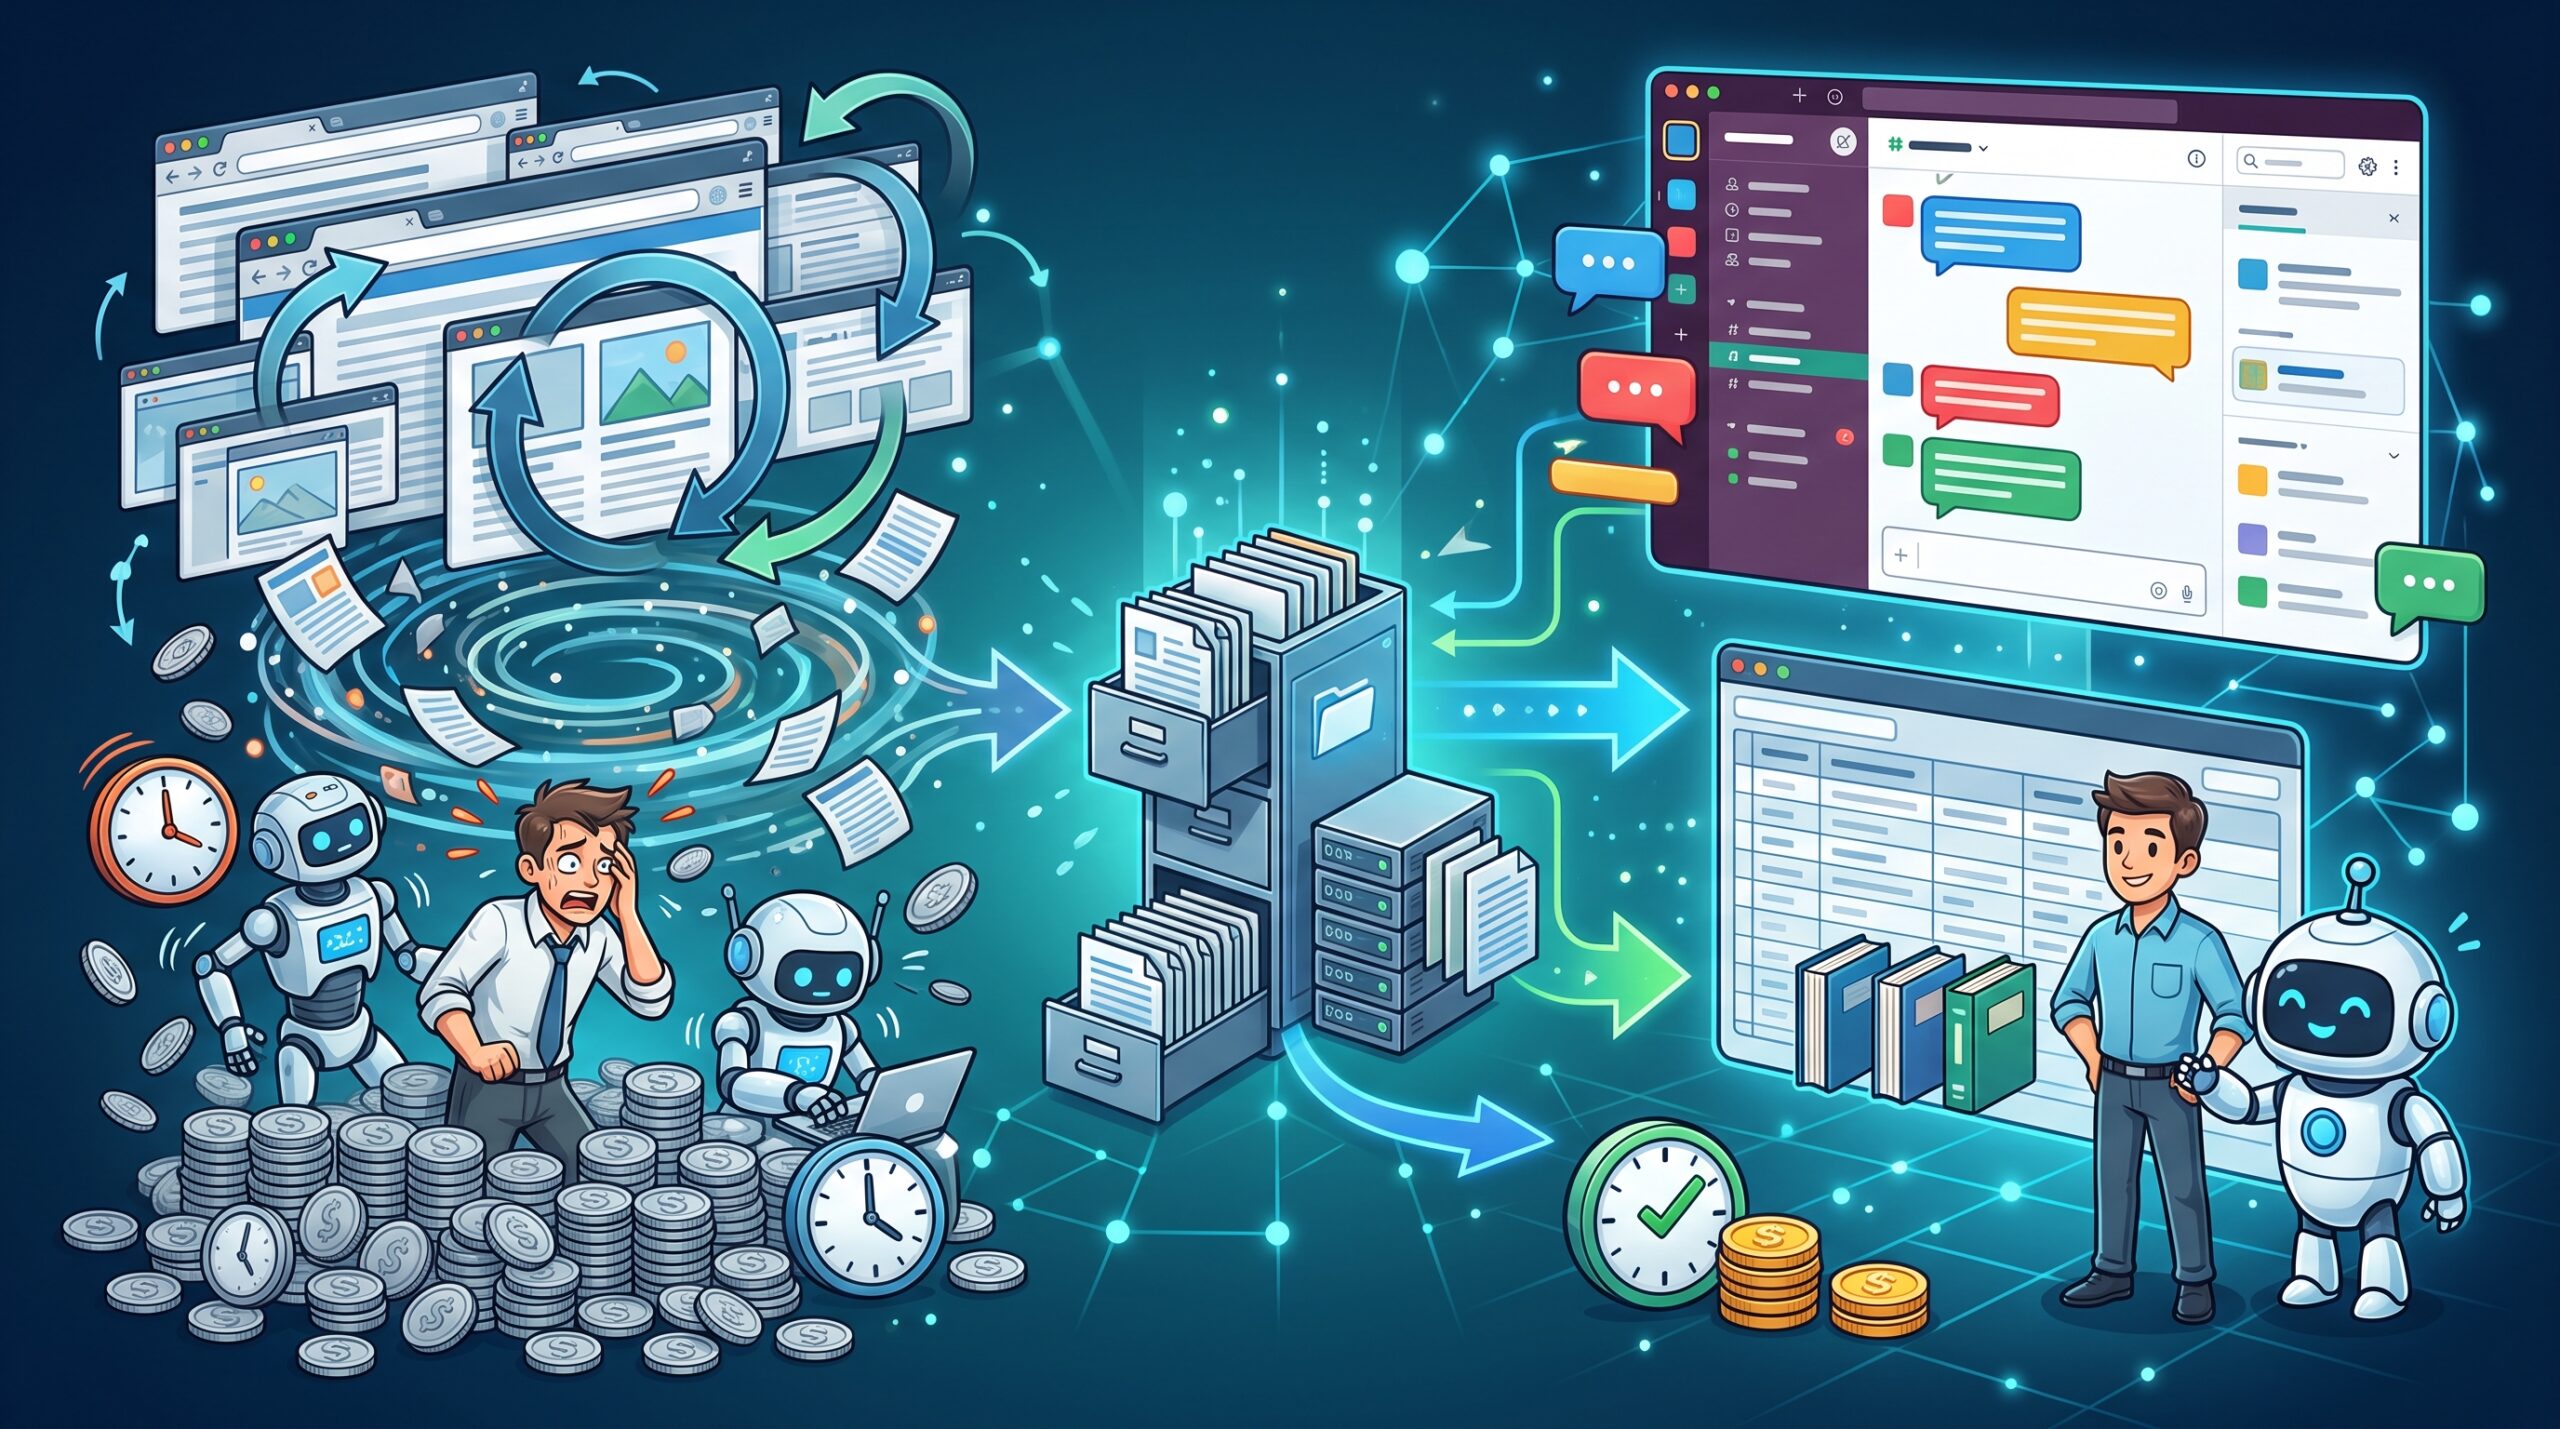
Asana mengumumkan bahwa dalam pengujian untuk mengoptimalkan AI pengoperasian browser StackAI, konfigurasi yang menggunakan GPT‑6.1 Sol mencatat estimasi biaya model rata-rata 0,47 dolar per eksekusi, dengan waktu eksekusi sekitar 4 menit. Dibandingkan konfigurasi produksi awal, biayanya turun menjadi sekitar 1/76, sedangkan prosesnya sekitar 5 kali lebih cepat.
Penurunan hingga 1/76 bukan semata-mata karena mengganti model
Membuka halaman web, mencari informasi yang diperlukan, lalu mengisi formulir. Agen browser yang melakukan tugas-tugas seperti ini berbeda dari AI yang hanya menghasilkan jawaban sekali: agen tersebut memanggil model berulang kali selama bekerja. StackAI, yang diakuisisi Asana, memungkinkan pelanggan menyusun alur otomatisasi lintas beberapa aplikasi bisnis tanpa menulis kode.
Hal penting dari angka-angka ini adalah penurunan sekitar 1/76 tersebut mencakup perbaikan alur kerja sekaligus pergantian model. Bahkan dengan Model B yang digunakan pada awalnya, optimasi menurunkan estimasi biaya model per eksekusi dari lebih dari 36,21 dolar menjadi 1,24 dolar. Setelah itu, penggunaan GPT‑6.1 Sol menurunkannya lagi menjadi 0,47 dolar. Sebagian besar penghematan telah tercapai sebelum model diganti.
Selain itu, biaya yang dimaksud di sini adalah estimasi biaya penggunaan model. Ini bukan berarti total biaya, termasuk biaya server serta tenaga kerja untuk pengembangan dan operasional, turun dengan persentase yang sama.
Jika riwayat dipangkas terlalu banyak, AI akan membaca ulang halaman yang sama
Frank Hidalgo, CTO StackAI yang memimpin penelitian, meminta GPT‑6 Astra dari Codex menganalisis kode dan menguji usulan perbaikan. Salah satu masalah yang ditemukan adalah isi halaman dan riwayat tangkapan layar dikirim ulang setiap kali model dimintai respons. Instruksi tetap dan sejenisnya dapat digunakan kembali, tetapi mekanisme yang sama tidak berlaku untuk riwayat penelusuran yang terus bertambah.
Selain itu, gambar lama dihapus dan teks dipangkas pada hampir setiap langkah. Jika riwayat terlalu sering diubah, cache yang menekan biaya dengan menggunakan kembali input yang telah diproses sebelumnya menjadi kurang efektif. Jika terlalu banyak informasi dihapus, AI mungkin perlu mengunjungi kembali halaman yang sudah dibacanya. Dengan demikian, upaya mempersingkat input justru berpotensi menambah pekerjaan.
Gambar tidak dihapus setiap kali; rapikan setelah terkumpul 20 gambar
Dalam pengujian, batas penyimpanan riwayat ditetapkan pada 120 ribu dan 480 ribu karakter, sementara kebijakan cache dan pengelolaan gambar diubah. Pengujian dilakukan sebanyak 144 kali dengan empat model. Tugasnya sama untuk semua pengujian: mengumpulkan enam informasi untuk masing-masing dari 32 buku di katalog demo publik.
Konfigurasi GPT‑6.1 Sol yang telah dioptimalkan menyimpan tangkapan layar hingga terkumpul 20 gambar, lalu hanya menyisakan satu gambar terbaru. Alih-alih menghapus gambar setiap kali, gambar dirapikan sekaligus agar riwayat dapat digunakan kembali lebih lama tanpa perubahan.
Bahkan jika hanya membandingkan GPT‑6.1 Sol, peninjauan cache dan pengelolaan gambar dengan batas penyimpanan riwayat yang lebih besar menurunkan estimasi biaya model dari 1,97 dolar menjadi 0,47 dolar. Setelah optimasi, 89% input diproses melalui cache, dan biaya untuk bagian tersebut hanya 5% dari biaya input biasa. Yang efektif bukan sekadar mengurangi informasi, melainkan merancang agar informasi yang dipertahankan mudah digunakan kembali.
Bukan hanya biaya yang turun, tingkat penyelesaian juga berubah
Pengelolaan riwayat juga memengaruhi kemampuan menyelesaikan tugas. Dengan GPT‑6.1 Sol, jawaban berhasil dihasilkan hanya dalam 3 dari 18 percobaan saat batas penyimpanan kecil. Ketika batasnya diperbesar, jawaban berhasil dihasilkan dalam seluruh 18 percobaan, dan semuanya dinyatakan benar.
Namun, perbandingan sekitar 1/76 dan sekitar 5 kali lebih cepat perlu dicermati. Dalam konfigurasi awal, beberapa eksekusi mencapai batas jumlah langkah sebelum selesai, sehingga angka biaya lebih dari 36,21 dolar dan waktu lebih dari 22,5 menit merupakan nilai batas bawah. Angka perbandingan utama juga merupakan rata-rata dari tiga eksekusi untuk setiap konfigurasi dan berasal dari tugas pengumpulan informasi ini. Belum dapat dipastikan bahwa persentase penghematan yang sama akan tercapai di situs atau pekerjaan lain.
Setiap model juga memiliki keunggulan yang berbeda. Setelah optimasi, Model C menyelesaikan tugas dalam 3,5 menit dengan biaya 0,66 dolar. Biayanya lebih tinggi daripada GPT‑6.1 Sol yang sebesar 0,47 dolar, tetapi waktu eksekusinya lebih singkat dibandingkan sekitar 4 menit. Saat menerapkan model, biaya dan kecepatan perlu dibandingkan secara terpisah.
AI menjalankan eksperimen, manusia memeriksa perubahan
Dalam pengujian ini, GPT‑6 Astra tidak hanya mengusulkan perbaikan, tetapi juga memperbaiki kode dan menjalankan pengujian agar kondisi eksperimen tetap seragam. Sesi model lain meninjau pekerjaan tersebut, sementara permintaan dan hasilnya dicatat di Command, platform pengembangan Asana. Hidalgo memperkirakan bahwa penelitian yang akan memakan waktu 1–2 bulan jika dilakukan secara manual dapat diselesaikan dalam sekitar satu minggu. Perbedaan durasi ini merupakan perkiraan dari pihak yang bertanggung jawab, bukan hasil eksperimen perbandingan yang dilakukan secara manual.
Pelajaran dari kasus ini adalah bahwa saat mempertimbangkan biaya operasional AI, cara pemanggilan model dan pengelolaan riwayat sama pentingnya untuk diteliti dengan tarif model. Asana telah menerapkan perubahan tersebut pada fitur pengoperasian browser StackAI. Ke depannya, perusahaan berencana mengintegrasikan pengujian ke dalam fitur evaluasi agar pelanggan dan tim internal dapat membandingkan biaya, waktu eksekusi, dan kualitas jawaban untuk setiap konfigurasi.






コメント