
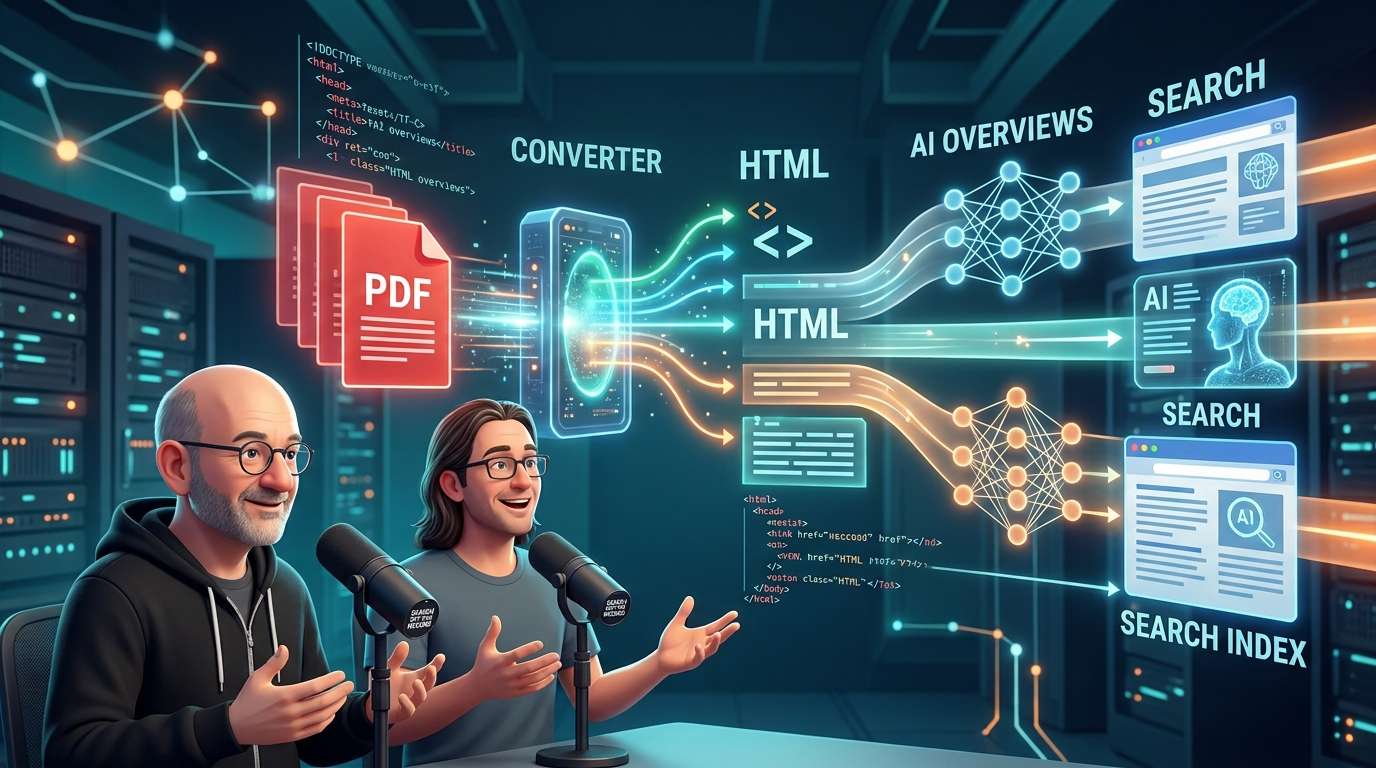
Google的John Mueller和Martin Splitt在公司的播客中介绍了搜索如何处理PDF。据他们介绍,搜索会通过专用转换功能将PDF转成HTML,并将HTML版本用于索引。PDF中的链接也会在转换后被识别,除了出现在常规搜索结果中,还可能显示在AI Overviews和AI Mode中。
PDF并非搜索范围之外的文件
你可能至少听过一次“PDF不利于SEO”这种说法。听过这次的解释后,我们或许需要稍微修正一下这种印象。
据Splitt介绍,搜索系统中有一个称为转换器的组件。它在渲染完成后、决定是否将内容纳入索引之前运行,并根据文件格式分派处理流程。支持的格式十分广泛,包括富文本、文档和Excel等,PDF转换功能也是其中之一。
转换后的输出是HTML,因此后续流程几乎只处理HTML。可以把它理解为:搜索并不是用PDF阅读器打开文件、查看内容,而是将其转换为与网页处于同一起跑线的形式。
链接为何有效,也就有了答案
PDF中嵌入的链接之所以能像普通链接一样发挥作用,也可以用同一套机制来解释。Splitt表示,系统会将文件转换为尽可能忠实于原始格式的HTML表示,因此也能识别链接等元素。Mueller补充说,这是因为Google会将文件转换成更接近其熟悉的网页的形式,所以链接也能使用。
对于以PDF形式发布资料或介绍页面的企业来说,这意味着从PDF链接到自家网站的链接可能并非毫无作用。
搜索结果和AI模式中都可能出现
PDF可能显示在AI Mode中的原因,也可以用转换机制来解释。与常规搜索一样,PDF会先转换为HTML再编入索引,因此也可能出现在AI Overviews或AI Mode中。Splitt表示,索引和排名基本上与其他文档的处理方式相同。
PDF在AI搜索中并不会被另行处理;只要进入搜索系统的基础流程,就能通过同样的入口。
纯图片PDF存在隐患
需要注意的是,并非所有PDF都会被作为文字读取。有些PDF看起来像文档,实际内容却是图片,例如仅将扫描页面保存为图片的PDF。
Splitt给出的判断方法很简单:尝试选中PDF中的文字并复制,再粘贴到文本编辑器中。如果能够粘贴,就说明它可以转换,并能用于排名。Mueller也表示,只要是可编入索引的文本,就能用于搜索。
对于PDF中的图片本身,Splitt没有给出确定的说法。普通图片会将URL传递给图片搜索流程进行处理,但PDF中的图片没有单独的URL。因此,他目前的判断是,这类图片可能无法像普通图片搜索那样处理。他也提到,今后这种处理方式可能会发生变化。至于文件大小上限,他表示,获取文件时应该也有不同于HTML的限制,但没有给出具体数字。
选择PDF的理由,以及HTML的易用性
那么,是否不应该制作PDF?Splitt的回答是:“如果内容需要,用PDF没问题。”他说,如果需要严格控制打印时的版式,或者文档需要像表单一样进行交互,PDF就很适合。他还举例说,可以用PDF制作住宿设施的预订表单。
餐厅菜单也成为了讨论话题。许多店铺会直接发布印刷公司制作的PDF;相比不发布菜单,这样要好得多。Mueller也表示,如果只能在发布菜单和不发布之间二选一,那么用PDF发布更好。
另一方面,如果可以在PDF和普通网页之间选择,Mueller更倾向于后者,因为网页更便于操作。他表示,如果同样的内容可以做成HTML,事情就会轻松一些。Splitt本人也更倾向于灵活性更高的HTML。
尽量不给搜索引擎添麻烦
从这次的解释中可以看出,问题并非简单地二选一:PDF在搜索中究竟是有利还是不利。关键在于,用户找到信息的路径有多短。
PDF需要经过一道转换流程才能进入搜索。因此,如果相同内容可以用HTML提供,稳妥的做法是从一开始就采用搜索引擎和读者都更容易处理的形式。网页打开后即可阅读,而且在智能手机上也不容易变形;HTML的这些特性同样提升了用户体验。
如果要检查自家网站上的PDF,可以先确认其中的文字能否复制。然后再判断哪些内容也可以用HTML提供。这样的顺序或许是一个切实可行的起点。






コメント