
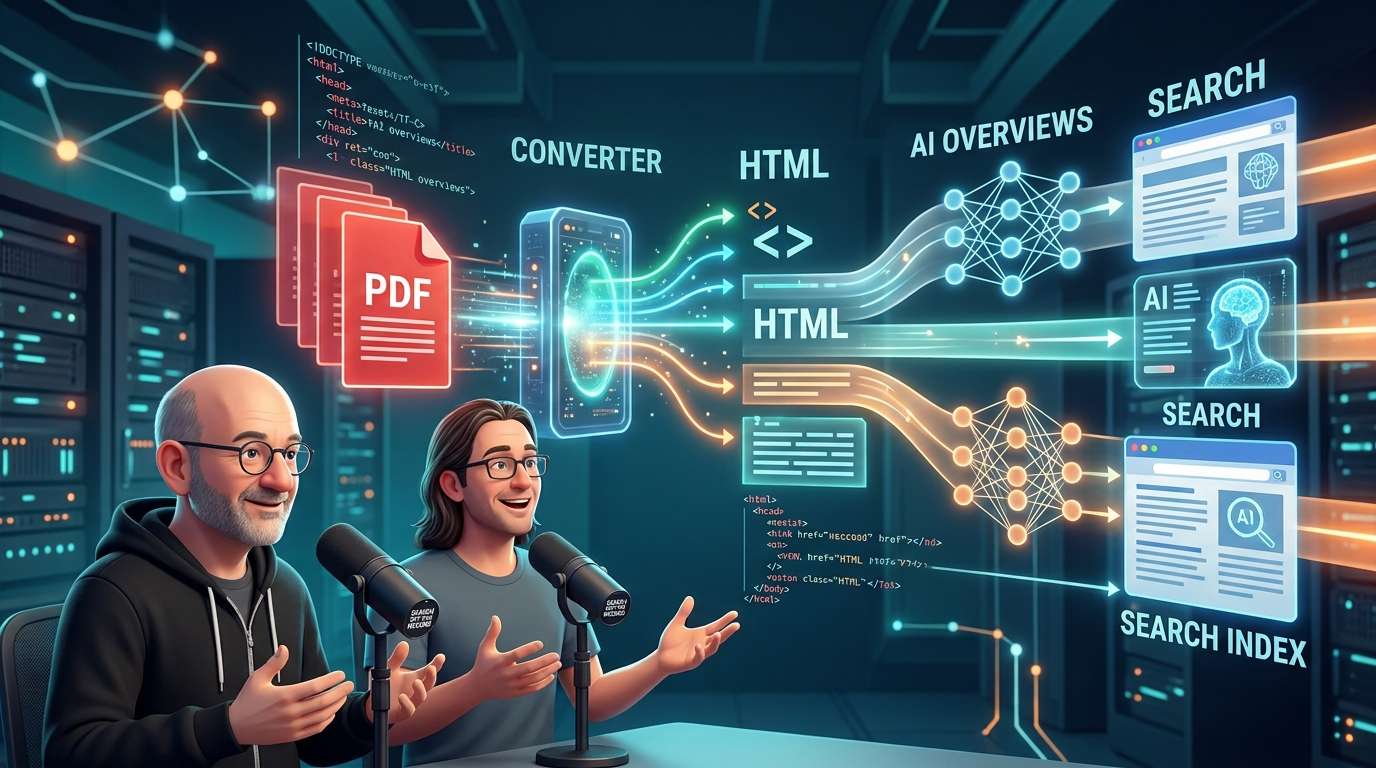
Google के John Mueller और Martin Splitt ने कंपनी के पॉडकास्ट में PDF को सर्च में प्रोसेस करने के तरीके के बारे में बताया। उनके मुताबिक, सर्च PDF को एक विशेष कन्वर्ज़न फ़ंक्शन की मदद से HTML में बदलता है और इंडेक्सिंग के लिए उसी HTML संस्करण का इस्तेमाल करता है। उन्होंने कहा कि PDF के लिंक भी कन्वर्ज़न के बाद पहचाने जाते हैं और सामान्य सर्च के अलावा AI Overviews तथा AI Mode में भी दिख सकते हैं।
PDF ऐसी फ़ाइलें नहीं हैं जो सर्च की पहुँच से बाहर हों
क्या आपने कभी सुना है कि “PDF SEO के लिए नुकसानदेह हैं”? इस बार की व्याख्या सुनने के बाद इस धारणा में थोड़ा बदलाव करना ज़रूरी है।
Splitt के मुताबिक, सर्च सिस्टम में कन्वर्टर नाम का एक घटक होता है। यह रेंडरिंग के तुरंत बाद और इस फ़ैसले से पहले काम करता है कि किसी फ़ाइल को इंडेक्स किया जाए या नहीं। यह फ़ाइल का फ़ॉर्मैट देखकर तय करता है कि उसे कैसे प्रोसेस करना है। रिच टेक्स्ट, दस्तावेज़ और Excel समेत कई फ़ॉर्मैट इसके दायरे में आते हैं, और PDF कन्वर्टर भी उनमें से एक है।
कन्वर्ज़न के बाद आउटपुट HTML होता है, इसलिए आगे की प्रक्रिया में लगभग केवल HTML से ही काम लिया जाता है। इसका मतलब यह नहीं कि PDF व्यूअर में फ़ाइल खोलकर उसकी सामग्री देखी जाती है; बल्कि उसे वेब पेज की तरह ही समझे जाने लायक रूप में बदल दिया जाता है।
लिंक काम क्यों करते हैं
PDF में एम्बेड किए गए लिंक सामान्य लिंक की तरह ही काम करते हैं—इसकी वजह भी यही प्रक्रिया है। Splitt ने बताया कि मूल फ़ॉर्मैट के प्रति यथासंभव निष्ठावान HTML रूप में बदलने के कारण लिंक जैसे तत्व भी पहचाने जा सकते हैं। Mueller ने आगे कहा कि Google इसे ऐसे रूप में बदलता है जो उन वेब पेजों जैसा है जिन्हें वह अच्छी तरह संभालना जानता है, इसलिए लिंक भी काम करते हैं।
जो कंपनियाँ दस्तावेज़ या जानकारी वाले पेज PDF के रूप में उपलब्ध कराती हैं, उनके लिए इसका मतलब है कि वहाँ से अपनी वेबसाइट पर दिए गए लिंक बेकार नहीं जाते।
सामान्य सर्च और AI Mode—दोनों में दिख सकते हैं
PDF, AI Mode में क्यों दिख सकते हैं, इसकी वजह भी कन्वर्ज़न प्रक्रिया से समझाई गई। सामान्य सर्च की तरह, PDF को HTML में बदलकर इंडेक्स किया जाता है, इसलिए वे AI Overviews और AI Mode में भी दिखाई दे सकते हैं। Splitt ने कहा कि इंडेक्सिंग और रैंकिंग के मामले में उन्हें अन्य दस्तावेज़ों की तरह ही लगभग समान तरीके से संभाला जाता है।
AI सर्च में PDF को अलग श्रेणी में नहीं रखा जाता। अगर वे सर्च की बुनियादी व्यवस्था में शामिल हैं, तो उसी रास्ते से सामने आ सकते हैं।
केवल इमेज वाले PDF में एक दिक्कत है
ध्यान रखने वाली बात यह है कि हर PDF का टेक्स्ट के रूप में पढ़ा जाना संभव नहीं होता। उदाहरण के लिए, स्कैन किए गए पन्नों को सिर्फ़ इमेज के रूप में सहेजने पर दस्तावेज़ देखने में भले ही टेक्स्ट जैसा लगे, लेकिन उसकी सामग्री इमेज होती है।
Splitt ने इसकी जाँच का एक आसान तरीका बताया: PDF में टेक्स्ट चुनकर कॉपी करें और उसे किसी टेक्स्ट एडिटर में पेस्ट करके देखें। अगर टेक्स्ट पेस्ट हो जाता है, तो उसे कन्वर्ट करके रैंकिंग के लिए इस्तेमाल किया जा सकता है। Mueller ने भी कहा कि इंडेक्स किए जा सकने वाले टेक्स्ट का इस्तेमाल सर्च में किया जा सकता है।
PDF के भीतर मौजूद इमेजों के बारे में Splitt ने कोई पक्का दावा नहीं किया। सामान्य इमेज को इमेज सर्च की प्रक्रिया में URL देकर प्रोसेस किया जाता है, लेकिन PDF में मौजूद इमेजों के अपने अलग URL नहीं होते। इसलिए उनका मानना है कि इन्हें सामान्य इमेज सर्च की तरह प्रोसेस करना संभव नहीं होगा। उन्होंने यह भी कहा कि भविष्य में यह तरीका बदल सकता है। फ़ाइल के आकार की सीमा के बारे में उन्होंने कहा कि HTML से अलग, फ़ाइलें हासिल करने की प्रक्रिया की अपनी सीमा होनी चाहिए, लेकिन कोई निश्चित संख्या नहीं बताई।
PDF चुनने की वजहें और HTML की सहूलियत
तो क्या PDF नहीं बनाने चाहिए? Splitt का जवाब था, “अगर सामग्री के लिए ज़रूरी हो, तो कोई समस्या नहीं।” उन्होंने कहा कि प्रिंट में रूप को सटीक रखना हो या फ़ॉर्म की तरह किसी दस्तावेज़ में उपयोगकर्ता को कुछ करने की ज़रूरत हो, तो PDF काम आ सकते हैं। उन्होंने ठहरने की जगह बुक करने के लिए PDF फ़ॉर्म का उदाहरण भी दिया।
रेस्तराँ के मेनू का मुद्दा भी चर्चा में आया। कई रेस्तराँ प्रिंटिंग कंपनी से बनवाया गया PDF सीधे अपनी वेबसाइट पर डालते हैं। ऐसा करना, मेनू उपलब्ध न कराने से कहीं बेहतर है। Mueller ने भी कहा कि मेनू डालना है या नहीं, इन दो विकल्पों में PDF के रूप में डालना बेहतर है।
हालाँकि, अगर PDF और सामान्य वेब पेज में से किसी एक को चुनना हो, तो Mueller वेब पेज को प्राथमिकता देते हैं। इसकी वजह उसे इस्तेमाल करना आसान होना है। उन्होंने कहा कि अगर उसी सामग्री को HTML में रखा जा सकता है, तो इससे चीज़ें थोड़ी आसान हो जाती हैं। Splitt ने भी अधिक लचीले HTML को प्राथमिकता देने की बात कही।
सर्च इंजन के लिए काम आसान रखने का नज़रिया
इस व्याख्या से यह बात सामने आती है कि PDF सर्च के लिए अच्छे हैं या बुरे—यह मामला सिर्फ़ इन दो विकल्पों तक सीमित नहीं है। अहम बात यह है कि जानकारी तक पहुँचने का रास्ता कितना छोटा है।
PDF को कन्वर्ज़न की एक अतिरिक्त प्रक्रिया से गुज़रने के बाद सर्च में शामिल किया जाता है। इसलिए, अगर वही सामग्री HTML में उपलब्ध कराई जा सकती है, तो शुरुआत से ही उसे ऐसा रूप देना बेहतर है जिसे सर्च इंजन और पाठक आसानी से इस्तेमाल कर सकें। HTML में पेज तुरंत खुलकर पढ़ा जा सकता है और स्मार्टफ़ोन पर उसका लेआउट बिगड़ने की आशंका भी कम होती है—ये खूबियाँ लोगों के लिए इसे इस्तेमाल करना आसान बनाती हैं।
अगर आप अपनी वेबसाइट पर मौजूद PDF की समीक्षा करना चाहते हैं, तो पहले जाँचें कि उसमें से टेक्स्ट कॉपी किया जा सकता है या नहीं। फिर देखें कि क्या वही सामग्री HTML में भी उपलब्ध कराई जा सकती है। यह क्रम एक व्यावहारिक शुरुआत हो सकता है।






コメント