
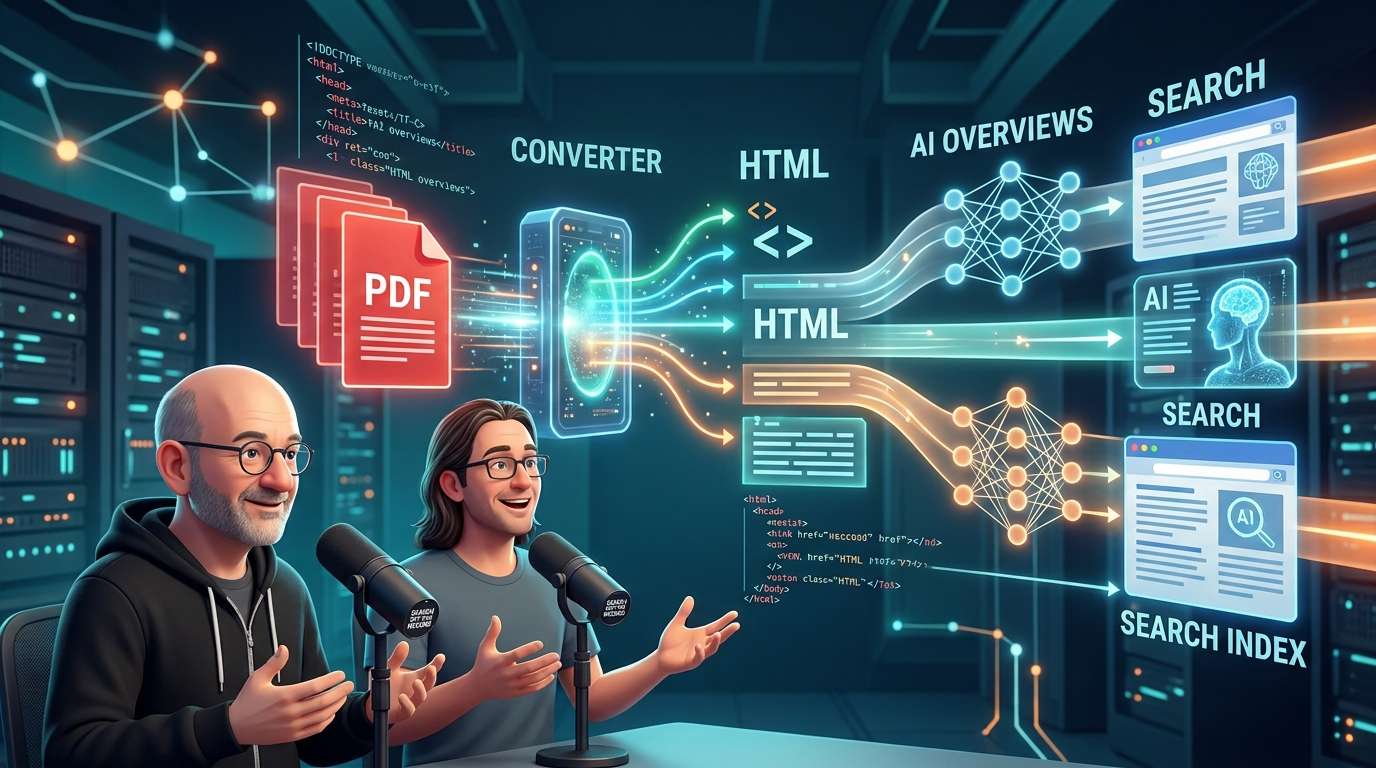
John Mueller y Martin Splitt, de Google, explicaron en el pódcast de la compañía cómo procesa la Búsqueda los PDF. Según contaron, el buscador convierte los PDF a HTML mediante una función específica y utiliza la versión HTML para indexarlos. Los enlaces incluidos en los PDF también se reconocen tras la conversión y pueden aparecer tanto en los resultados de búsqueda habituales como en AI Overviews y AI Mode.
Los PDF no quedan fuera del alcance de la búsqueda
¿Quién no ha oído alguna vez que «los PDF perjudican al SEO»? A la luz de las explicaciones de esta ocasión, quizá convenga matizar un poco esa impresión.
Según Splitt, el sistema de búsqueda incluye un componente llamado conversor. Se activa justo después de la renderización y antes de que se decida si un archivo se incorpora al índice, y distribuye su procesamiento según el formato. Admite una amplia variedad de formatos, como texto enriquecido, documentos y archivos de Excel; el conversor de PDF es uno de ellos.
El resultado de la conversión es HTML, así que las etapas posteriores trabajan casi exclusivamente con HTML. No es que el sistema abra el archivo en un visor de PDF y examine su contenido: la idea es trasladarlo al mismo terreno que las páginas web.
Por qué funcionan los enlaces
El mismo mecanismo explica que los enlaces insertados en un PDF funcionen igual que los enlaces habituales. Splitt explicó que, al convertir los archivos a una representación HTML lo más fiel posible al formato original, también se pueden detectar elementos como los enlaces. Mueller añadió que estos funcionan porque Google transforma el PDF en un formato similar al de una página web, que la compañía sabe manejar bien.
Para las empresas que distribuyen documentos o páginas informativas en PDF, esto significa que los enlaces a su propio sitio web incluidos en esos archivos podrían no ser en vano.
También aparecen en la búsqueda y en el modo IA
El mecanismo de conversión también explica por qué los PDF pueden aparecer en AI Mode. Al igual que en la búsqueda habitual, se indexan una vez convertidos a HTML, por lo que pueden mostrarse en AI Overviews y AI Mode. Splitt señaló que la indexación y la clasificación funcionan prácticamente igual que con otros documentos.
En otras palabras, los PDF no reciben un tratamiento aparte en la búsqueda con IA: si forman parte de la base de la búsqueda, pueden acceder a ella por la misma vía.
Los PDF compuestos solo por imágenes esconden una trampa
Conviene tener en cuenta que no todos los PDF se leen como texto. Algunos, como los creados al guardar páginas escaneadas únicamente como imágenes, parecen documentos, pero su contenido es en realidad una imagen.
Splitt propuso una forma sencilla de comprobarlo: seleccionar el texto del PDF, copiarlo e intentar pegarlo en un editor de texto. Si se puede pegar, significa que está en condiciones de convertirse y utilizarse para la clasificación. Mueller también indicó que el texto que se puede indexar puede utilizarse en la búsqueda.
Splitt evitó dar una respuesta definitiva sobre las imágenes incluidas en los PDF. Las imágenes normales se procesan enviando su URL a la etapa de búsqueda de imágenes, pero las que están dentro de un PDF no tienen una URL individual. Por eso, su hipótesis actual es que no se pueden procesar igual que las imágenes de la búsqueda habitual. También señaló que este tratamiento podría cambiar en el futuro. En cuanto al límite de tamaño de los archivos, dijo que probablemente exista un límite de obtención distinto del de HTML, aunque no dio una cifra concreta.
Por qué elegir un PDF y por qué el HTML resulta más cómodo
Entonces, ¿no se deberían crear PDF? La respuesta de Splitt fue: «Si el contenido lo requiere, no hay problema». Explicó que los PDF pueden ser útiles cuando se quiere controlar con precisión el aspecto al imprimir o cuando se trata de documentos interactivos, como formularios. Puso como ejemplo un formulario en PDF para reservar alojamiento.
También hablaron de los menús de restaurantes. Muchos establecimientos publican directamente el PDF creado por la imprenta, y la postura de Splitt es que eso es mucho mejor que no publicar nada. Mueller también dijo que, si las opciones son publicar el menú o no hacerlo, es mejor publicarlo aunque sea en PDF.
Por otro lado, si se puede elegir entre un PDF y una página web normal, Mueller prefiere esta última porque resulta más fácil de manejar. Añadió que, si el mismo contenido se puede ofrecer en HTML, eso ya facilita un poco las cosas. Splitt también se mostró partidario del HTML por su mayor flexibilidad.
La idea de no complicarle el trabajo al buscador
Lo que se desprende de estas explicaciones no es una respuesta binaria sobre si los PDF perjudican o favorecen la búsqueda. Lo importante es lo corto que sea el camino para llegar a la información.
Los PDF pasan por un paso adicional de conversión antes de aparecer en la búsqueda. Por eso, si se puede ofrecer el mismo contenido en HTML, lo más sensato es prepararlo desde el principio en un formato más fácil de manejar tanto para los buscadores como para los lectores. La posibilidad de abrir una página y leerla de inmediato, además de visualizarla correctamente en el móvil, también hace que el HTML sea más cómodo para las personas.
Si va a revisar los PDF de su sitio web, compruebe primero si se puede copiar el texto. Después, valore qué contenidos también se podrían ofrecer en HTML. Ese orden parece un punto de partida práctico.






コメント