
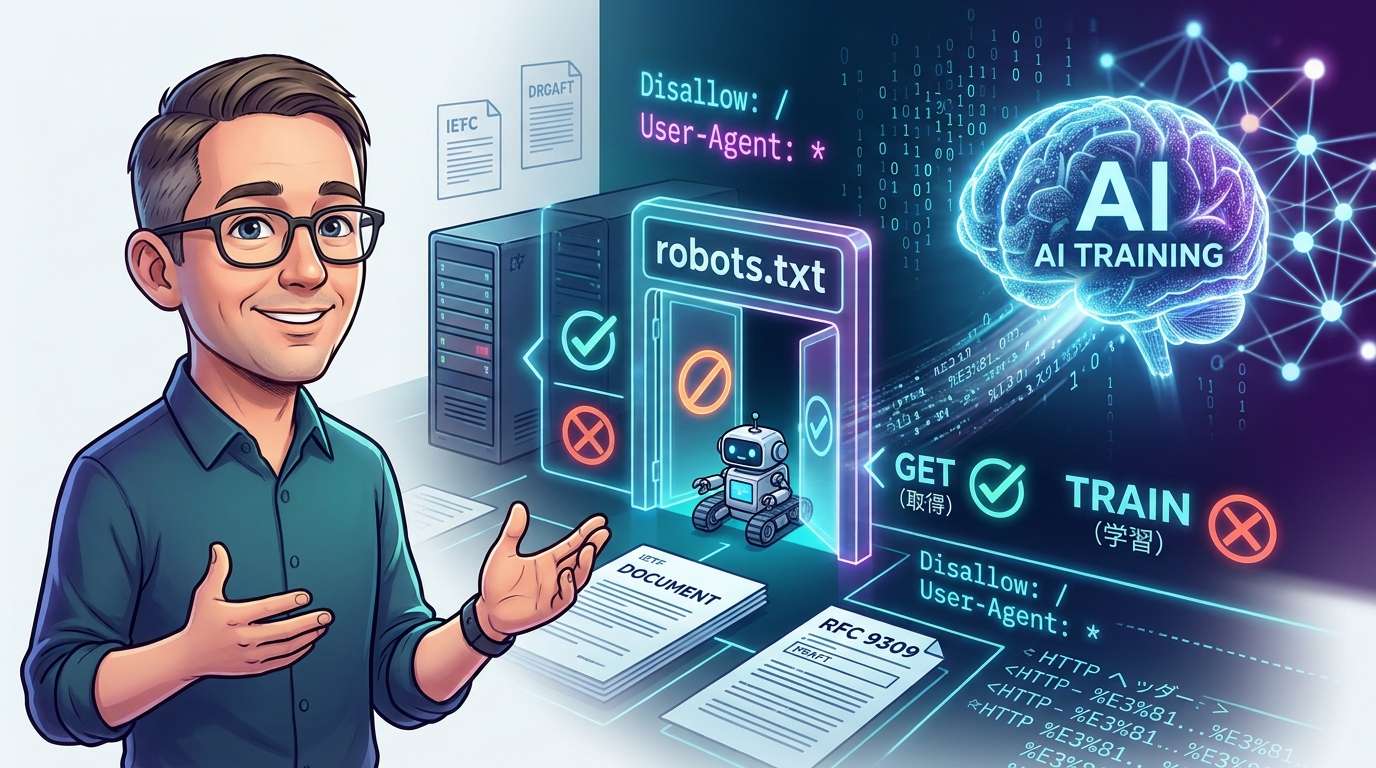
Lors du deuxième épisode de la série vidéo de Search Central, « The Non-Canonical Cabinet », Gary Illyes, de Google, a expliqué que, selon la RFC 9309, robots.txt sert à définir les URL qu’un robot d’exploration est autorisé à récupérer, mais ne détermine pas ce qu’il advient des données une fois récupérées. Pour bloquer un robot d’exploration IA en particulier, il faut désigner explicitement son User-Agent.
« Interdire l’accès » et « empêcher l’entraînement » sont deux choses différentes
« Il suffit d’indiquer dans robots.txt que l’entraînement de l’IA est interdit pour être tranquille. » Cette idée semble se répandre peu à peu. Pourtant, d’après les explications d’Illyes, les choses ne sont pas si simples. robots.txt ressemble à un panneau à l’entrée d’un site qui indique : « Vous pouvez entrer par cette porte. » En revanche, ce panneau ne régit pas la manière dont les visiteurs utilisent les informations qu’ils emportent.
Illyes a présenté robots.txt, défini par la RFC 9309, comme un « protocole permettant d’exprimer des préférences en matière d’accès », précisant qu’il ne permet pas de dicter la manière dont les systèmes utilisent les données après leur exploration. La question posée dans la vidéo était de savoir s’il est possible d’autoriser l’exploration par l’IA tout en empêchant l’utilisation des mêmes informations pour entraîner des modèles d’IA générative. La réponse est que robots.txt, à lui seul, ne permet pas de faire cette distinction.
robots.txt ne régit que l’accès
La page de spécifications de Google recense quatre directives prises en charge par l’entreprise : User-Agent, Allow, Disallow et Sitemap. Toute autre ligne est considérée comme invalide et ignorée. Dans la vidéo, une directive fictive, « No-AI-Chicken-Training », était affichée à l’écran, mais les lignes de ce type, définies sur mesure, ne sont pas interprétées par l’analyseur de Google.
La section 2.2.4 de la RFC 9309 laisse à chaque robot d’exploration le soin de décider comment traiter les entrées qui ne relèvent pas de la spécification. Autrement dit, même si vous ajoutez une ligne personnalisée, son application dépend de l’autre partie. Elle peut être prise en compte ou non. En tout cas, il ne s’agit pas d’un « engagement garanti par la norme ».
La méthode la plus fiable en pratique consiste à désigner individuellement le User-Agent du robot d’exploration IA que l’on souhaite bloquer et à lui refuser l’accès au moyen de Disallow. Illyes a indiqué que, pour interdire l’accès à l’ensemble du site, il faut préciser explicitement le jeton concerné.
Google-Extended, un mécanisme de contrôle propre à Google
Quelle est alors la place de Google-Extended, utilisé pour les services d’IA de Google ? Il s’agit d’un jeton robots.txt qui ne possède pas de User-Agent distinct : Google utilise ses robots d’exploration existants pour parcourir les sites. Dans la liste des robots d’exploration de l’entreprise, ce jeton est présenté comme servant au « contrôle ».
Il permet de gérer l’utilisation des contenus récupérés par Google pour entraîner de futurs modèles Gemini, ainsi que pour le grounding dans Gemini Apps ou dans Grounding with Google Search sur Vertex AI (la consultation d’informations venant étayer une réponse). Il n’a pas d’incidence sur l’inclusion dans Google Search et ne constitue pas un signal de classement.
Il faut retenir que cette notion de « contrôle de l’utilisation » ne vient pas de la RFC 9309, mais de la documentation que Google a définie pour ses propres produits. Elle ne s’applique pas automatiquement aux autres IA en tant que règle commune de robots.txt. Il est plus juste de la considérer comme un bouton de contrôle réservé à Google.
La proposition de normalisation sur les usages reste à l’état de brouillon
Peut-on distinguer les autorisations d’exploration des préférences concernant l’utilisation des contenus récupérés ? Des travaux sont en cours pour répondre à cette question. Illyes rédige avec Martin Thomson, de Mozilla, un Internet-Draft de l’IETF. La version en vigueur, datée du 19 août, propose de mettre à jour la RFC 9309 en ajoutant à robots.txt une directive « Content-Usage » et un en-tête HTTP correspondant.
La répartition des rôles est claire. Allow et Disallow continuent de déterminer quelles URL peuvent être explorées, tandis que Content-Usage indique comment l’éditeur souhaite que les contenus récupérés soient utilisés. Cette préférence ne concerne que les chemins dont l’exploration est autorisée. Dans l’exemple du brouillon, une entrée Content-Usage, « train-ai=n », est ajoutée à un fichier robots.txt qui autorise l’exploration.
Toutefois, le document en est encore au stade du groupe de travail. D’après les archives de l’IETF Datatracker, il n’a pas encore été soumis à l’examen de l’IESG (le groupe chargé de la gestion de la normalisation des normes Internet), et la soumission par le groupe de travail était prévue pour août 2026. Le libellé « train-ai » apparaît dans un autre brouillon consacré au vocabulaire, daté du 14 septembre, mais celui-ci précise qu’il ne reflète pas un consensus au sein du groupe de travail. Le brouillon actuel expire le 20 février 2027 et sera remplacé si une nouvelle version est publiée d’ici là.
En somme, la manière normalisée d’exprimer des préférences concernant l’utilisation des contenus pour l’entraînement, indépendamment de l’autorisation d’exploration, n’existe pour l’instant qu’à l’état de brouillon. Il est trop tôt pour la considérer comme une règle commune déjà applicable.
Pour les URL en japonais, l’encodage en pourcentage est plus sûr
Cet épisode abordait aussi des sujets pratiques sans rapport avec l’IA. Cherry Prommawin, de Google, conseille d’« utiliser une forme encodée » pour les chemins inscrits dans robots.txt lorsqu’ils contiennent des caractères d’autres langues ou des émojis. Le parseur de Google peut encoder et traiter les caractères bruts, mais d’autres robots d’exploration, notamment les plus anciens, risquent de s’y perdre.
Dans la vidéo, l’exemple avec des émojis écrits tels quels était accompagné de la mention « fonctionne avec Google, mais risque de ne pas fonctionner ailleurs », tandis que l’exemple encodé en pourcentage était présenté comme une « méthode sûre et standard ». Selon la page de spécifications de Google, son parseur traite de la même manière l’UTF-8 brut et l’encodage en pourcentage. La grammaire de la RFC 9309 autorise également les caractères UTF-8 dans les chemins, mais rien ne garantit que les robots d’exploration d’autres entreprises les interprètent de la même façon.
De nombreux sites utilisent des noms de répertoires ou de pages en japonais dans leurs URL. Si vous souhaitez contrôler individuellement les robots d’exploration IA, mieux vaut aussi prêter attention à la manière dont les chemins sont écrits.
Ce que les exploitants de sites peuvent faire dès maintenant
En résumé, les mesures à prendre pour limiter l’utilisation par l’IA tout en préservant la visibilité dans la recherche Google varient selon le robot ou le produit concerné. Pour certains robots d’exploration IA, une directive Disallow associée à un user-agent précis permet de bloquer l’accès aux pages. Pour Gemini, Google-Extended est le mécanisme de contrôle officiellement proposé par Google ; il couvre à la fois l’entraînement et l’ancrage.
En revanche, il n’existe encore, dans un projet de norme, qu’une syntaxe commune permettant de refuser l’entraînement tout en autorisant l’exploration. On ne peut pas tout régler d’une seule ligne dans robots.txt : pour l’instant, il reste indispensable de consulter la documentation officielle de chaque robot d’exploration. Si la normalisation progresse, il sera peut-être un jour possible de distinguer la gestion des accès de l’expression des préférences d’utilisation.
La description de la vidéo indique que le prochain épisode de la série portera sur le code d’état 404.






コメント